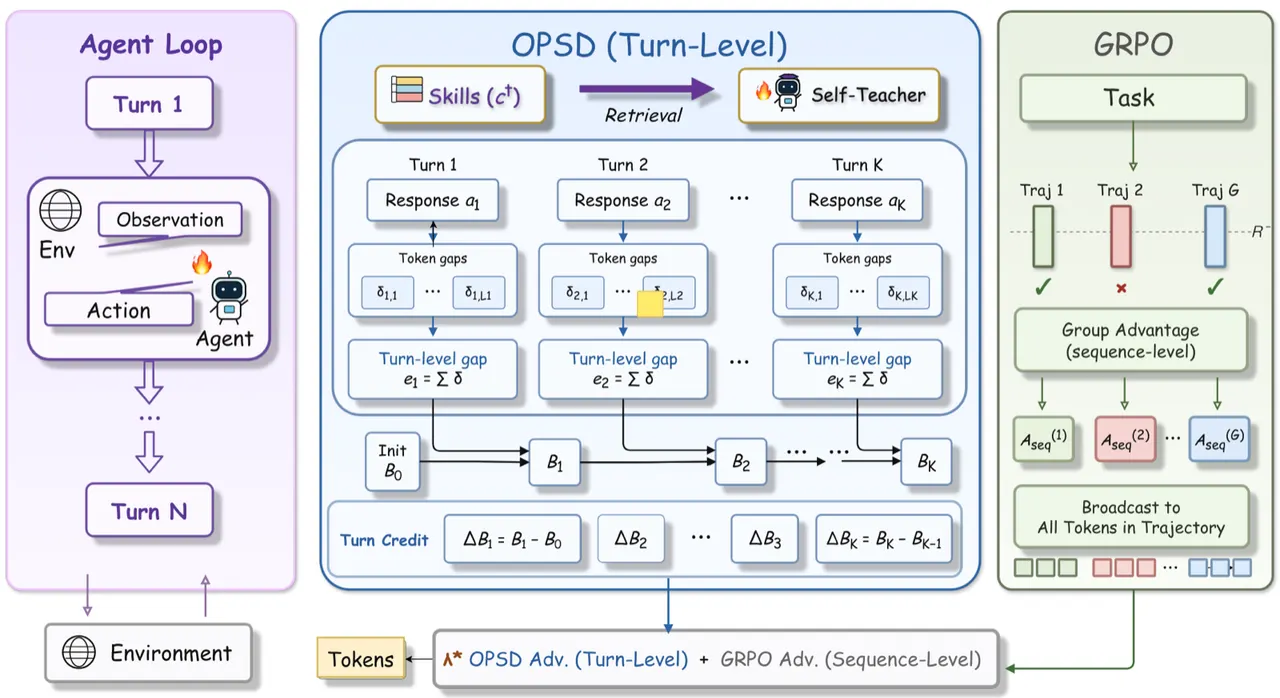
여러 턴에 걸친 에이전트 작업에서 성패를 가른 결정을 어떻게 찾아낼 것인가. 8월 6일 공개된 AgentOPSD는 별도 크리틱 없이 턴 단위 기여도를 재귀적으로 추정합니다.
2026년 8월 6일 arXiv에 공개된 AgentOPSD는 에이전트 강화학습의 오래된 문제 하나를 다룹니다. 여러 턴에 걸친 작업에서 결과를 실제로 가른 결정이 무엇이었는지 찾아내는 문제입니다.
문제
검증 가능한 보상으로 강화학습을 돌리면 궤적 전체에 대한 이득 추정치를 얻습니다. 작업이 성공했는지 실패했는지는 알 수 있다는 뜻입니다.
문제는 긴 다중 턴 작업에서 성패를 가르는 결정은 몇 개뿐이라는 점입니다. 스무 번의 도구 호출 중 열일곱 번은 평범했고 세 번이 결정적이었다면, 궤적 전체에 균일하게 보상을 나눠주는 방식은 그 세 번을 찾아내지 못합니다.
논문의 표현을 빌리면, 기존 방식은 "결과를 결정하는 소수의 결정적 선택에 기여도를 부여하는 데 자주 실패"합니다.
접근
AgentOPSD는 크리틱 없이 턴 단위 기여도를 재귀적으로 추정합니다. 흐름은 다음과 같습니다.
| 단계 | 내용 |
|---|---|
| 증거 수집 | 교사와 학생 모델의 토큰 단위 로그 확률 차이를 턴 단위 증거로 모읍니다 |
| 신념 갱신 | 로그 오즈 공간에서 베이지안 신념 상태를 재귀적으로 갱신합니다 |
| 결정적 턴 식별 | 연속한 상태 사이의 신념 변화량이 큰 지점을 결정적 턴으로 봅니다 |
핵심은 마지막 줄입니다. 어떤 턴을 지나면서 성공 확률에 대한 믿음이 크게 흔들렸다면, 그 턴이 결정적이었다고 보는 것입니다.
실무에서 왜 중요한가
이 논문이 반가운 이유는 별도 크리틱 모델도, 추가 롤아웃도 필요 없다는 점입니다. 표준 정책 최적화와 그대로 호환된다고 밝히고 있습니다.
기업 환경에서 에이전트를 학습시킬 때 가장 큰 비용은 데이터 수집입니다. 추가 롤아웃 없이 기존 궤적에서 더 촘촘한 신호를 뽑아낸다면 같은 데이터로 더 나은 학습이 가능합니다.
한 가지 덧붙이면, 결정적 턴을 식별하는 능력은 학습 밖에서도 쓸 데가 있습니다. 에이전트가 실패했을 때 어느 지점에서 어긋났는지 사람이 확인해야 하는데, 스무 턴짜리 로그를 처음부터 읽는 것과 세 개의 후보 지점을 먼저 보는 것은 검토 비용이 다릅니다.
코텍시스 창업자로 AX 컨설팅과 기업 AI 교육, AI 에이전트 개발을 직접 수행합니다.
코텍시스 AI 인사이트 최신 논문 리뷰
검색 전에 질문부터 고쳐 쓰는 RAG
사용자 질문을 검색에 맞게 고쳐 쓰는 재작성 단계를 검색 앞에 추가하면 RAG 성능이 일관되게 개선됩니다. Rewrite-Retrieve-Read 프레임워크를 제안한 이 논문은 소형 재작성 모델을 LLM 리더의 피드백으로 강화학습해, 검색기와 생성기를 그대로 둔 채 QA 성능을 끌어올렸습니다.
토큰당 KV 캐시 크기로 계산하는 온프레미스 동시 처리량
vLLM 논문이 보인 것처럼 LLM 서빙의 동시 처리량은 GPU 메모리에서 가중치를 빼고 남은 공간을 토큰당 KV 캐시 크기로 나눈 값이 정합니다. Qwen3-8B와 Qwen3-32B의 config.json으로 계산하면 80GiB GPU 1장에서 8,192토큰 세션 상한이 57개와 9개로, 가중치 크기 차이 4배보다 큰 6배 이상의 차이가 납니다.
초안 모델로 생성 속도를 높이는 추측 디코딩
Google Research의 추측 디코딩은 작은 초안 모델이 제안한 토큰을 큰 모델이 한 번에 검증하고 확률적 수락 규칙으로 출력 분포를 그대로 유지해, T5-XXL의 생성 속도를 재학습 없이 2배에서 3배 높였습니다. M3 Pro 맥북의 Gemma 4 12B 단일 사용자 실측에서는 초안을 켜면 같은 출력을 유지한 채 생성 속도가 15.3 tok/s에서 33.4 tok/s로 2.18배 올랐습니다.