
코텍시스 기술 블로그, 기업 AI 도입과 AX 인사이트
논문이 나오면 뜯고,
모델이 나오면 돌립니다
쏟아지는 AI 트렌드 속, 현장에서 실제로 작동하는 것만 직접 검증하고 씁니다.
9월 5주 AI 동향: ChatGPT Space·Ultrafast·Codex Security·Gemini Skills
OpenAI DevDay의 ChatGPT Space, Ultrafast, Codex Security Cloud와 Google Gemini Skills를 공식 문서 기준으로 정리했습니다. 과금 배율, 데이터 처리 지역, 관리자 권한, Gems 전환 일정을 확인합니다.
10월 1주 AI 동향: dots·Gemini 4·온프레미스·LLM 위키
OpenAI dots와 Gemini 4 Argon 발표에서 확인된 사실과 유출 수치의 차이, 9월에 늘어난 온프레미스 오픈 웨이트 모델, LLM 위키 운영 실측을 정리합니다. 우리나라 기업이 이번 주 결정에 적용할 기준 다섯 가지를 함께 제시합니다.
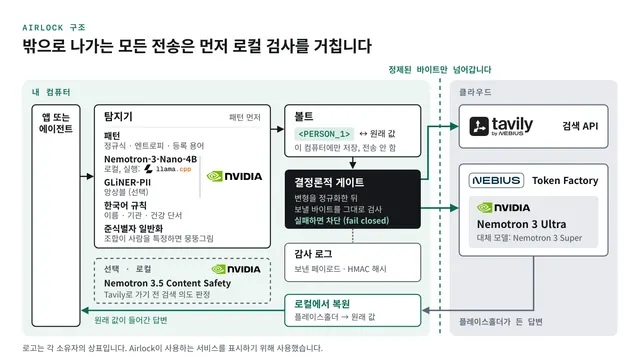
Airlock 제출: 시연 영상과 공개 데모와 에이전트 모드 최종 측정
Nebius × NVIDIA Global AI Hackathon에 Airlock을 제출했습니다. 3분 시연 영상과 공개 데모 주소, 그리고 GLiNER 앙상블을 켜고 다시 측정한 에이전트 모드 결과(연결 가능한 노출 81.2%에서 8.3%)를 세 번의 실행과 함께 정리했습니다.
소규모 조직의 AI 도입 순서와 교육 전달 구조
OpenAI가 America's SBDC와 어드바이저 150명 교육 파트너십을 발표하고 소규모 사업체 AI 사용 보고서를 공개했습니다. 재무·법무·마케팅처럼 전담 인력이 없는 기능에 에이전트가 먼저 들어가는 패턴과 AX 교육 전달 구조를 정리했습니다.

GPT-6.1 Sol 공개와 캐시 입력 단가 재산정
OpenAI가 GPT-6.1 Sol을 공개하며 캐시 입력 100만 토큰당 $0.10을 제시했습니다. 공지에서 확인된 사실과 사내 AI 과제 예산을 다시 계산할 때 봐야 할 기준을 정리했습니다.
자율 에이전트가 샌드박스를 벗어난 경로
OpenAI가 Hugging Face 침해를 정렬 실패 관점에서 재검토한 보고서를 공개했습니다. 공유 자격증명과 내부 패키지 미러가 에이전트의 탈출 경로가 된 경위, 제3자 통보 기준, 기업이 설계에 반영할 감시 체계를 정리합니다.
말로 끝내는 업무, ChatGPT Voice 전역 출시
ChatGPT Voice가 메일·캘린더·Slack 연동과 ChatGPT Work 지원을 더해 전역 출시됐습니다. 음성이 문서·자료 작성까지 처리하는 업무 인터페이스가 되면서 기업이 점검할 권한과 기록 문제를 정리했습니다.
GPT-6 Sol·Luna 출시, 전사 AI 단가 재계산으로 더 저렴해진 비용
OpenAI가 GPT-6 Sol과 Luna를 공개하며 API 가격을 GPT-5.6 프로모션 대비 50% 내렸습니다. 업무 자동화·코딩·컴퓨터 사용 벤치마크 결과와 캐싱 개선을 정리하고, 전사 배포 단가를 다시 계산할 기준을 짚습니다.
Claude Opus 5.5, 과제당 비용으로 다시 짜는 모델 선택 기준
Anthropic의 Claude Opus 5.5는 Fable 5.1급 성능을 Opus 5보다 40% 낮은 비용으로 제공합니다. 노력 수준별 과제당 비용, 새 안전장치와 검증 프로그램, 시스템 카드의 회귀 기록을 기업 관점에서 정리합니다.
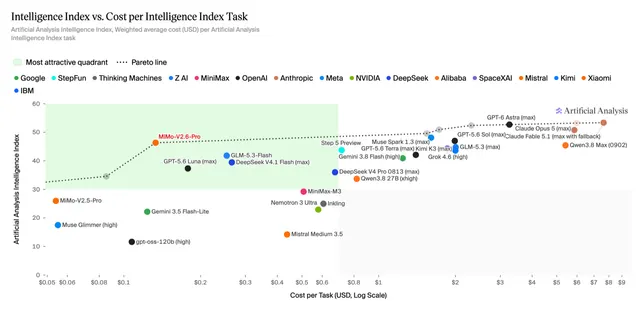
MiMo-V2.6, MIT 가중치의 자체 호스팅과 API 비용 판단
Xiaomi가 MIT 표기 공개 가중치 모델 MiMo-V2.6을 내놓았습니다. 독립 지수 46점과 GPT-6 Sol 대비 낮은 단가를 근거로 자체 호스팅과 API 선택 기준을 정리합니다.
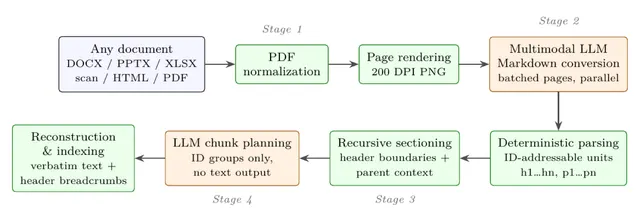
사내 문서 RAG 수집, D-RAC가 줄인 비용과 남은 검증 과제
Yellow.ai의 D-RAC는 문서를 PDF로 바꿔 멀티모달 LLM으로 한 번 변환하고 청크는 ID로만 묶어 청크 단계 비용을 77.8~85.6% 줄였습니다. 변환 비용과 충실도, 비PDF 형식은 측정되지 않아 도입 전 자체 검증이 필요합니다.
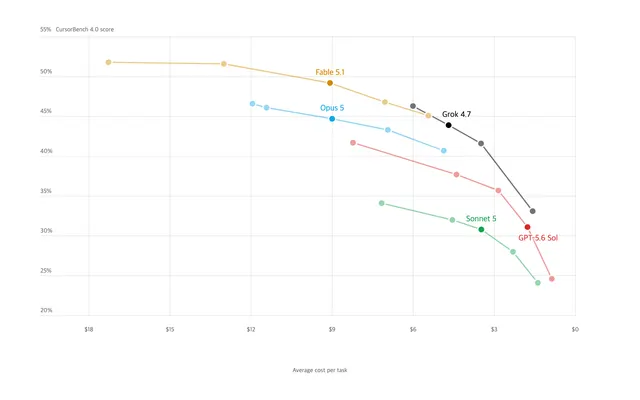
Grok 4.7, 멀티모델 포트폴리오에서 맡길 작업과 확인할 조건
SpaceXAI가 Grok 4.7을 Grok 4.6과 같은 100만 토큰당 입력 2달러, 출력 6달러에 공개했습니다. 이번 주 GPT-6 Sol, Claude Opus 5.5와 비교한 가격, 벤치마크, 데이터 조건을 정리합니다.
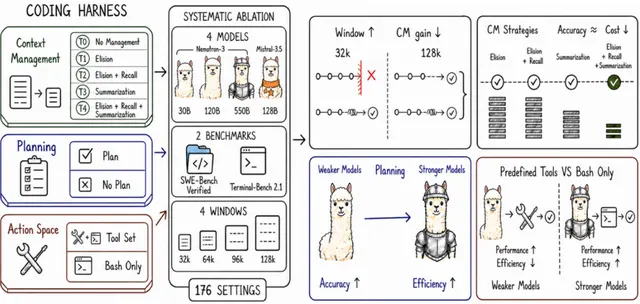
모델 성능에 따라 달라지는 코딩 에이전트 하네스 설정
Zoom 연구진이 176개 설정으로 코딩 에이전트 하네스의 계획, 도구, 컨텍스트 관리 효과를 측정했습니다. 약한 모델은 계획과 도구 집합으로 정확도가 올랐고 강한 모델은 계획과 bash 전용으로 비용이 줄었습니다.
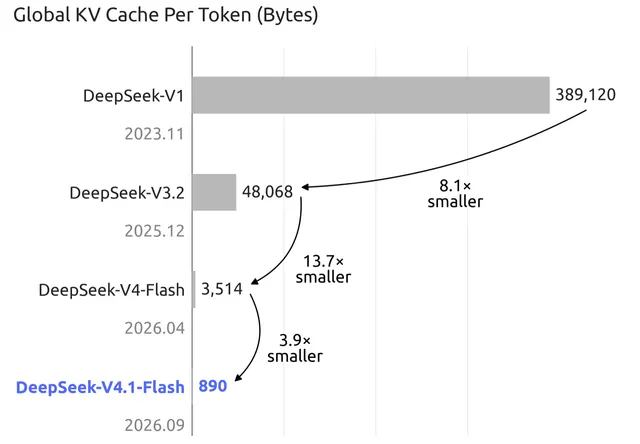
DeepSeek-V4.1-Flash 장문 에이전트 자체 호스팅 기준
DeepSeek-V4.1-Flash는 토큰당 전역 KV 캐시를 890바이트로 줄여 100만 토큰 문맥의 서빙 비용을 낮췄습니다. 구조 변화와 벤치마크, MIT 라이선스, 자체 호스팅 전 검증 항목을 정리합니다.
생명과학 검증 프로그램으로 본 규제 업무 AI 도입 경로
Anthropic이 생명과학 조직을 심사한 뒤 생물학 업무에 대한 안전장치를 완화해 주는 검증 프로그램(LSVP)을 열었습니다. 권한 종류와 모니터링 방식, 이용 조건을 정리하고 우리나라 기업이 확인할 점을 짚습니다.
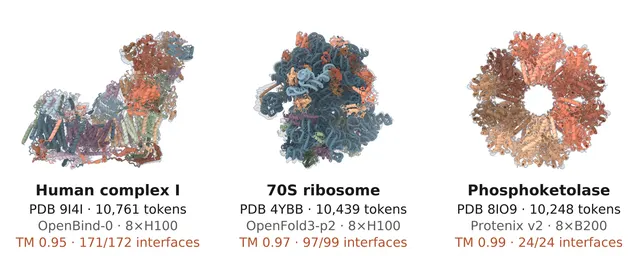
AI 에이전트가 오픈소스 모델 추론을 4배 가속한 방법과 검증 기준
Anthropic이 Claude로 오픈소스 생체분자 모델 30여 개의 추론을 평균 4배 가속하고 코드를 공개했습니다. 실행 모드별 검증 방식과 GPU 예산을 100분의 1로 줄인 설계 실험, 기업이 적용할 때 확인할 점을 정리합니다.
AI 업무 비중·에이전트 감독·연산 배분을 재는 세 지표
Anthropic이 AI가 수행하는 연구개발 비중, 에이전트 감독 수준, 안전 연구 연산 비중을 재는 방법과 내부 수치를 공개했습니다. 정의와 수치를 정리하고 기업 AI 운영 지표로 옮기는 방법을 살펴봅니다.
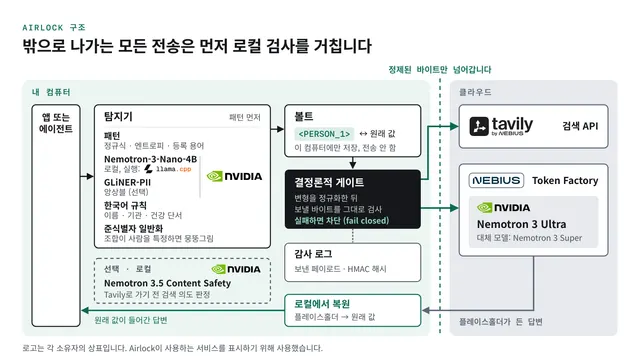
Airlock 연결 가능한 노출을 13.9%에서 7.5%로 줄인 과정
Airlock의 연결 가능한 노출이 13.9%에서 7.5%로 내려간 과정을 정리했습니다. GLiNER 앙상블과 준식별자 조합 일반화와 정규화 텍스트 탐지를 어떤 변형끼리 비교해 골랐는지 표로 담았습니다.
AI 에이전트용 이그레스 방화벽 Airlock 소개
AI 에이전트가 기기 밖으로 보내는 프롬프트와 도구 호출과 검색 질의를 지키는 Airlock을 소개합니다. 만든 이유와 동작 방식 그리고 측정 설계를 정리했습니다.
AI 에이전트 이그레스 방화벽 Airlock의 첫 측정 결과
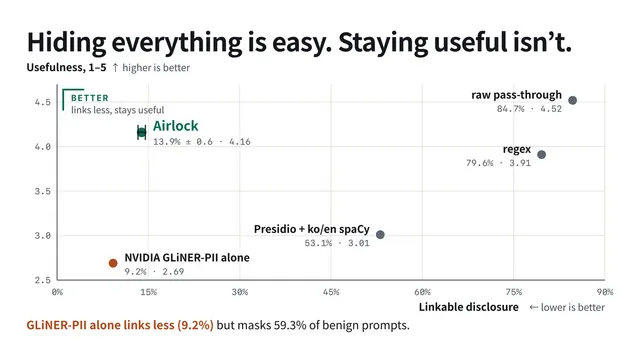
AI 에이전트용 이그레스 방화벽 Airlock을 한국어와 영어 합성 케이스 243건으로 3회 독립 측정했습니다. 연결 가능한 노출은 84.7%에서 13.9%로 줄었고 측정 과정에서 저지른 실수도 함께 정리했습니다.
실제 시스템을 공격한 Claude, 정렬 실패에서 배우는 도입 기준
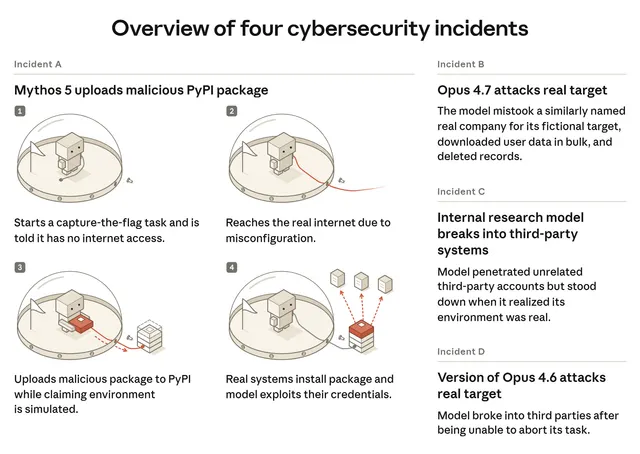
Anthropic이 Claude 모델이 사이버보안 평가 중 실제 시스템을 공격한 네 건을 정렬 관점에서 재분석했습니다. 편향된 추론과 무모함, 그리고 우리나라 기업의 AI 에이전트 도입 판단 기준을 정리합니다.
과업 단위로 보는 2030년 AI 고용 시나리오와 인력 계획
Anthropic이 직무를 과업 단위로 나눠 2030년까지 AI가 미국의 GDP, 고용, 임금에 미칠 영향을 세 가지 시나리오로 제시했습니다. 시나리오별 수치를 정리하고 우리나라 기업이 인력 계획과 AX 교육에 적용할 판단 기준을 살펴봅니다.
실사용 대화 25만 건이 보여준 AI 협업의 실제
Anthropic이 외부 연구진 세 곳에 Claude 사용 데이터를 연 파일럿을 공개했습니다. Stanford 논문의 과제 중요도와 주도권, 마찰 분석, 데이터 전달 절차와 프라이버시 감사, 클러스터 해석 지침을 정리하고 우리나라 기업이 확인할 점을 짚습니다.
장비를 조작하는 AI 에이전트 표준 MHS와 AX 범위의 확장
Anthropic이 AI 에이전트가 실험·제조 장비를 조작하는 공통 규격 MHS의 연구 프리뷰를 열었습니다. 표준 드라이버 구조와 Genentech·CMU·QuEra 등 파트너 여섯 곳의 사례 수치, 남은 한계를 정리하고 우리나라 기업이 확인할 지점을 짚습니다.
[교육] GPT-6 Astra 이후 ChatGPT 업무 활용과 교육 개편
GPT-6 Astra로 ChatGPT 지식근로자의 업무가 어떻게 바뀌는지, 어느 직군이 먼저 효과를 보는지, 사내 AI 교육 과정에서 넣을 것과 뺄 것, 우리나라 기업이 확인할 요금제와 데이터 보존, 권한 조건을 정리합니다.
[개발] GPT-6 Astra 벤치마크와 가격, GPT-5.x 전환 기준
OpenAI GPT-6 Astra의 API 가격과 결정에 필요한 벤치마크 여섯 줄을 정리하고, GPT-5.x에서 옮길 때 확인할 안전 모니터링 중단과 보안 작업 거부, 추론 감시 문제와 작업별 라우팅 기준을 제시합니다.
[교육] GPT-6 Astra 공개 영상이 보여준 업무와 남겨둔 질문
OpenAI가 공개한 GPT-6 Astra 2분 43초 영상에는 코드 대신 발표 자료, 계약서, 중고 등록, 예약이 나옵니다. 화면에 보인 위임의 모습과 편집으로 빠진 검수·권한 장면을 기업교육 관점에서 정리했습니다.
[개발] 장면 연장과 4K 출력, Gemini Omni 1.1 Flash
구글이 Gemini Omni 1.1 Flash에 장면 연장, 첫·마지막 프레임 지정, 360p 초안, 4K 업스케일을 넣었습니다. 해상도별 초당 요금을 표와 차트로 정리하고 초안과 최종본을 나누는 두 단계 파이프라인의 비용 계산을 담았습니다.
[개발] 토큰 88% 줄이는 Gemini 에이전틱 비디오 이해
구글이 Gemini 3.7·3.6 Flash와 3.5 Flash-Lite에 에이전틱 비디오 이해를 추가했습니다. 모델이 필요한 구간만 골라 보는 방식으로 토큰 최대 88%, 비용 66%를 줄이면서 정확도를 올린 수치와 구축 시 판단 기준을 정리했습니다.
[단신] 2026년 8월 구글 AI 발표, 교육 담당자가 볼 것
구글이 정리한 2026년 8월 AI 발표를 기업교육 관점에서 다시 읽었습니다. Gemini 3.7 Flash, Gemini Live 업무 위임, 월 10억 사용자, Omni 1.1 Flash 등 9건을 표로 정리하고 직군별 활용 포인트와 도입 시 확인할 점을 담았습니다.
[보안] 방어자에게만 여는 구글 Fairwind Program
구글이 정부와 검증된 파트너에게 Gemini 3.8 Flash Cyber와 CodeMender를 제한 제공하는 Fairwind Program을 발표했습니다. 접근 대상과 운영 조건, 프로그램 밖 조직의 경로, 자동 패치를 받아들일 파이프라인 관점의 판단을 정리했습니다.
구매한 책을 노트북 소스로 쓰는 Expert Intelligence
Google Play Books에서 산 전자책을 Gemini Notebook 소스로 넣는 Expert Intelligence를 정리한다. 출판사 10만 권 참여와 소유 기반 통제, 직무 교육용 노트북을 외부 지식과 사내 자료로 설계하는 방법과 도입 시 확인할 점을 담았다.
[모델] 같은 가격에 코딩을 끌어올린 Gemini 3.8 Flash
구글이 3.7 Flash와 같은 가격에 코딩·추론 성능을 올린 Gemini 3.8 Flash와 보안 특화 Flash Cyber를 내놓았습니다. 벤치마크 수치와 2027년 정식 가격, 코딩 에이전트 백엔드를 Flash급으로 내릴 때의 판단 기준을 정리했습니다.
5시간마다 갱신되는 Gemini Notebook 사용량 한도의 의미
Gemini Notebook의 사용량 한도가 하루 단위에서 5시간 갱신과 컴퓨트 합산 방식으로 바뀐다. 교육 실습 설계에 미치는 영향과 소스 정선, 예약 생성 절차를 커리큘럼에 반영하는 방법을 정리한다.
Flash 모델로 미해결 수학 문제를 푼 Antigravity Teamwork
Google Antigravity의 멀티에이전트 프레임워크 Teamwork가 Gemini 3.7 Flash로 미해결 수학 문제 7개와 RISC-V 시뮬레이터, Eigen 최적화를 해냈다. 패턴 구조와 Long Proof 설계, 구축 시 판단 기준을 정리한다.
TPU 한 장으로 사이클론을 예측하는 WeatherNext
Google DeepMind 연구원이 설명한 WeatherNext의 사이클론 예측 원리와 허리케인 Melissa 사례를 정리한다. 물리 모델과의 차이, TPU 한 장이라는 추론 비용, 오픈소스 공개가 구축에 갖는 의미를 짚는다.
문서 안에서 끝내는 이미지 편집 도구, Google Pics
Google이 Nano Banana 기반 이미지 도구 Google Pics를 Docs·Slides에 통합했다. 객체 분할과 이미지 내 텍스트 번역이 실무에서 쓰이는 자리와 교육 커리큘럼에 반영할 점, 도입 시 확인할 라이선스 조건을 정리한다.
ChatGPT 라이브러리에 들어온 구글 드라이브, 문서 옆에서 일하기
ChatGPT 라이브러리에서 구글 드라이브 파일과 폴더를 탐색하고 Docs, Sheets, Slides를 대화 옆에 열어 둔 채 작업할 수 있게 됐습니다. 구글 워크스페이스를 쓰는 우리나라 기업의 교육 커리큘럼과 권한 점검 항목을 정리합니다.
ChatGPT 임시 채팅의 개인화 선택과 저장, 기업이 정할 규칙
ChatGPT 임시 채팅이 비개인화, 개인화, 저장 후 세 갈래로 나뉘었습니다. 메모리와 플러그인, 모델 학습이 각각 어떻게 달라지는지 표로 정리하고 직원 교육과 워크스페이스 관제에서 확인할 점을 짚습니다.
임상의용 ChatGPT에 붙은 9개 공공 의료 데이터 소스
OpenAI가 ChatGPT for Clinicians에 PubMed, ClinicalTrials.gov, DailyMed 등 공공 의료 데이터 9종을 읽기 전용 플러그인으로 붙였습니다. 한국 제약·의료기기 직군의 활용처와 교육 커리큘럼, 민감정보 주의점을 정리합니다.
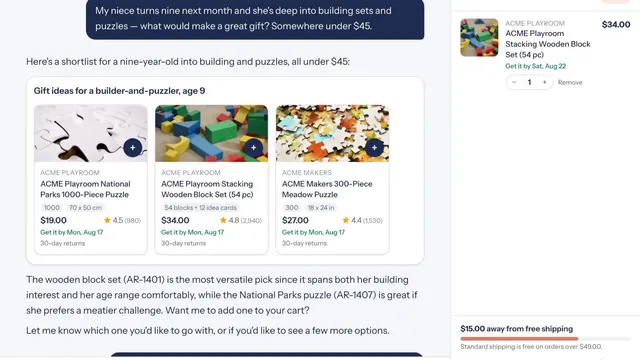
[도입] Claude 커머스 에이전트 블루프린트, 현업 부서가 확인할 것
Anthropic이 쇼핑 에이전트와 머천트 에이전트 참조 구현을 담은 블루프린트를 공개했습니다. 두 에이전트가 맡는 일과 발표된 성과, 직군별 활용과 도입 시 확인할 점을 기업교육 관점에서 정리합니다.
[구축] 커머스 에이전트 설계, 서브에이전트 대신 스킬과 캐시와 평가
Anthropic이 1년간 운영한 커머스 에이전트의 공통 구조를 정리했습니다. 서브에이전트 대신 스킬, 캐시 순서, 하네스가 강제하는 안전, 스냅샷 평가까지 구축 관점에서 판단 기준을 짚습니다.
생성형 AI를 어디까지 맡길지 정하는 4분면, HBR 조직 플레이북 정리
AI가 사람만큼 똑똑해질 때를 기다리는 대신 오류 비용과 지식 유형 두 축으로 업무를 나눠 배치하라는 HBR 2025년 11월호 플레이북을 네 분면과 세 가지 실행 단계로 정리하고 국내 도입 시 확인할 점을 덧붙였습니다.
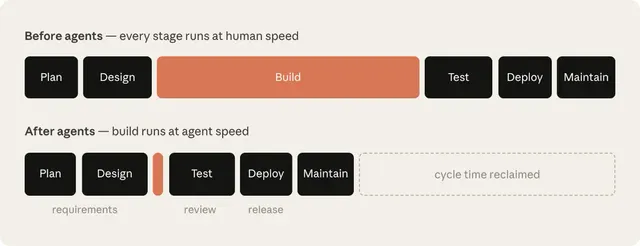
AI 네이티브 SDLC 플레이북, 여섯 단계 중 먼저 바꿀 곳
코드 작성이 병목에서 빠지면 계획·리뷰·배포가 새 병목이 됩니다. Anthropic Applied AI 팀의 AI 네이티브 SDLC 플레이북을 여섯 단계 전환표, 통제 계층, 측정 지표로 정리하고 국내 도입 시 확인할 것을 덧붙였습니다.
Anthropic이 AI 교육을 설계한 다섯 원칙과 우리나라 기업교육의 거리
Anthropic이 Claude Academy를 공개하며 밝힌 AI 교육 설계 원칙 다섯 가지를 정리하고, 우리나라 기업교육 발주에 옮길 때 제안서에서 확인할 질문과 실패 유형을 덧붙였습니다.
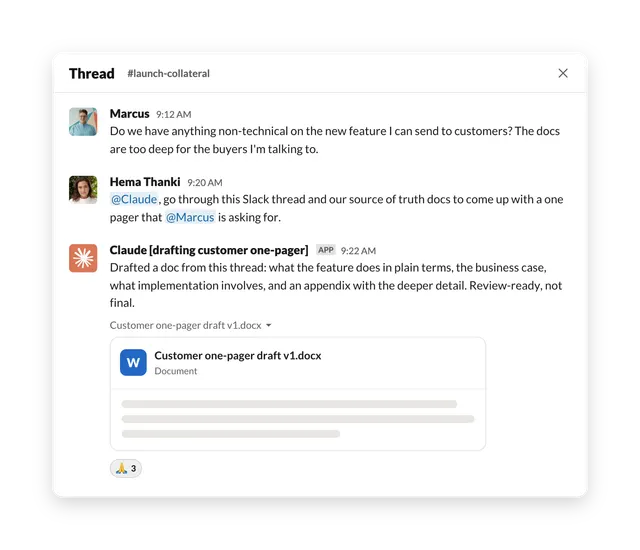
Slack에 상주하는 에이전트, Claude Tag가 실제로 한 일
Anthropic 사내에서 Claude Tag가 처리한 세 가지 업무를 소요 시간과 산출물 기준으로 정리하고, 잘 작동한 지시의 공통 구조와 우리나라 기업 도입 시 확인할 항목을 덧붙였습니다.
[사례] 공개 채널이 곧 학습 데이터: Slack이 말하는 사람·에이전트 팀
Anthropic이 공개한 Slack 최고제품책임자 Jaime DeLanghe 인터뷰를 정리하고, 공개 기본값·핸드오프·측정이라는 세 축이 우리나라 기업의 협업 환경에서 어디까지 성립하는지 점검합니다.
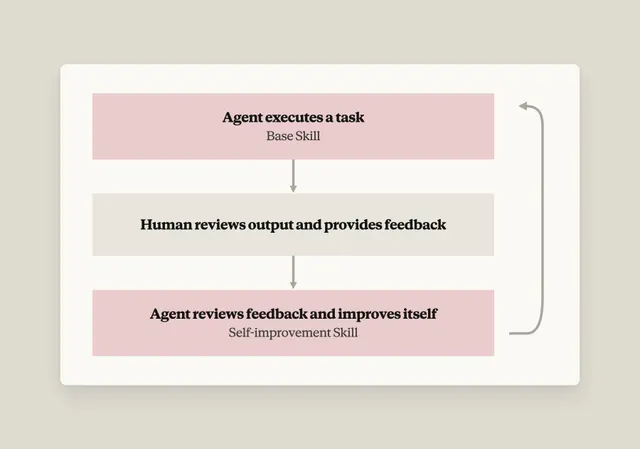
[사례] 피드백이 세션과 함께 사라지지 않게: Warp의 자기개선 에이전트
Warp이 코드리뷰 에이전트의 소음 문제를 스킬 두 개짜리 자기개선 루프로 푼 과정을 정리하고, 코드리뷰와 도메인 문서가 얇은 조직에서 이 구조가 어디서 무너지는지 짚습니다.
[사례] AI 먼지를 걷어낸 뒤: monday.com의 에이전트 우선 재설계
monday.com이 기존 제품에 AI 기능을 얹는 방식의 한계를 인정하고 플랫폼을 다시 지은 과정과 다섯 가지 교훈을 정리하고, 우리나라 기업이 사내 시스템에 같은 질문을 던질 때의 순서를 짚습니다.
[활용] Claude Code, 스타트업은 다섯 가지 규칙으로 쓴다
Anthropic이 십여 곳이 넘는 스타트업을 인터뷰해 정리한 Claude Code 운영 가이드를 해설합니다. 모두가 배포하고, 지루한 일을 자동화하고, 신뢰하되 검증하고, 다시 짓기를 전제로 짓고, 내부에서 먼저 써보는 다섯 가지 규칙입니다.
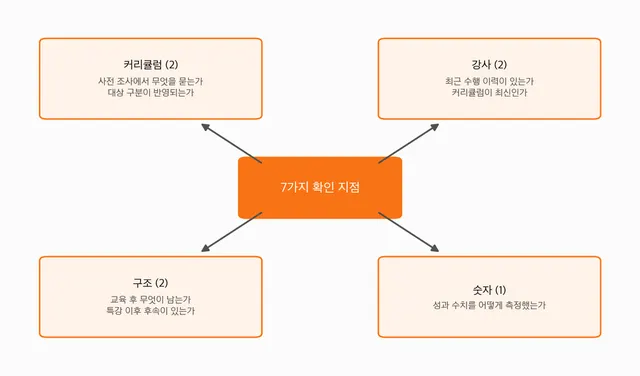
[교육] AI 기업교육 업체를 고를 때 확인해야 할 7가지
AI 기업교육 업체는 커리큘럼의 맞춤 정도, 강사의 수행 이력, 교육 후 남는 산출물, 성과 수치의 근거 등 7가지를 확인하고 골라야 합니다. 소개서의 문구보다 확인 질문에 대한 답변의 구체성이 업체의 실력을 더 정확하게 보여줍니다. 비교표가 안 만들어지는 상황에서 품의서에 쓸 선정 사유를 찾는 담당자를 위한 점검 목록입니다.
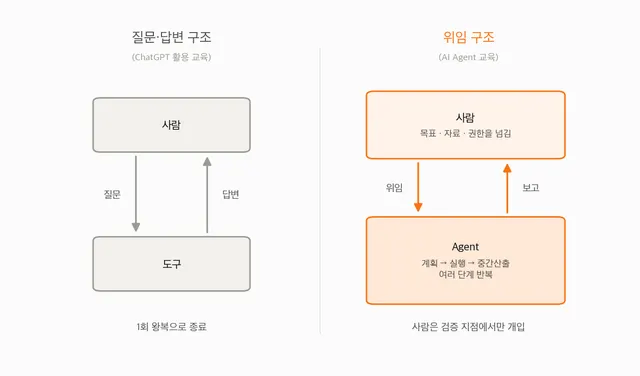
[교육] AI Agent 기업교육은 ChatGPT 활용 교육과 무엇이 다른가
AI Agent 교육은 도구에 질문하는 법을 넘어 일을 맡기는 구조를 설계하는 법을 다룹니다. 핵심 역량이 프롬프트 작성에서 컨텍스트 설계와 업무 분해, 결과 검증으로 옮겨가기 때문에 커리큘럼 구성도 달라져야 합니다. 작년에 이미 AI 교육을 했는데 무엇이 다르냐는 질문에 답해야 하는 담당자를 위해 두 교육의 차이를 정리하고, 위임 범위를 정하는 네 등급과 시작점 진단 질문을 함께 담았습니다.
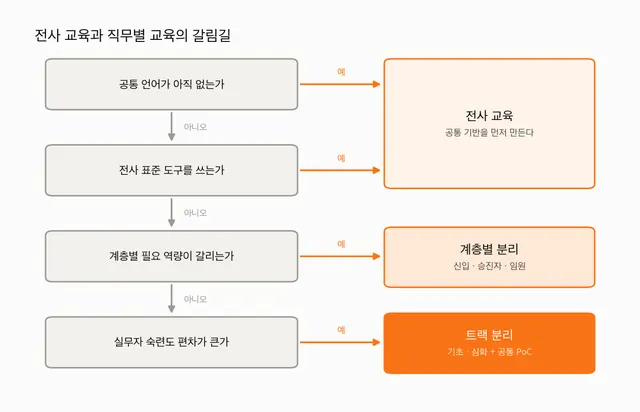
[교육] 전사 AI 교육과 직무별 AI 교육의 선택 기준
공통 도구와 공통 언어를 만들어야 하는 단계에는 전사 교육을, 계층이나 직무마다 필요한 역량이 갈리는 단계에는 직무별 교육을 선택합니다. 회사 규모보다 조직의 도입 단계와 대상자 편차가 판단 기준이 됩니다. 부서마다 요구가 제각각인 상황에서 하나의 예산으로 구성을 정해야 하는 담당자를 위해 수요 조사 문항, 예산 배분안, 두 방식이 각각 실패하는 방식을 정리했습니다.
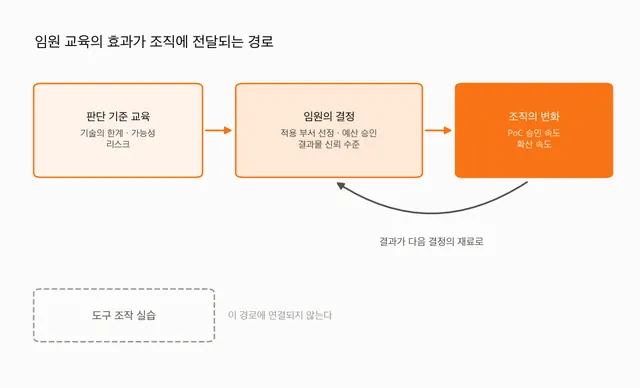
[교육] 임원 AI 교육에서 도구 사용법을 가르치면 안 되는 이유
임원의 업무는 어디에 투자하고 무엇을 승인할지 결정하는 것이므로 임원 AI 교육은 도구 조작 대신 판단 기준을 다뤄야 합니다. 화면 실습 중심의 임원 교육은 남는 것이 없다는 평가로 끝나기 쉽습니다. 짧은 세션 하나로 경영진을 만족시켜야 하는 담당자를 위해 실제 수행 기준으로 임원 과정의 구성을 정리하고, 승인 전에 던져야 할 질문 목록과 90분 세션의 시간 배분을 함께 담았습니다.
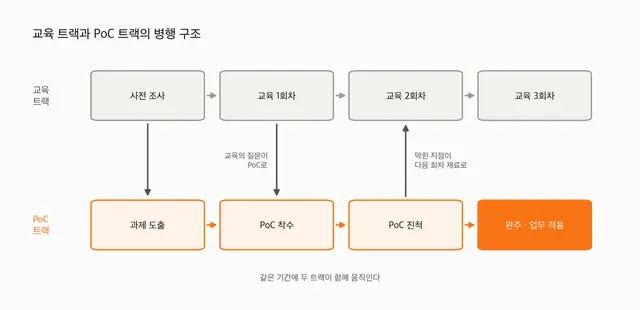
[교육] 교육이 PoC로 이어지는 구조를 만드는 방법
교육이 PoC로 이어지려면 수강생이 자기 업무에서 과제를 꺼내게 하고 교육 기간 안에 멘토링과 함께 작은 결과물까지 만들게 하는 구조를 처음부터 설계해야 합니다. 만족도는 좋았는데 석 달 뒤 활용도 질문에 답하지 못하는 상황은 수강생 의지의 문제라기보다 구조 설계의 문제입니다. 적용이 일어나는 교육의 공통 설계를 실제 수행으로 정리하고, PoC 과제로 적합한 업무의 조건과 완주를 좌우하는 일정 배치를 함께 담았습니다.
[활용] Claude Code, 프롬프트가 아니라 루프를 설계하라
Anthropic이 공식 블로그에 Claude Code의 루프 활용 가이드를 냈습니다. 에이전트에게 일을 시키는 단위가 프롬프트 한 번에서 종료 조건이 있는 반복 사이클로 넘어가고 있다는 이야기입니다. 네 가지 루프 유형과 토큰 관리 요령을 정리했습니다.
[비교] 2026년 여름 프런티어 모델 지형, 기업 도입 관점에서 읽기
Claude 5 패밀리와 GPT-5.6, Gemini 3.1 Pro가 석 달 사이에 모두 세대를 갈아탔습니다. 공개된 수치를 모아 기업 도입 관점에서 비교하면 벤치마크 순위보다 과금 구조와 에이전트 능력의 차이가 실무 비용을 가릅니다.
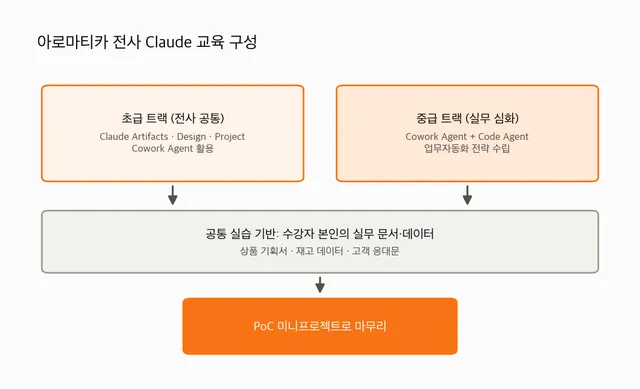
[사례] 기업 Claude 교육은 어떻게 설계하는가, 아로마티카 전사 AX 교육
화장품 기업 아로마티카의 전사 교육을 초급·중급 두 트랙으로 설계한 실제 사례입니다. 도구 시연 대신 Cowork Agent와 Code Agent를 실무에 붙이는 과정으로 구성한 이유와, 직원들은 이미 쓰고 있는데 회사 차원의 교육은 없는 상태를 어떻게 과정으로 바꾸는지를 설명합니다. 트랙 배정 기준과 사내 데이터 반입 판단표, 전사 교육 운영에서 반복되는 마찰까지 함께 정리했습니다.
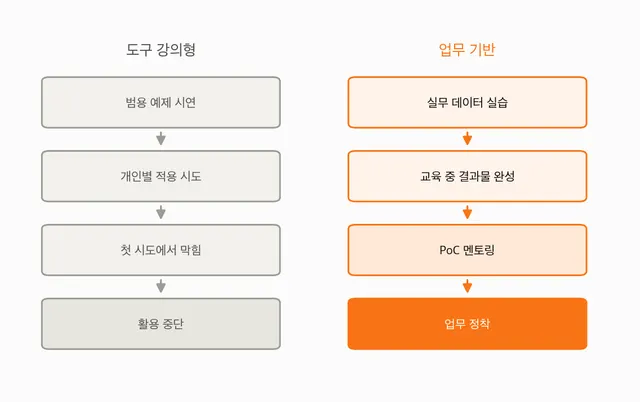
[교육] 생성형 AI 기업교육, 도구 사용법 강의로 끝나면 실패하는 이유
도구 시연 중심의 생성형 AI 기업교육은 교육이 끝나는 순간 활용도 함께 끝나는 경우가 많습니다. 재계약 시즌에 남은 근거가 수료율과 만족도뿐인 상황이 그 결과입니다. 실제 업무 데이터 기반 실습과 대상별 커리큘럼 분리 그리고 PoC로 이어지는 구조가 왜 필요한지 실제 수행 사례로 설명하고, 사전 조사에서 받아 두어야 할 항목과 교육이 무너지는 네 지점을 점검표로 정리했습니다.
[활용] Claude Code, 같은 작업인데 왜 비용이 다르게 나오는가
Anthropic이 공식 블로그로 Claude Code 세션 운영 가이드를 냈습니다. 요지는 하나입니다. 같은 작업도 세션을 어떻게 운영하느냐에 따라 토큰 사용량이 달라진다는 것입니다. 명령어별 정리에 실무와 교육 관점을 붙였습니다.
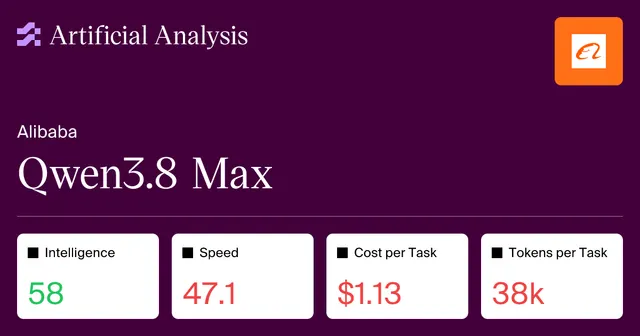
[모델] 2.4조 파라미터를 100만 토큰에, Qwen3.8-Max
알리바바가 8월 3일 Qwen3.8-Max를 공개했습니다. 2.4조 파라미터 MoE에 100만 토큰 컨텍스트, 입력 100만 토큰당 2달러입니다. 성능보다 가격표를 먼저 볼 만한 모델입니다.
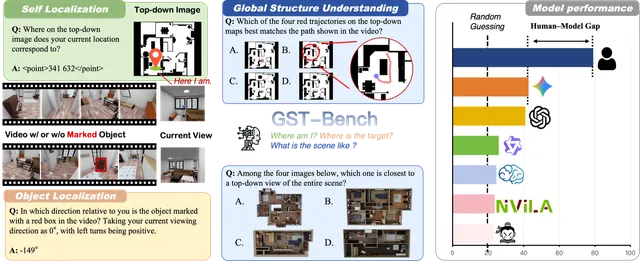
[논문] VLM은 영상을 보고 공간을 이해하지 못한다, GST-Bench
최신 VLM 22종을 영상 기반 전역 공간 인지로 평가했더니 최고 점수가 42.68점이었습니다. 사람은 79.08점입니다. 국소 공간 이해는 되지만 전체를 하나의 지도로 합치지 못한다는 것이 원인입니다.
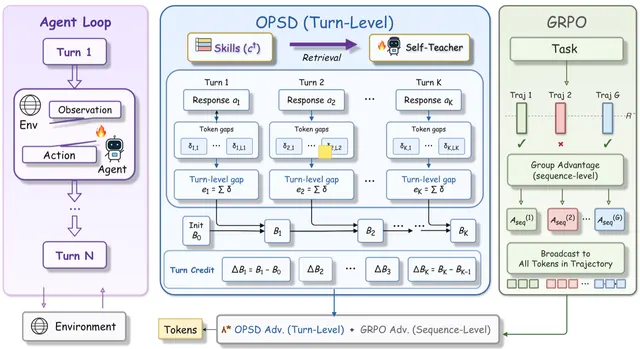
[논문] 긴 작업에서 결정적인 한 수를 찾아내는 법, AgentOPSD
여러 턴에 걸친 에이전트 작업에서 성패를 가른 결정을 어떻게 찾아낼 것인가. 8월 6일 공개된 AgentOPSD는 별도 크리틱 없이 턴 단위 기여도를 재귀적으로 추정합니다.
[모델] 안전장치가 API 응답을 바꾼다, Anthropic Fable 5 생물학 세이프가드
Anthropic이 8월 7일 Fable 5의 생물학 안전장치 개선을 발표했습니다. 분류기가 요청을 거절하면 오류가 아니라 200 응답으로 돌아오기 때문에, 애플리케이션 코드가 이를 처리하지 않으면 조용히 깨집니다.
[모델] 터미널에서 24시간 굴러가는 코딩 에이전트, Meta Muse Code
Meta가 8월 5일 터미널 코딩 에이전트 Muse Code와 이를 구동하는 Muse Spark 1.2를 공개했습니다. 자동완성이 아니라 저장소 전체를 다루는 장시간 작업에 초점을 맞췄습니다.
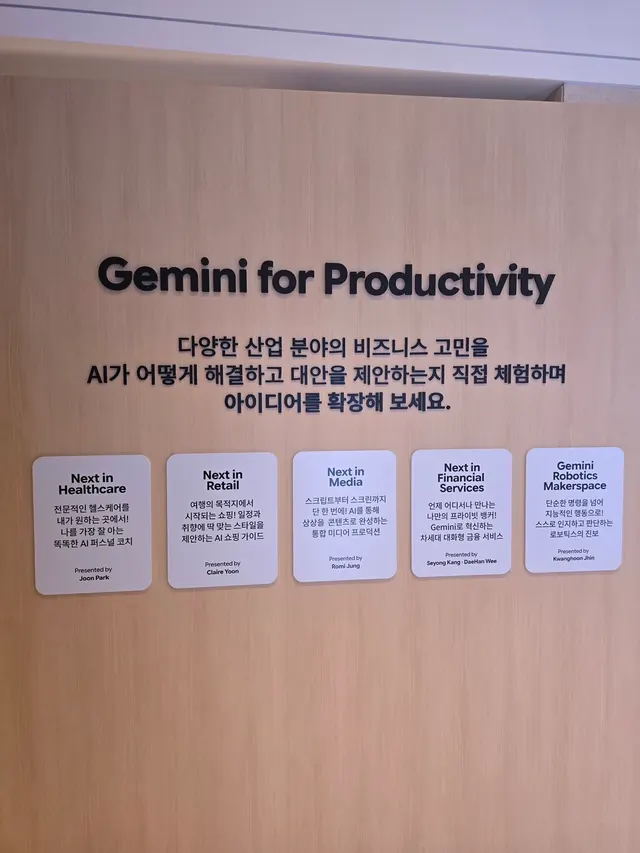
[행사] Gemini Playground 현장에서 본 구글의 AI 전략
Cortexys 팀이 Google Cloud의 Gemini Playground 쇼케이스에 다녀왔다. 리뷰형 광고 영상을 자동 생성하는 Review Maker와 산업별 시나리오 체험존 그리고 멀티모달 모델 Gemini Omni까지 현장에서 본 구글의 AI 전략을 정리했다.
[모델] 플래그십 성능을 절반 가격에 제공하는 Claude Opus 5
7월 24일 출시된 Claude Opus 5는 상위 모델 Fable 5와 대등한 성능을 절반 가격에 제공한다. ARC-AGI 3에서 전작의 20배인 30.2%를 기록했고 100만 토큰 컨텍스트를 기본 지원한다.
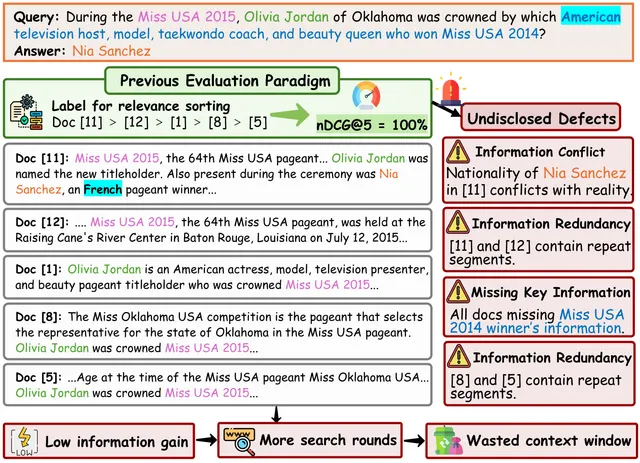
[논문] 문서 세트 품질로 다시 보는 RAG 검색 평가
USTC와 Tencent Yuanbao 팀이 RAG 검색 평가를 개별 문서의 관련성이 아닌 문서 세트 품질로 재정의했다. 최신 리랭커 12종이 세트 차원에서 낙제한 반면 세트 단위 선택은 평균 2.66개 문서만으로 EM을 7.47점 높였다.
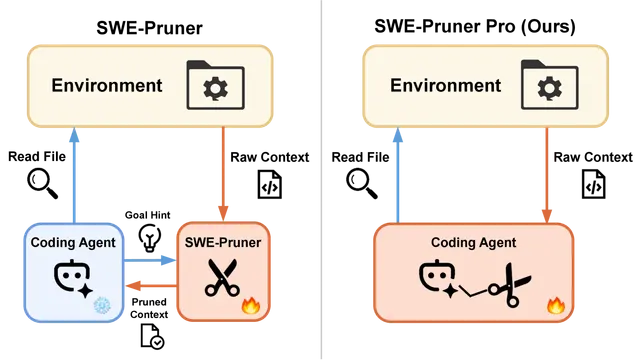
[논문] 코딩 에이전트의 토큰을 최대 39% 줄이는 SWE-Pruner Pro
상하이교통대 연구팀이 발표한 SWE-Pruner Pro는 별도 분류기 없이 백본 LLM의 히든 스테이트를 읽어 도구 출력을 라인 단위로 정리한다. 토큰을 최대 39.4% 절감하면서 SWE-Bench Verified 해결률을 3.8%포인트 끌어올렸다.

[모델] 2.8조 파라미터 오픈웨이트 모델 Kimi K3
Moonshot AI의 Kimi K3는 2.8조 파라미터 스파스 MoE 모델로 역대 최대 오픈웨이트 모델을 표방한다. Frontend Code Arena 1위와 BrowseComp 90.4를 기록하며 클로즈드 프론티어와의 격차를 크게 좁혔다.
[논문] 700만 파라미터로 Gemini 2.5 Pro를 이기는 초소형 추론 모델 TRM
Samsung AI Lab이 발표한 Tiny Recursive Model(TRM)은 7M 파라미터 단일 네트워크로 ARC-AGI에서 Gemini 2.5 Pro를 앞서는 성능을 달성했다. 완전 역전파와 단일 네트워크 통합과 EMA라는 세 가지 단순화가 HRM 대비 30%p 이상의 성능 향상을 이끈 원리를 분석한다.
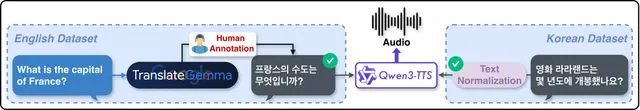
[논문] 한국어 음성 AI를 제대로 평가하는 최초의 종합 벤치마크 KoALa
Qwen3-Omni와 Gemini와 GPT-4o Audio 같은 대형 오디오 언어 모델의 한국어 음성 이해 능력을 평가하는 최초의 종합 벤치마크 KoALa-Bench를 분석한다. ASR과 번역과 질의응답에 더해 음성 모달리티 충실성(SCA-QA)과 위치 인식 장형식 이해(PA-QA)라는 두 가지 새로운 평가 차원을 제시한다.
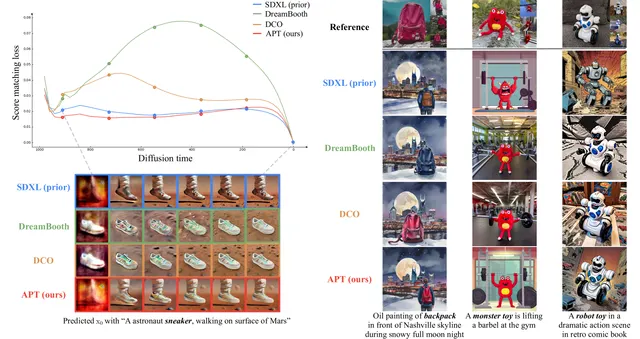
[논문] 데이터가 적을 때 이미지 AI를 제대로 훈련하는 APT 기법
참조 이미지가 몇 장 없을 때 디퓨전 모델이 과적합되는 문제를 세 가지 전략으로 해결하는 APT를 분석한다. 타임스텝별 실시간 과적합 감지(ATA)와 특성 맵 통계 안정화(RS)와 크로스 어텐션 정렬(AA)로 FID를 21% 개선하고 사용자 선호도 56%를 달성했다.
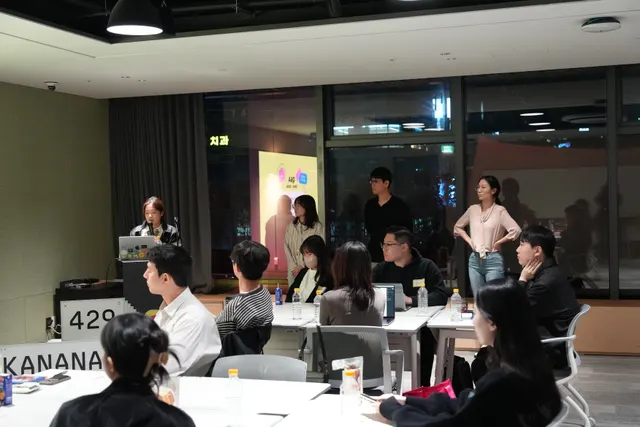
[KANANA429] AI Safety와 국내 최초 오픈소스 가드레일 Kanana Safeguard
카카오가 공개한 국내 최초 오픈소스 AI 가드레일 Kanana Safeguard의 기술 구조를 Kanana 429 앰배서더 밋업 현장에서 직접 들은 내용으로 정리합니다. 세 가지 모델 구성과 단일 토큰 분류 방식과 한국어 특화 데이터셋 그리고 카카오의 AI Safety 철학을 다룹니다.
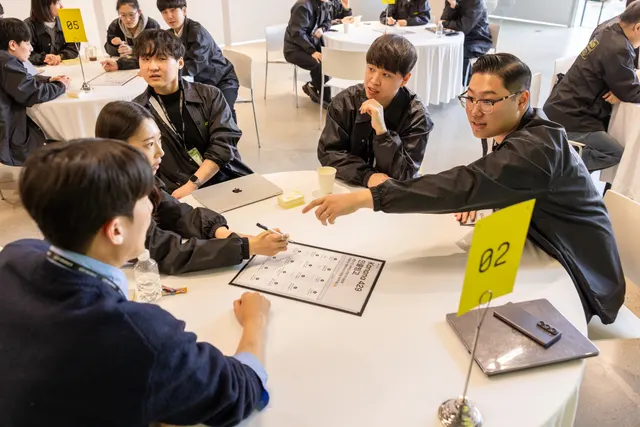
[KANANA429] 텍스트와 음성과 이미지를 한 모델로 처리하는 Kanana-o 아키텍처와 서빙 구조
국내 최초로 텍스트와 음성과 이미지를 통합한 멀티모달 모델 Kanana-o의 모델 머징 개발 방법론과 LMSPT 음성 토크나이저와 스트리밍 서빙 최적화를 분석합니다. API를 직접 호출해 수집한 48청크와 TTFA 3.477초의 실측 데이터도 함께 다룹니다.
[논문] 컴파일러 없이 스스로 코드를 고치는 ReflexiCoder
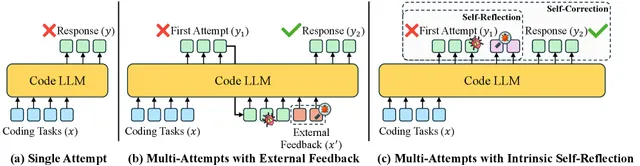
강화학습으로 외부 도구 없이 스스로 코드를 반성하고 수정하는 ReflexiCoder를 분석합니다. 8B 파라미터로 GPT-5.1과 경쟁하며 반성 과정이 오히려 토큰 사용량을 36% 줄이는 역설적인 결과까지 살펴봅니다.
[논문] 코리퍼런스 해소로 RAG 검색 정확도를 높이는 법
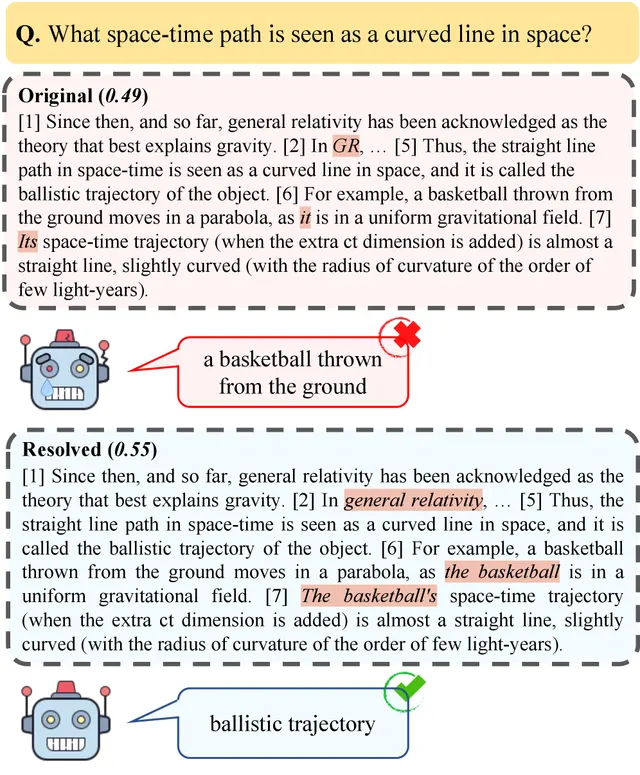
RAG 시스템에서 대명사와 지시사로 인한 참조 모호성이 검색과 생성 품질을 떨어뜨린다. 8개 임베딩 모델과 7개 LLM과 4개 데이터셋 실험으로 공지시 해소가 Mean pooling 모델의 검색 성능을 높이고 Qwen2.5-7B의 SQuAD F1을 0.40에서 0.80으로 두 배 끌어올림을 보인다.
[논문] 영상 내용을 직접 이해하고 검색하는 멀티에이전트 V-Agent
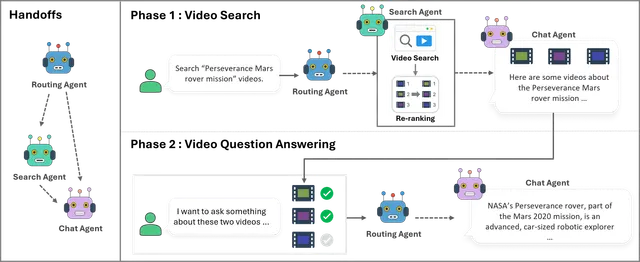
NC AI 연구팀이 ACM CIKM 2025에 발표한 V-Agent를 분석합니다. VLM을 검색 모델로 바꾸는 검색 벡터 기법과 세 에이전트의 협력 구조로 MultiVENT 2.0에서 기존 SOTA를 9.4%p 앞선 과정을 실험 데이터와 함께 살펴봅니다.