OpenAI dots와 Gemini 4 Argon 발표에서 확인된 사실과 유출 수치의 차이, 9월에 늘어난 온프레미스 오픈 웨이트 모델, LLM 위키 운영 실측을 정리합니다. 우리나라 기업이 이번 주 결정에 적용할 기준 다섯 가지를 함께 제시합니다.
핵심 요약
2026년 9월 마지막 주와 10월 첫째 주에 기업 AI 도입 판단에 닿는 발표가 네 갈래로 나왔습니다. OpenAI가 9월 29일 상시 가동 에이전트 dots를 공개했고, Google이 9월 30일 Gemini 4 Argon을 사이버 방어 조직 한정으로 발표했습니다. 같은 기간에 온프레미스 운영이 가능한 오픈 웨이트 모델이 늘었고, Karpathy의 LLM 위키 패턴은 3개월 운영 보고와 사전등록 비교 논문이라는 실측 자료를 얻었습니다. 이 글은 각 발표에서 확인된 사실과 아직 확인되지 않은 주장을 나누고, 우리나라 기업이 이번 주 결정에 적용할 기준을 정리합니다.
OpenAI dots, 상시 가동 에이전트의 권한 구조
OpenAI는 dots를 "항상 켜져 있는 에이전트"로 설명합니다. 사용자가 이름을 붙인 에이전트가 전용 클라우드 컴퓨터와 브라우저를 갖고, 연결된 앱을 읽어 할 일을 먼저 찾고, 결과를 ChatGPT와 Slack과 Teams로 보고합니다. 구동 모델은 GPT-6 Astra이고 연결 가능한 앱은 4,000개가 넘습니다. 조직용으로는 자체 신원과 자격증명을 가진 specialist dots를 예고했고, Microsoft Agent 365와 연동해 기존 거버넌스 도구로 관리하는 구성을 준비하고 있습니다.
도입 판단에서 중요한 것은 기능 목록보다 권한 구조입니다. 발표문 기준으로 정리하면 다음과 같습니다.
| 항목 | 발표문 내용 |
|---|---|
| 포함 플랜 | Pro와 Business Premium에 dot 1개 추가 비용 없이 포함 |
| Enterprise | 관리자가 베타를 켜야 사용 가능. 기본은 꺼짐 |
| 백그라운드 조사 | 읽기 전용 도구만 사용. 메시지 전송, 앱 콘텐츠 변경, 브라우저나 컴퓨터 제어 불가 |
| 채널 | ChatGPT(데스크톱, 웹, 모바일), Slack, Teams, 음성 통화. 문자는 예정 |
| 조직용 | specialist dots(전용 신원·자격증명·시스템 접근), Microsoft Agent 365 연동 예정 |
| 데이터 | Business·Enterprise·Edu 워크스페이스 콘텐츠는 기본적으로 학습에 사용하지 않음 |
Enterprise가 기본 꺼짐이라는 점이 실무상 가장 큰 변수입니다. 켜는 순간 에이전트가 연결된 앱을 사용자 개입 없이 지속적으로 읽기 시작하므로, 어떤 앱을 연결할지와 어떤 행동에 승인을 요구할지를 정하지 않은 조직은 꺼진 상태를 유지하는 것이 맞습니다. 반대로 이미 Slack이나 Teams에 업무 흐름이 있는 조직은 읽기 전용 조사와 승인 필요 행동의 경계가 발표문에 명시돼 있어 파일럿 범위를 좁게 잡을 수 있습니다.
Gemini 4 Argon, 유출 수치와 공식 수치의 차이
Gemini 4는 9월 내내 유출과 추정이 이어졌습니다. 9월 30일 Google DeepMind의 Koray Kavukcuoglu가 발표문을 올리면서 일부가 사실로, 일부가 틀린 것으로 정리됐습니다. 발표 시점에 제공 대상은 Fairwind Program의 사이버 방어 조직뿐이고, 이후 유료 API 고객과 Google AI Ultra 구독자, 그 다음 일반 사용자 순으로 확대한다고 했으나 날짜는 없습니다.
| 항목 | 9월 유출·추정 | 9월 30일 공식 발표 |
|---|---|---|
| 이름 | LMArena에서 gemini-3.8-flash로 위장한 모델, 코드명 Argon | Gemini 4 Argon |
| DeepSWE v1.1 | 88.7% (9월 28일 X 게시물) | 77.9% |
| 가격 | 입력 $2.25, 출력 $11.25 | 도입가 입력 $2, 출력 $10. 도입 기간 뒤 $4, $20. 캐시 입력 95% 할인 |
| 출력 한도 | 25만 6천 토큰 | 100만 토큰(기존 64K) |
| 컨텍스트 | 150만에서 1,000만까지 설이 엇갈림 | 발표문에 없음 |
| 그 밖의 공식 수치 | AutomationBench 51.3%, LVBench 91.7%, CWE-bench v1 68% |
유출 수치는 9월 17일 LMArena에 나타난 모델을 두고 2차 보도와 분석 글이 전한 것이며 Google은 확인한 적이 없습니다. 유출된 벤치마크와 공식 수치는 같은 주에 10포인트 넘게 갈렸습니다. 유출 수치로 벤더 비교표를 만들거나 예산을 잡은 조직이 있다면 이번 주에 바로 고쳐야 합니다. 현재 Gemini API 가격표에서 정식(Stable) 등급의 상위 모델은 Gemini 2.5 Pro와 Gemini 3.8 Flash이고, Gemini 3.1 Pro는 Preview 등급, Gemini 3.5 Pro는 출시되지 않았습니다. Argon은 가격표와 Vertex AI 모델 목록에 아직 없습니다. 운영 계약은 이 목록을 기준으로 맺고, Argon은 일반 제공 뒤 평가셋으로 다시 측정하는 순서가 맞습니다.
온프레미스 모델 선택지, 9월과 10월 기준
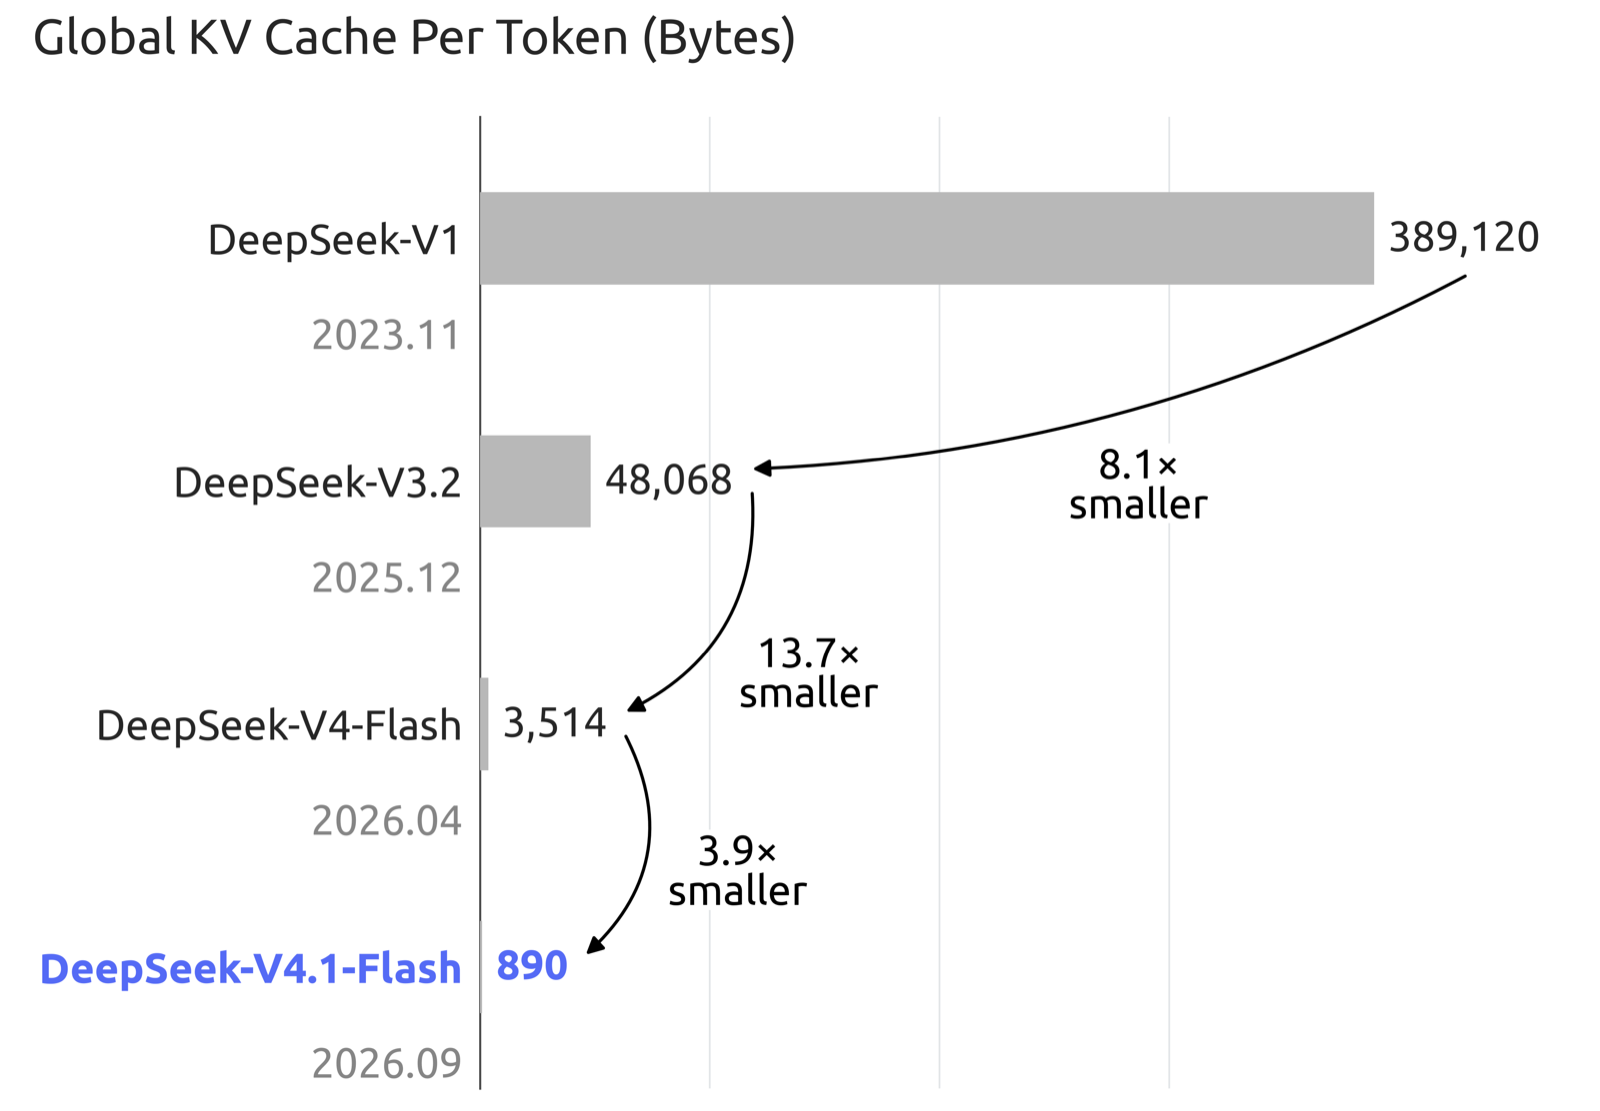
9월 10일 DeepSeek이 V4.1 Flash 가중치를 MIT 라이선스로 공개했습니다. 백본 552B에 토큰당 활성 파라미터가 프리필 8B, 디코드 16B이고, KV 캐시가 토큰당 890바이트로 V4 Flash의 약 4분의 1입니다. 같은 GPU 메모리에서 동시 세션 수가 늘어난다는 뜻이라 온프레미스 서빙 비용에 직접 닿는 변화입니다. 우리나라 모델 가운데 모델 카드에 한국어 벤치마크(KMMLU-Pro, CLIcK)와 GPU 요건이 함께 적힌 것은 SKT A.X K2와 업스테이지 Solar Open 2입니다.
| 모델 | 파라미터(총/활성) | 라이선스 | 컨텍스트 | 모델 카드 수치 | GPU 요건(명시된 경우) |
|---|---|---|---|---|---|
| DeepSeek V4.1 Flash | 552B / 8B 프리필·16B 디코드 | MIT | 100만 | GPQA Diamond 90.9, Terminal-Bench 2.1 90.6, DeepSWE v1.1 74.2 | 미명시 |
| Qwen3.8-27B | 27B dense | Apache 2.0 | 262K(확장 100만) | GPQA Diamond 89.2, SWE-bench Pro 61.7 | 미명시 |
| A.X K2 (SKT) | 688B / 33B | Apache 2.0 | 128K(YaRN 256K) | KMMLU-Pro 80.5, CLIcK 91.6 | 집계 GPU 메모리 800GiB 이상 |
| Solar Open 2 (업스테이지) | 250B / 15B | Upstage Solar License | 100만 | KMMLU-Pro 78.4, CLIcK 90.7 | 최소 H200 4장, 권장 8장 |
| gpt-oss-120b (OpenAI) | 117B / 5.1B | Apache 2.0 | 미명시 | GPQA Diamond 80.81 | 80GB GPU 1장 |
벤치마크는 각 모델 카드의 자체 보고치라 모델 간 직접 비교는 할 수 없습니다. 표에서 읽을 것은 세 가지입니다. 첫째, 라이선스 등급이 갈립니다. MIT와 Apache 2.0은 법무 검토가 짧고, Solar License는 모델명 접두와 "Built with Solar" 표기 의무가 있습니다. 둘째, 한국어 성능 근거가 카드에 있는 모델은 둘뿐입니다. 셋째, GPU 요건을 적은 모델과 적지 않은 모델이 섞여 있어 조달 전에 자체 측정이 필요합니다.
조달 환경도 같은 기간에 바뀌었습니다. NVIDIA는 10월 2일 DGX Spark 64GB 모델을 $4,999에 내놓으면서 128GB 모델 가격을 $6,950으로 올렸고, 사유를 메모리 공급으로 설명했습니다(2차 보도). TrendForce는 2027년 HBM 평균 판매가가 전년 대비 121% 오른다고 전망했습니다(보도). 확정 수요 없이 장비를 먼저 사는 조직은 이 변동을 그대로 부담하게 됩니다. 규제 쪽은 금융위원회가 9월 3일 보안 목적 AI 활용 테스트 2차 확대 방안을 발표했는데, 범위가 보안 목적과 SaaS 형태 탐색에 한정돼 있어 내부망 생성형 AI의 일반 허용으로 읽어서는 안 됩니다. 국가정보원은 9월 17일 공공 AI 시스템의 보안 실태를 공개하며 연내 AI 레드티밍 가이드라인 배포를 예고했으므로, 공공 온프레미스 도입은 점검 통과 비용을 도입 비용에 포함해야 합니다.
LLM 위키, 3개월 운영 실측과 비교 논문
Karpathy가 4월 4일 올린 LLM Wiki gist는 원문 보관소, LLM이 전부 쓰는 마크다운 위키, 구조와 규약을 적은 스키마 문서의 세 층으로 지식 베이스를 만드는 패턴입니다. 작업은 수집(원문 하나가 여러 페이지를 갱신), 질의(색인을 먼저 읽고 내려가며 좋은 답은 페이지로 저장), 점검(모순·낡은 주장·고아 페이지 탐지) 셋입니다. RAG가 질문마다 지식을 처음부터 다시 조립하는 데 비해 위키는 한 번 컴파일한 뒤 최신 상태로 유지한다는 것이 핵심 주장이고, 원문 약 100건과 수백 페이지 규모까지는 임베딩 없이 색인 파일만으로 된다고 적었습니다.
9월과 10월에 새 기업용 제품은 확인되지 않았습니다. 대신 판단에 쓸 실측 자료가 쌓였습니다.
| 자료 | 내용 | 확인된 수치 |
|---|---|---|
| Webvise 3개월 운영 보고 (7월 28일) | 한 팀이 실제 운영한 결과 | 490쪽, 880 커밋, 20종 점검을 하는 1,671줄 린터, 하루 5분과 일요일 30~45분 유지보수, 태그 662개, 권위 있다고 표시됐으나 낡은 페이지 약 30쪽, 같은 가격표가 4쪽에 중복 |
| 사전등록 비교 논문 (Cochran, 5월 18일, 8월 16일 개정) | 단일 라운드 벡터 RAG와 LLM 컴파일 위키 비교 | 논문 24편, 질문 13개. 위키가 쿼리당 토큰 약 21배, 구축 비용 약 두 자릿수 배. 종합 능력은 좋았으나 구성 우위는 두 심사자 합산 시 사전등록 임계 미달 |
| LangChain OpenWiki (7월 1일)와 WikiBench 평가 | 코드베이스 문서화 에이전트와 그 평가 | 위키와 원문을 함께 주는 구성이 원문만보다 높은 점수에 낮은 비용 |
Webvise 보고의 결론 문장은 도입 기준으로 그대로 쓸 만합니다. 에이전트는 언제나 그럴듯한 페이지를 찾아내며, 틀렸지만 그럴듯한 답은 답이 없는 것보다 나쁩니다. 잘못 생성된 페이지가 이후 모든 질의에 재사용되는 구조이므로, 점검 작업을 사람이 맡을 수 있는 규모에서만 성립합니다. 권한 분리가 필요한 인사·재무 문서나 수만 건 규모의 사내 문서는 접근 제어가 검색 엔진 안에 있는 RAG가 여전히 기본이고, LLM 위키는 한 담당자가 고른 수십에서 수백 건의 자료(경쟁사 동향, 규제 변화, 프로젝트 사후 기록)에 맞습니다.
우리나라 기업이 확인할 것
- dots 같은 상시 에이전트는 권한 구조로 평가합니다. 모델 성능은 그 다음 기준입니다. 연결할 앱 목록, 승인 없이 허용할 행동, 감사 로그 보관 위치를 먼저 정한 뒤 Enterprise 설정을 켭니다.
- 유출 벤치마크로 만든 비교표와 예산은 이번 주에 공식 수치로 고칩니다. Gemini 계열의 운영 계약은 현재 가격표의 정식 등급 모델을 기준으로 맺습니다.
- 온프레미스 후보는 라이선스 등급, 한국어 벤치마크 유무, GPU 요건 명시 여부 세 열로 먼저 거릅니다. 장비는 메모리 가격 변동을 감안해 확정 수요가 있는 범위만 조달합니다.
- LLM 위키는 사람이 점검을 맡을 수 있는 규모의 큐레이션 자료에 한정하고, 권한이 갈리는 문서는 RAG로 둡니다. 쿼리당 토큰이 RAG보다 크다는 점을 비용 계획에 넣습니다.
- 모델 교체 비용이 낮은 구조(프롬프트·평가셋·라우팅 계층 분리)를 먼저 갖추면 Gemini 4 일반 제공이나 Qwen 4 공개 같은 변수가 생겨도 재측정만으로 대응할 수 있습니다.
자주 묻는 질문
Q. dots를 Enterprise에서 바로 쓸 수 있습니까? A. 관리자가 베타를 켜야 하며 기본은 꺼져 있습니다. 백그라운드 조사는 읽기 전용 도구만 쓰지만, 연결 앱 범위와 승인 규칙을 정한 뒤 켜는 것이 맞습니다.
Q. Gemini 4 Argon을 지금 API로 쓸 수 있습니까? A. 발표 시점에는 Fairwind Program의 사이버 방어 조직만 접근할 수 있고, 유료 API 고객과 Google AI Ultra 구독자로 확대할 예정이나 날짜는 없습니다. 가격표와 Vertex AI 모델 목록에도 아직 없습니다.
Q. LLM 위키가 RAG를 대체합니까? A. 사전등록 비교 논문에서 위키는 쿼리당 토큰을 약 21배 더 썼고 구성 우위는 임계에 미달했습니다. 권한 분리가 필요한 대규모 사내 문서는 RAG가 기본이고, 위키는 큐레이션 자료에 맞습니다.
출처: Introducing dots · Gemini 4 Argon · DeepSeek-V4.1-Flash 모델 카드 · Qwen3.8-27B · A.X K2 · Solar Open 2 · gpt-oss-120b · LLM Wiki gist · Webvise 3개월 보고 · Cochran, arXiv 2605.18490 · LangChain WikiBench 평가 · Gemini 4 유출 보도 (NPowerUser) · DGX Spark 가격 보도 · TrendForce HBM 전망 보도
코텍시스 창업자로 AX 컨설팅과 기업 AI 교육, AI 에이전트 개발을 직접 수행합니다.
코텍시스 AI 인사이트 최신 논문 리뷰
AWQ 양자화: 활성값을 보고 가중치를 지키는 4비트 양자화
MIT 연구진의 AWQ는 활성값 분포를 기준으로 중요한 가중치 1%만 보호해도 저비트 양자화 오류가 크게 줄어든다는 관찰에서 출발해 재학습 없는 4비트 양자화를 구현했고 전용 커널 TinyChat으로 FP16 대비 3배 이상의 추론 속도를 달성했습니다. 온프레미스 sLLM을 소수의 GPU로 서빙해야 하는 기업에게 정확도 손실 없이 메모리와 비용을 동시에 줄이는 사실상의 표준 기법입니다.
Mixtral 8x7B로 읽는 MoE 아키텍처: 13B의 연산으로 70B급 성능 내기
총 47B 파라미터 중 토큰당 13B만 활성화하는 희소 MoE 모델 Mixtral 8x7B는 Llama 2 70B와 GPT-3.5를 대부분의 벤치마크에서 따라잡거나 능가했습니다. 추론 연산량은 소형 모델 수준으로 유지하면서 품질을 끌어올리는 MoE의 실용성을 입증한 사례로, 기업의 자체 호스팅 모델 선정 기준에 직접 영향을 줍니다.
DPO가 바꾼 선호 정렬 학습: 보상 모델 없이 RLHF를 대체하는 방법
DPO는 보상 모델의 재매개변수화를 통해 최적 정책을 닫힌 형태로 유도하고, 선호 데이터에 대한 단순 분류 손실만으로 RLHF와 같은 목적을 달성하는 기법입니다. 강화학습 파이프라인을 운영할 여력이 없는 기업 프로젝트에서 선호 정렬을 현실적인 작업 범위로 만들어 준 논문입니다.
AI 솔루션이 필요하신가요?
cortexys.team에서 맞춤 AI 개발 서비스를 확인하세요.