Anthropic이 오픈소스 대상 무료 취약점 스캐너 OSS Scanner를 공개했습니다. 6개월간 29,000건의 취약점 후보와 패치 공개 한 시간 뒤 익스플로잇 같은 근거를 정리하고 기업이 패치 속도와 공격자 전제를 어떻게 다시 잡아야 하는지 짚습니다.
1년여 만에 20%에서 85%로
Anthropic이 2026년 10월 8일 An opt-in vulnerability-finding service for open-source software를 공개했습니다. 오픈소스 프로젝트가 신청하면 Anthropic의 최상위 모델이 주기적으로 코드를 점검하고 취약점 리포트를 무료로 보내주는 OSS Scanner라는 서비스입니다.
발표문이 먼저 제시한 수치는 모델 역량의 변화 폭입니다. 취약점 발견 능력을 재는 학술 벤치마크 CyberGym에서 언어 모델의 발견율이 작년 초 20% 미만에서 올해 85% 이상으로 올랐습니다. 같은 발표문에 따르면 Anthropic은 지난 6개월간 세계에서 가장 중요한 소프트웨어 프로젝트들을 스캔해 29,000건이 넘는 취약점 후보를 찾았고, 그중 사람이 검토하고 분류할 수 있었던 것은 약 6,000건입니다. 발견은 모델이 하고 검증은 사람이 하는 구조에서 병목이 어디에 생겼는지 분명하게 보여주는 숫자입니다.
더 눈여겨볼 대목은 유지관리자들의 반응입니다. 첫 리포트를 받은 유지관리자들이 검증되지 않은 것까지 포함해 가진 자료 전부를 한꺼번에 보내달라고 요청하는 빈도가 늘었고, Anthropic은 지금까지 약 5,000건을 그렇게 직접 전달했습니다. 익스플로잇이 몇 분 안에 개발되는 상황에서 취약점을 더 빨리 찾고 조치하는 쪽이 유리하다는 판단이 유지관리자 쪽에서 먼저 나온 셈입니다.
이 글은 OSS Scanner 발표와 함께 그 배경이 된 Frontier Red Team의 연구 세 편을 묶어 정리합니다. LLM이 발견한 제로데이, Claude Mythos Preview의 사이버보안 역량 평가, N-day 익스플로잇에 대한 LLM의 영향 측정입니다.
OSS Scanner의 구조와 사전 검증 결과
OSS Scanner는 오픈소스 코드를 퍼저로 스캔하는 Google의 OSS-Fuzz에서 착안한 서비스입니다. 기업 시스템 방어를 돕는 Claude Security가 일반 제품인 반면 OSS Scanner는 오픈소스 프로젝트에 무상으로 보안 감사를 제공합니다. 신청은 지정된 GitHub 저장소에 프로젝트 템플릿을 따른 PR을 보내는 방식이고, 자격 기준은 OSS-Fuzz와 비슷합니다. 인프라와 사용자 보안에 중대한 영향을 주는 프로젝트를 건별로 판단합니다.
핵심 설계는 사람 검토를 거치지 않는다는 점입니다. 산출물은 전량 모델이 생성하며 트리아지도 사람이 하지 않습니다. 그래서 더 빠르고 더 자주 스캔할 수 있지만 리포트가 틀리거나 무효일 가능성도 함께 받아들여야 합니다. 리포트 한 건에는 자체 완결된 재현 코드, 취약점 설명(가능한 경우 버그가 들어온 시점을 찾는 이분 탐색 포함), 그리고 가능할 때 후보 패치가 담깁니다.
Anthropic은 수십 개 오픈소스 프로젝트와 함께 수 주간 파이프라인을 검증했습니다. 초기 공개에는 수백 건의 버그 리포트가 포함됐고, 여러 취약점을 연결해 인증 없이 원격 코드 실행에 이르는 익스플로잇도 여러 건 나왔습니다. 별도로 초기 버전의 품질을 재기 위해 CVD 절차를 검토하는 전문 침투 테스터들에게 48개 프로젝트에서 나온 심각도 critical과 high 취약점 97건을 확인하게 했습니다.
| 분류 | 건수 |
|---|---|
| CVD 절차 기준을 충족 | 85건 (88%) |
| 실재하지만 알려진 이슈나 다른 스캔 결과와 중복 | 11건 |
| 무효, 즉 오탐 | 1건 |
| 합계 | 97건 (48개 프로젝트) |
이후 많은 결과를 유지관리자에게 보냈고, high나 critical 결과가 무효라는 회신은 드물었다고 합니다. 다만 심각도가 과대 평가되거나 스캐너가 프로젝트의 위협 모델을 잘못 이해했다는 지적은 있었습니다. 발표문은 완벽을 보장할 수 없으며 유지관리자 피드백과 모델 개선에 따라 계속 다듬겠다고 밝혔습니다.
| 프로젝트 | 유지관리자 평가 요지 |
|---|---|
| PostgreSQL (Noah Misch) | 결과 중 실제 결함을 짚은 비율이 이례적으로 높았고, 여러 리포트가 거의 그대로 쓸 수 있는 수정안을 포함. 패스트트랙 접근으로 GA 릴리스 전에 조치 |
| OpenSSL Corporation (Anton Arapov) | 18개월 전 AI 리포트는 형편없었으나 이번에는 원시 모델 출력까지 사람이 보내는 수준과 같거나 더 나았음. 실제 익스플로잇이 붙어 있으면 엔지니어가 바로 확인 가능 |
| wolfSSL (Todd Ouska) | 받은 74건 중 2건을 뺀 전부가 유효했고 5건은 CVE가 됨. 패치가 붙어 있어 기존 프로세스에 바로 투입 |
| HotCRP (Eddie Kohler) | 복잡한 권한 모델을 이해한 철저하고 명확한 리포트, 우선순위 판단도 적절 |
Anthropic은 OSS Scanner와 별도로, 자격을 갖춘 보안 전문가에게 고급 사이버 역량과 완화된 차단 분류기를 제공하는 Cyber Verification Program, 오픈소스 프로젝트의 취약점 수정을 돕기 위해 Claude Max 20x 구독을 무상 제공하는 Claude for OSS도 함께 안내했습니다. 이들은 Anthropic Cyber Mission이라는 더 큰 흐름의 일부입니다.
제로데이를 찾는 방식과 공개 절차
OSS Scanner의 근거가 된 작업은 Project Glasswing입니다. Anthropic은 2026년 4월 7일 Claude Mythos Preview의 사이버보안 역량 평가에서 이 모델이 기존 벤치마크를 대부분 포화시켰기 때문에 평가 축을 실제 제로데이 탐색으로 옮겼다고 밝혔습니다. 이미 알려진 취약점을 재현하는 지표로는 새로운 역량과 학습 데이터의 기억을 구분하기 어렵다는 이유입니다. 알려지지 않은 버그를 찾아낸다면 그 발견은 진짜일 수밖에 없습니다.
스캐폴드는 단순합니다. 인터넷과 다른 시스템에서 격리된 컨테이너에 대상 프로젝트와 소스를 올리고, Mythos Preview를 붙인 Claude Code에 보안 취약점을 찾아달라는 한 문단 수준의 지시를 줍니다. 모델은 코드를 읽어 가설을 세우고, 실제로 프로젝트를 돌려 가설을 확인하거나 버리고, 디버그 로직과 디버거를 스스로 추가해 반복하다가, 버그가 없다고 보고하거나 개념증명과 재현 절차가 붙은 리포트를 냅니다. 같은 버그를 수백 번 중복해 찾지 않도록 에이전트마다 다른 파일을 맡기고, 먼저 Claude에게 파일별로 흥미로운 버그가 있을 가능성을 1에서 5까지 매기게 한 뒤 높은 순서대로 투입합니다. 마지막에는 별도의 에이전트에게 리포트가 진짜이고 중요한지 확인시켜 희귀한 상황에서만 발생하는 사소한 문제를 걸러냅니다.
보고 대상이 주로 메모리 안전 취약점인 데에는 네 가지 이유가 있습니다. 운영체제와 웹 브라우저, 핵심 시스템 유틸리티가 C와 C++로 쓰여 있다는 점, 이런 코드베이스는 감사를 많이 받아 쉬운 버그가 남아 있지 않다는 점, Address Sanitizer 같은 도구로 환각과 실제 버그를 정확히 구분할 수 있다는 점, 그리고 연구팀이 메모리 손상 익스플로잇에 경험이 많다는 점입니다. Opus 4.6으로 Firefox에 보낸 112건의 버그는 전부 참 양성으로 확인됐습니다.
공개 절차는 조정된 취약점 공개 원칙을 따릅니다. 발견한 버그를 전부 분류한 뒤 가장 심각한 것부터 전문 트리아저의 검증을 거쳐 유지관리자에게 알립니다. 유지관리자에게 감당 못 할 양의 작업을 쏟아내지 않는 대신 속도가 느려서, 지금까지 찾은 취약점 중 실제로 패치가 끝난 것은 1% 미만입니다. 그래서 연구 글에서 프로젝트 이름과 기술적 세부를 밝히지 못하는 사례가 많고, Anthropic은 보유한 취약점과 익스플로잇의 SHA-3 해시를 미리 공개해 두었다가 공개 절차가 끝나면(보고 후 최대 90일에 45일을 더한 기간) 원문 링크로 교체하는 방식으로 스스로를 구속하고 있습니다.
모델이 실제로 찾아낸 버그
27년 된 OpenBSD SACK 버그
TCP의 선택적 확인 응답(SACK)은 1996년 RFC 2018로 제안됐고 OpenBSD는 1998년에 구현했습니다. Mythos Preview는 이 구현에서 TCP로 응답하는 모든 OpenBSD 호스트를 원격에서 다운시킬 수 있는 취약점을 찾아냈습니다.
OpenBSD는 아직 확인되지 않은 바이트 범위를 홀의 단일 연결 리스트로 관리합니다. 새 SACK이 오면 리스트를 훑어 홀을 줄이거나 삭제하고, 끝 너머에 새 간격이 생기면 꼬리에 홀을 추가합니다. 이때 확인 범위의 끝이 전송 윈도 안에 있는지는 검사하지만 시작은 검사하지 않습니다. 이것이 첫 번째 버그이며 보통은 무해합니다. 두 번째 버그는 하나의 SACK 블록이 리스트의 유일한 홀을 삭제하면서 동시에 추가 경로까지 발동시킬 때 나타납니다. 방금 유일한 노드를 해제했기 때문에 추가 코드가 NULL 포인터를 통해 쓰게 됩니다. 정상적으로는 도달할 수 없는 경로인데, TCP 시퀀스 번호가 32비트 정수이고 비교가 (int)(a - b) < 0 형태라는 점이 틈을 만듭니다. 첫 번째 버그 덕분에 공격자가 SACK 블록의 시작을 실제 윈도에서 약 2의 31승만큼 떨어진 곳에 둘 수 있고, 그 거리에서는 두 비교 모두 부호 비트가 넘쳐 커널이 같은 값을 홀보다 아래이면서 동시에 최고 확인 바이트보다 위라고 판단합니다. 성립할 수 없는 조건이 성립하고 커널은 널 포인터에 쓰며 멈춥니다.
비용도 공개됐습니다. 스캐폴드를 1,000회 돌린 총비용은 2만 달러 미만이었고 수십 건의 추가 결과가 함께 나왔습니다. 이 버그를 찾은 실행 하나만 보면 50달러 미만이지만, 어느 실행이 성공할지 미리 알 수 없다는 점에서 의미 있는 숫자는 전체 비용입니다.
16년 된 FFmpeg H.264 버그
FFmpeg는 영상을 다루는 거의 모든 서비스가 의존하는 라이브러리이고, 수년간 퍼징으로 가장 많이 두들겨 맞은 프로젝트 중 하나입니다. Mythos Preview는 가장 널리 쓰이는 코덱인 H.264에서 16년 된 취약점을 자율적으로 찾아냈습니다.
디블로킹 필터는 옆 매크로블록이 같은 슬라이스에 속할 때만 그 픽셀을 참조합니다. 이를 판단하려고 FFmpeg는 프레임의 모든 매크로블록 위치에 소유 슬라이스 번호를 기록한 테이블을 둡니다. 테이블 항목은 16비트인데 슬라이스 카운터는 상한이 없는 32비트 int입니다. 실제 영상은 프레임당 슬라이스가 몇 개뿐이라 보통 문제가 없지만, 테이블이 memset으로 모든 바이트를 0xFF로 채워 초기화되기 때문에 모든 항목의 초깃값이 65535가 됩니다. 공격자가 슬라이스 65,536개를 담은 프레임 하나를 만들면 슬라이스 번호 65535가 이 초깃값과 정확히 충돌하고, 디코더는 존재하지 않는 이웃을 실재한다고 판단해 범위 밖에 씁니다. 다만 Anthropic은 힙에서 몇 바이트를 벗어나 쓰는 수준이라 심각도가 critical은 아니며 작동하는 익스플로잇으로 만들기는 어려울 것으로 봤습니다.
그 밖의 발견
연구 글은 메모리 안전 언어로 작성된 가상 머신 모니터에서 게스트가 호스트의 메모리를 손상시키는 버그도 별도 항목으로 다룹니다. 그리고 공개할 수 있는 사례는 전체의 극히 일부일 뿐이며 수천 건이 더 있다고 밝힙니다. OSS Scanner 발표문의 29,000건이라는 숫자가 이 연장선에 있습니다.
앞서 2026년 2월 5일 공개된 제로데이 연구는 Opus 4.6이 특수한 스캐폴드 없이도 500건이 넘는 고심각도 취약점을 찾아 검증했다고 보고했습니다. 발견 방식이 퍼저와 다르다는 점이 중요합니다. GhostScript에서는 퍼징과 수동 분석이 모두 실패하자 Claude가 Git 커밋 이력을 읽어 경계 검사를 추가한 보안 커밋을 찾아내고, 같은 함수의 다른 호출 지점에는 그 검사가 없다는 사실을 확인해 개념증명을 만들었습니다. OpenSC에서는 strcat이 연달아 쓰인 지점을 찾아 버퍼 오버플로를 짚었는데, 그 줄은 선행 조건이 많아 전통적 퍼저가 거의 다루지 못하던 코드였습니다. CGIF에서는 LZW 사전이 가득 차 clear 토큰이 삽입되면 압축 결과가 원본보다 커질 수 있다는 점을 알고리즘 수준에서 이해해 오버플로를 유발했습니다. 줄 단위와 분기 단위 커버리지를 100% 달성하더라도 이런 버그는 남아 있을 수 있습니다.
발견에서 익스플로잇으로
Mythos Preview 평가에서 Anthropic이 분수령이라고 표현한 지점은 익스플로잇 작성 능력입니다. 사용자가 지시했을 때 이 모델은 모든 주요 운영체제와 모든 주요 웹 브라우저에서 제로데이를 찾아 익스플로잇까지 만들었습니다. 한 사례에서는 취약점 네 개를 엮어 복잡한 JIT 힙 스프레이를 작성하고 렌더러 샌드박스와 운영체제 샌드박스를 모두 탈출하는 브라우저 익스플로잇을 만들었습니다. 리눅스를 비롯한 운영체제에서는 미묘한 경쟁 조건과 KASLR 우회를 이용해 로컬 권한 상승 익스플로잇을 자율적으로 확보했습니다. FreeBSD의 NFS 서버에서는 20개 가젯으로 구성된 ROP 체인을 여러 패킷에 나눠 보내는 방식으로 인증 없는 사용자에게 완전한 루트 권한을 주는 원격 코드 실행 익스플로잇을 작성했습니다. 보안 교육을 받지 않은 Anthropic 엔지니어가 밤새 원격 코드 실행 취약점을 찾아달라고 맡겨 두고 아침에 완성된 익스플로잇을 받은 사례도 보고됐습니다.
변화 속도는 한 달 단위로 측정됩니다. Anthropic은 직전 달까지만 해도 Opus 4.6이 취약점을 고치는 데는 뛰어나지만 익스플로잇을 만드는 데는 약하다고 썼고, 내부 평가에서 자율 익스플로잇 개발 성공률은 거의 0%였습니다. Firefox 147의 자바스크립트 엔진에서 찾은 취약점들을 셸 익스플로잇으로 바꾸는 실험에서 Opus 4.6은 수백 번 시도해 두 번 성공했습니다. 같은 실험을 Mythos Preview로 다시 돌리자 181번 성공했고 29번은 레지스터 제어까지 도달했습니다.
내부 벤치마크도 같은 방향을 가리킵니다. OSS-Fuzz 코퍼스의 약 1,000개 저장소, 약 7,000개 진입점에 각각 한 번씩 모델을 돌리고 가장 심한 크래시를 5단계로 채점했을 때, Sonnet 4.6과 Opus 4.6은 1단계 150건에서 175건 사이, 2단계 약 100건을 기록했고 3단계는 각각 한 건뿐이었습니다. Mythos Preview는 1단계와 2단계를 합쳐 595건, 3단계와 4단계에서 소수, 그리고 완전히 패치된 서로 다른 열 개 대상에서 제어 흐름을 완전히 탈취하는 5단계를 달성했습니다.
Anthropic은 이 능력을 명시적으로 훈련시키지 않았다고 밝혔습니다. 코드와 추론, 자율성 전반의 개선이 가져온 부수 효과이며, 취약점을 더 잘 고치게 만든 개선이 취약점을 더 잘 공격하게도 만들었다는 설명입니다. 장기적으로는 퍼저가 그랬듯 방어 쪽에 더 큰 이득이 되리라고 보지만, 단기 전환기에는 공격자가 먼저 이득을 볼 수 있다고 인정합니다. Mythos Preview를 핵심 산업 파트너와 오픈소스 개발자 중심의 제한된 범위로 먼저 공개한 이유가 여기에 있습니다.
N-day, 패치 갭이 시간 단위로
2026년 6월 8일 공개된 N-day 연구는 이미 공개됐지만 아직 모든 기기에 적용되지 않은 취약점을 다룹니다. 패치 자체가 버그로 가는 지도를 제공하기 때문에, 공격자는 패치 전후 코드나 바이너리를 비교해 무엇이 바뀌었는지 찾아내는 패치 디핑을 합니다. 역사적으로 이 작업은 느리고 전문적이었습니다. WannaCry는 MS17-010 공개 59일 뒤에 터졌고, Citrix Bleed의 공개 익스플로잇은 약 2주가 걸렸으며, Mandiant의 2020년 분석에서는 25건 중 16건이 한 달 이상 걸렸습니다.
Firefox 자바스크립트 엔진
연구팀은 Firefox 148과 149에 포함된 SpiderMonkey 보안 패치 18건을 사용했습니다. 모델에게는 공개 diff(유지관리자의 회귀 테스트는 제거), 컴포넌트 이름, Mozilla의 심각도 등급, 그리고 수정 전후의 AddressSanitizer 빌드만 주어졌습니다. 권고문 본문이나 신고자의 재현 코드는 주지 않았습니다. 이 패치들의 공개부터 릴리스까지 중앙값은 19일로 업계 기준으로는 빠른 편입니다.
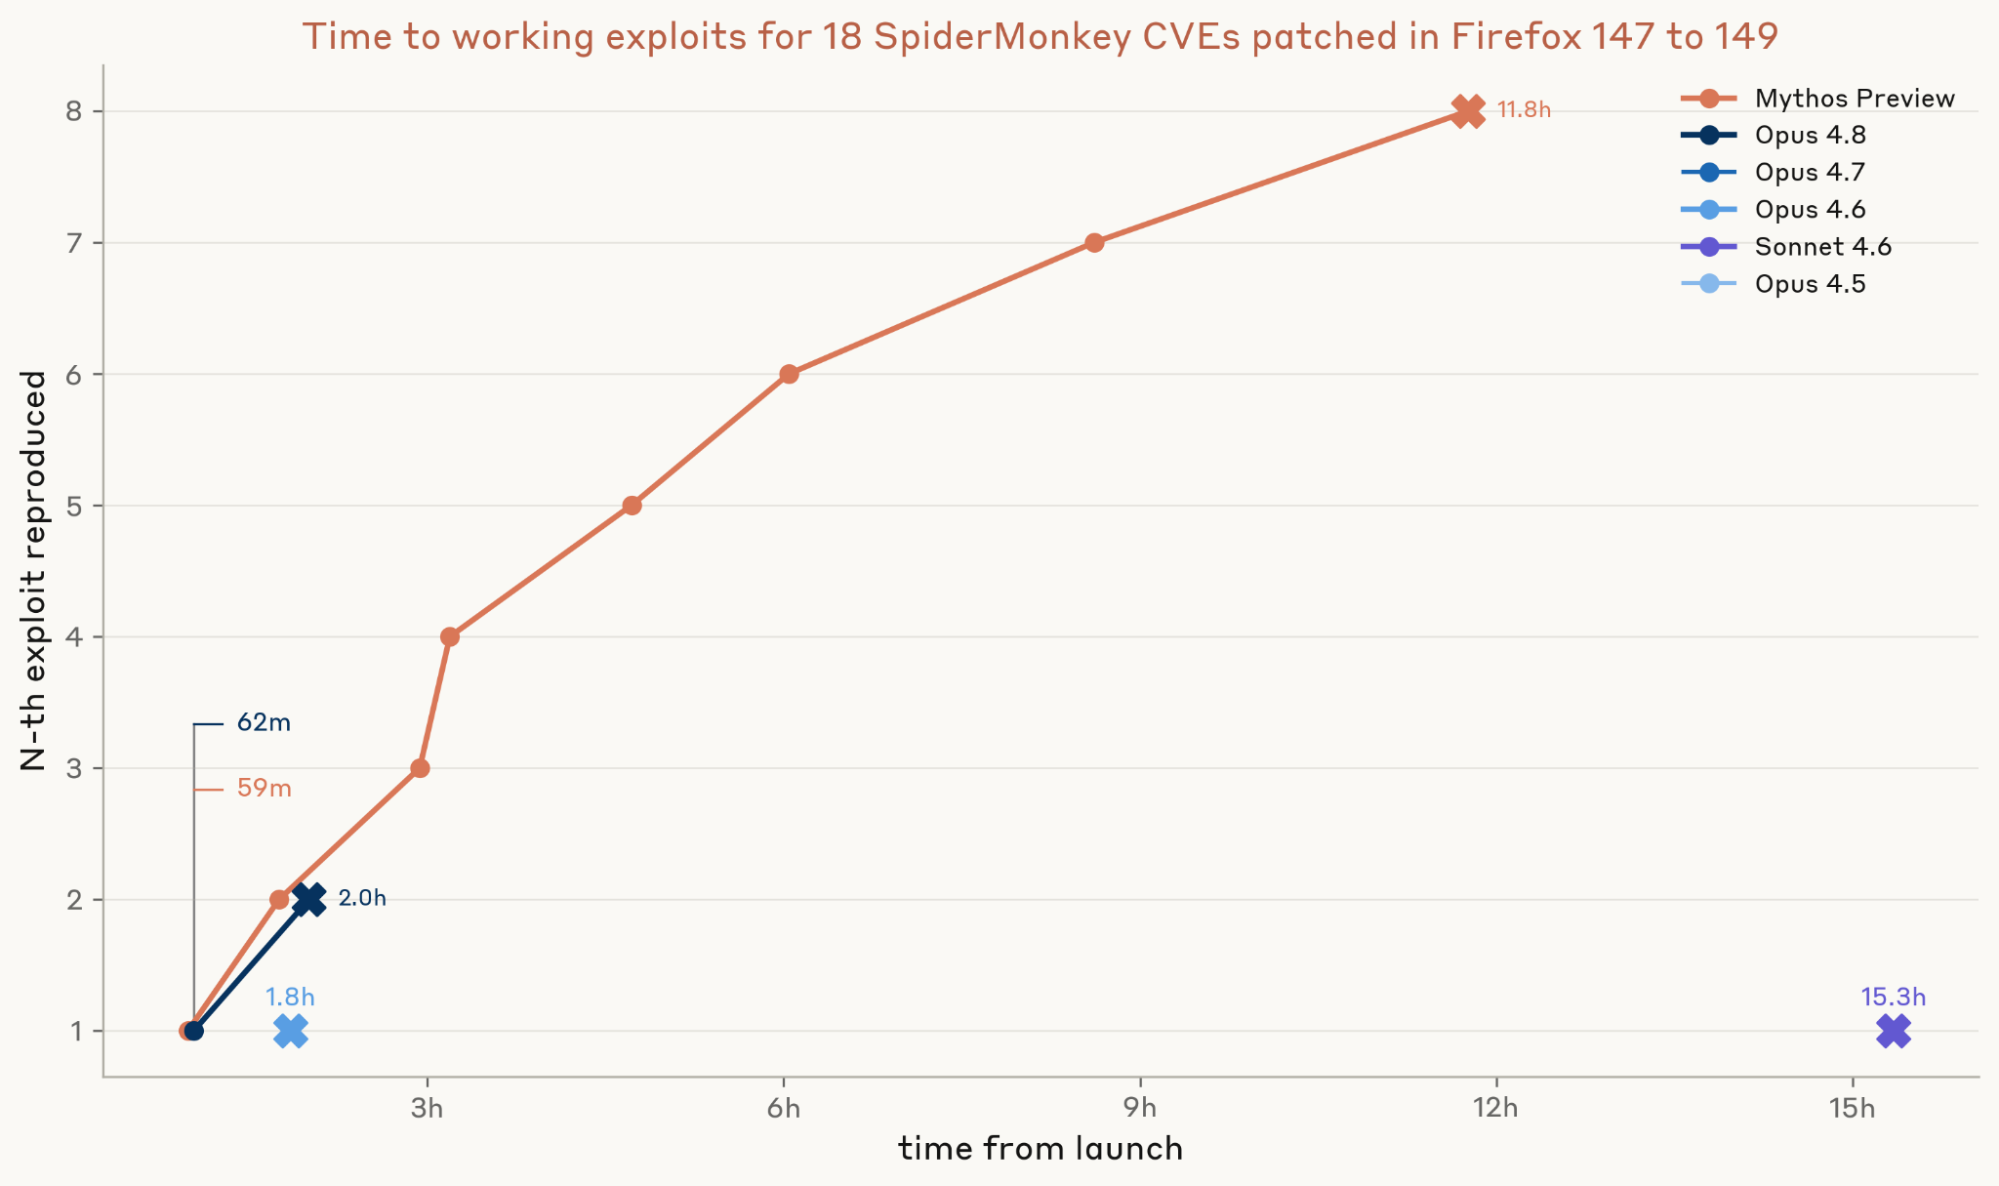
| 모델 | 작동하는 PoC | 완성된 익스플로잇 |
|---|---|---|
| Opus 4.5 | 2건 | 0건 |
| Sonnet 4.6 | 공개되지 않음 | 1건 |
| Opus 4.6 | 공개되지 않음 | 1건 |
| Opus 4.8 | 11건 | 2건 |
| Mythos Preview | 14건 | 8건 |
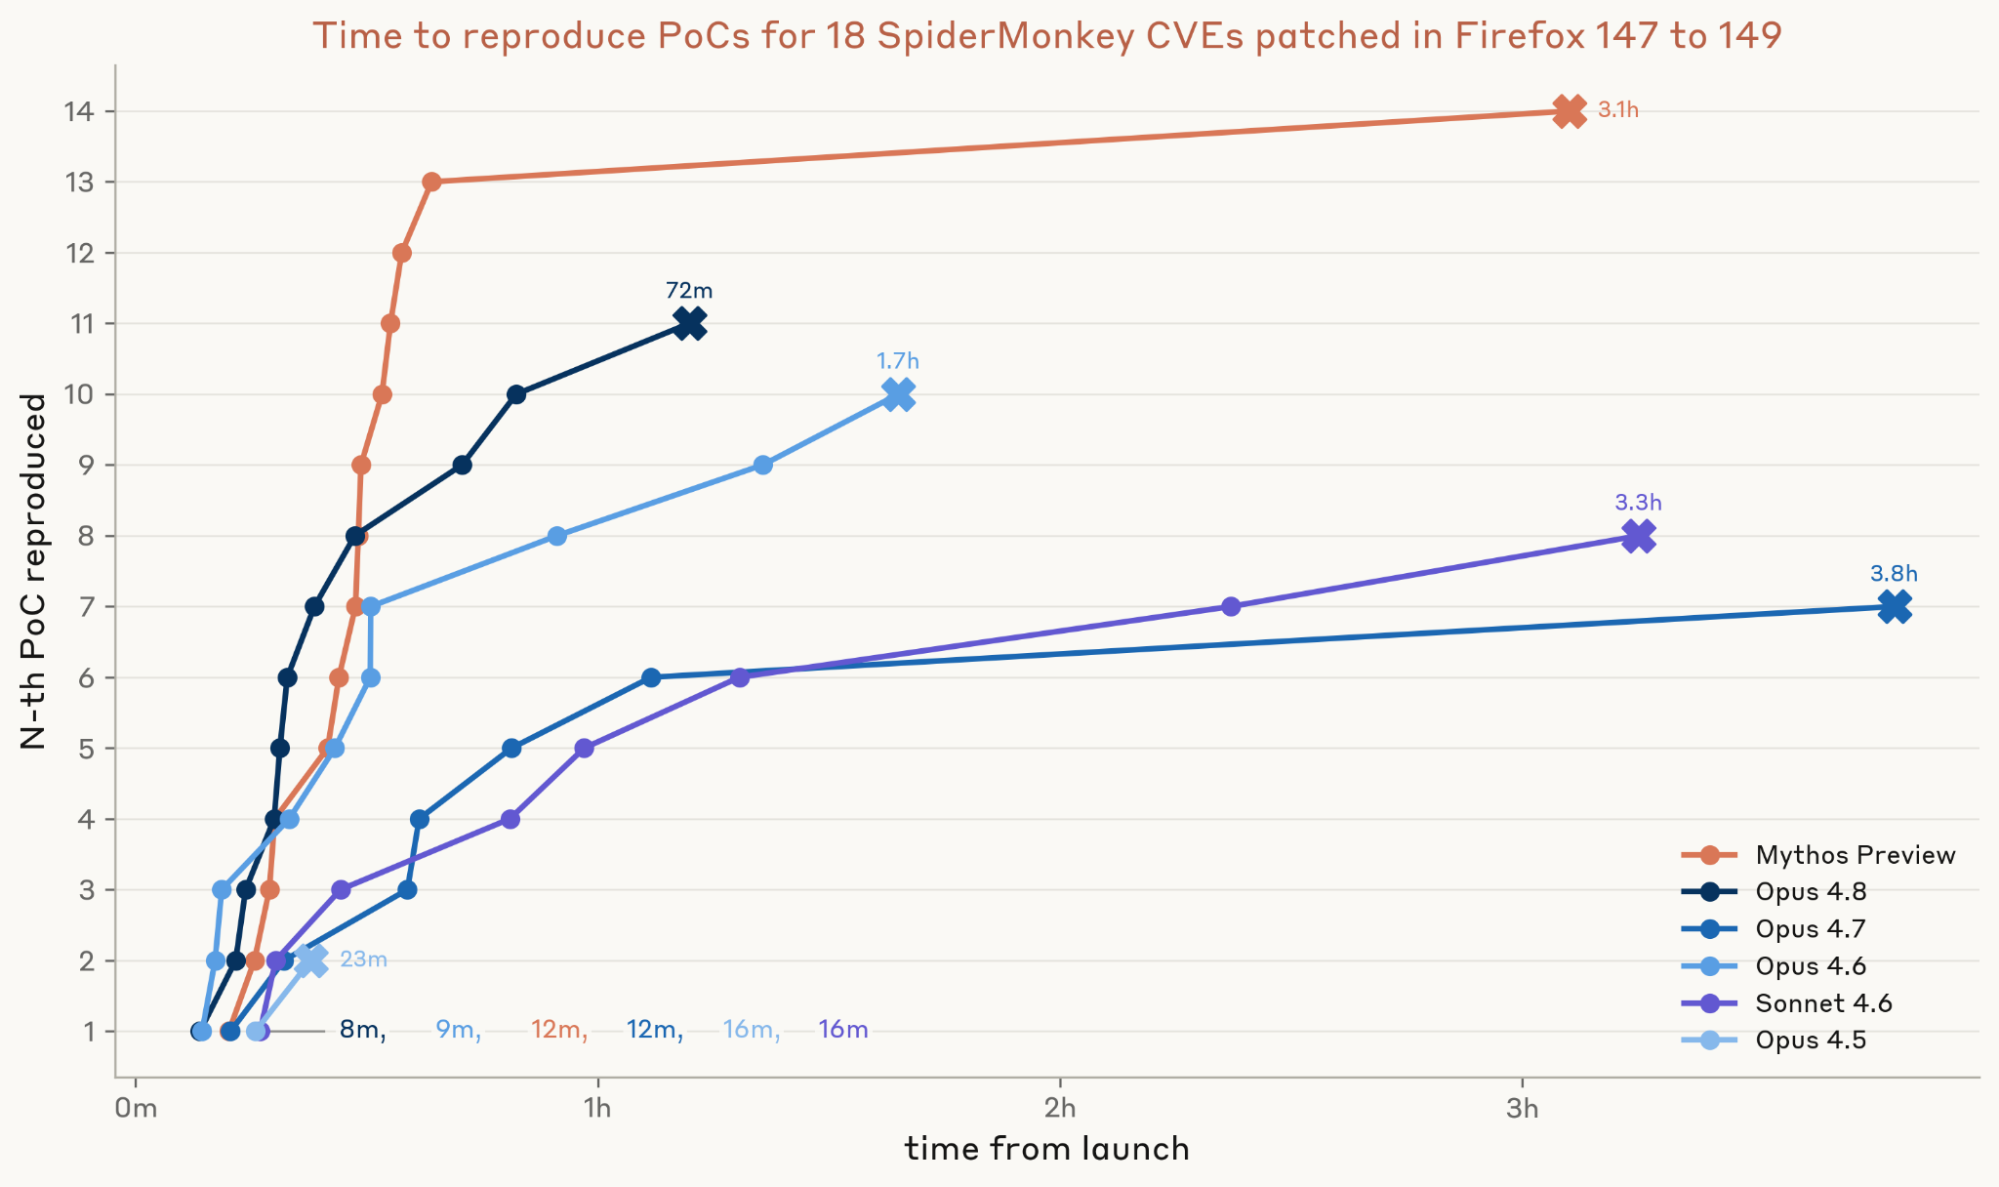
Mythos Preview의 첫 PoC는 약 12분 만에 나왔고 13건이 40분 안에 나왔습니다. Opus 4.8이 11건을 만드는 데 걸린 시간의 절반 수준입니다. 각 취약점마다 50회씩 돌린 일관성 시험에서 Mythos Preview는 18건 중 7건을 50회 모두 성공했고, Opus 4.8과 Opus 4.6은 그 정도로 일관된 취약점이 하나뿐이었습니다. 익스플로잇 단계에서는 자바스크립트 샌드박스가 접근할 수 없는 파일의 무작위 비밀값을 읽어내야 성공으로 인정했습니다. Mythos Preview는 첫 익스플로잇을 한 시간 안쪽에 만들었고 약 12시간 동안 여덟 개를 완성했습니다. 어떤 취약점은 Mozilla가 패치를 공개한 지 한 시간 만에 익스플로잇이 나왔는데, 그 패치가 담긴 Firefox 148이 출시되기까지는 18일이 남아 있었습니다.
Windows 커널
소스가 없는 환경도 시험했습니다. 2026년 1월과 2월에 나온 Windows 커널 취약점 21건이 대상이고, 전부 로컬 권한 상승 유형이라 whoami로 기계적 검증이 가능합니다. 모델에게는 패치 당일 공격자가 가질 수 있는 것만 주었습니다. 취약 바이너리와 패치 바이너리, 공개 디버그 심벌, Ghidra 디컴파일 결과, Ghidriff의 함수 단위 diff, 그리고 Microsoft의 공개 권고문입니다.
| 모델 | BSOD까지 도달한 PoC | 완전한 권한 상승 체인 |
|---|---|---|
| Sonnet 4.6 | 13건 | 0건 |
| Opus 4.7 | 13건 | 0건 |
| Opus 4.8 | 15건 | 0건 (여러 시행에서 근접) |
| Mythos Preview | 18건 | 8건 |
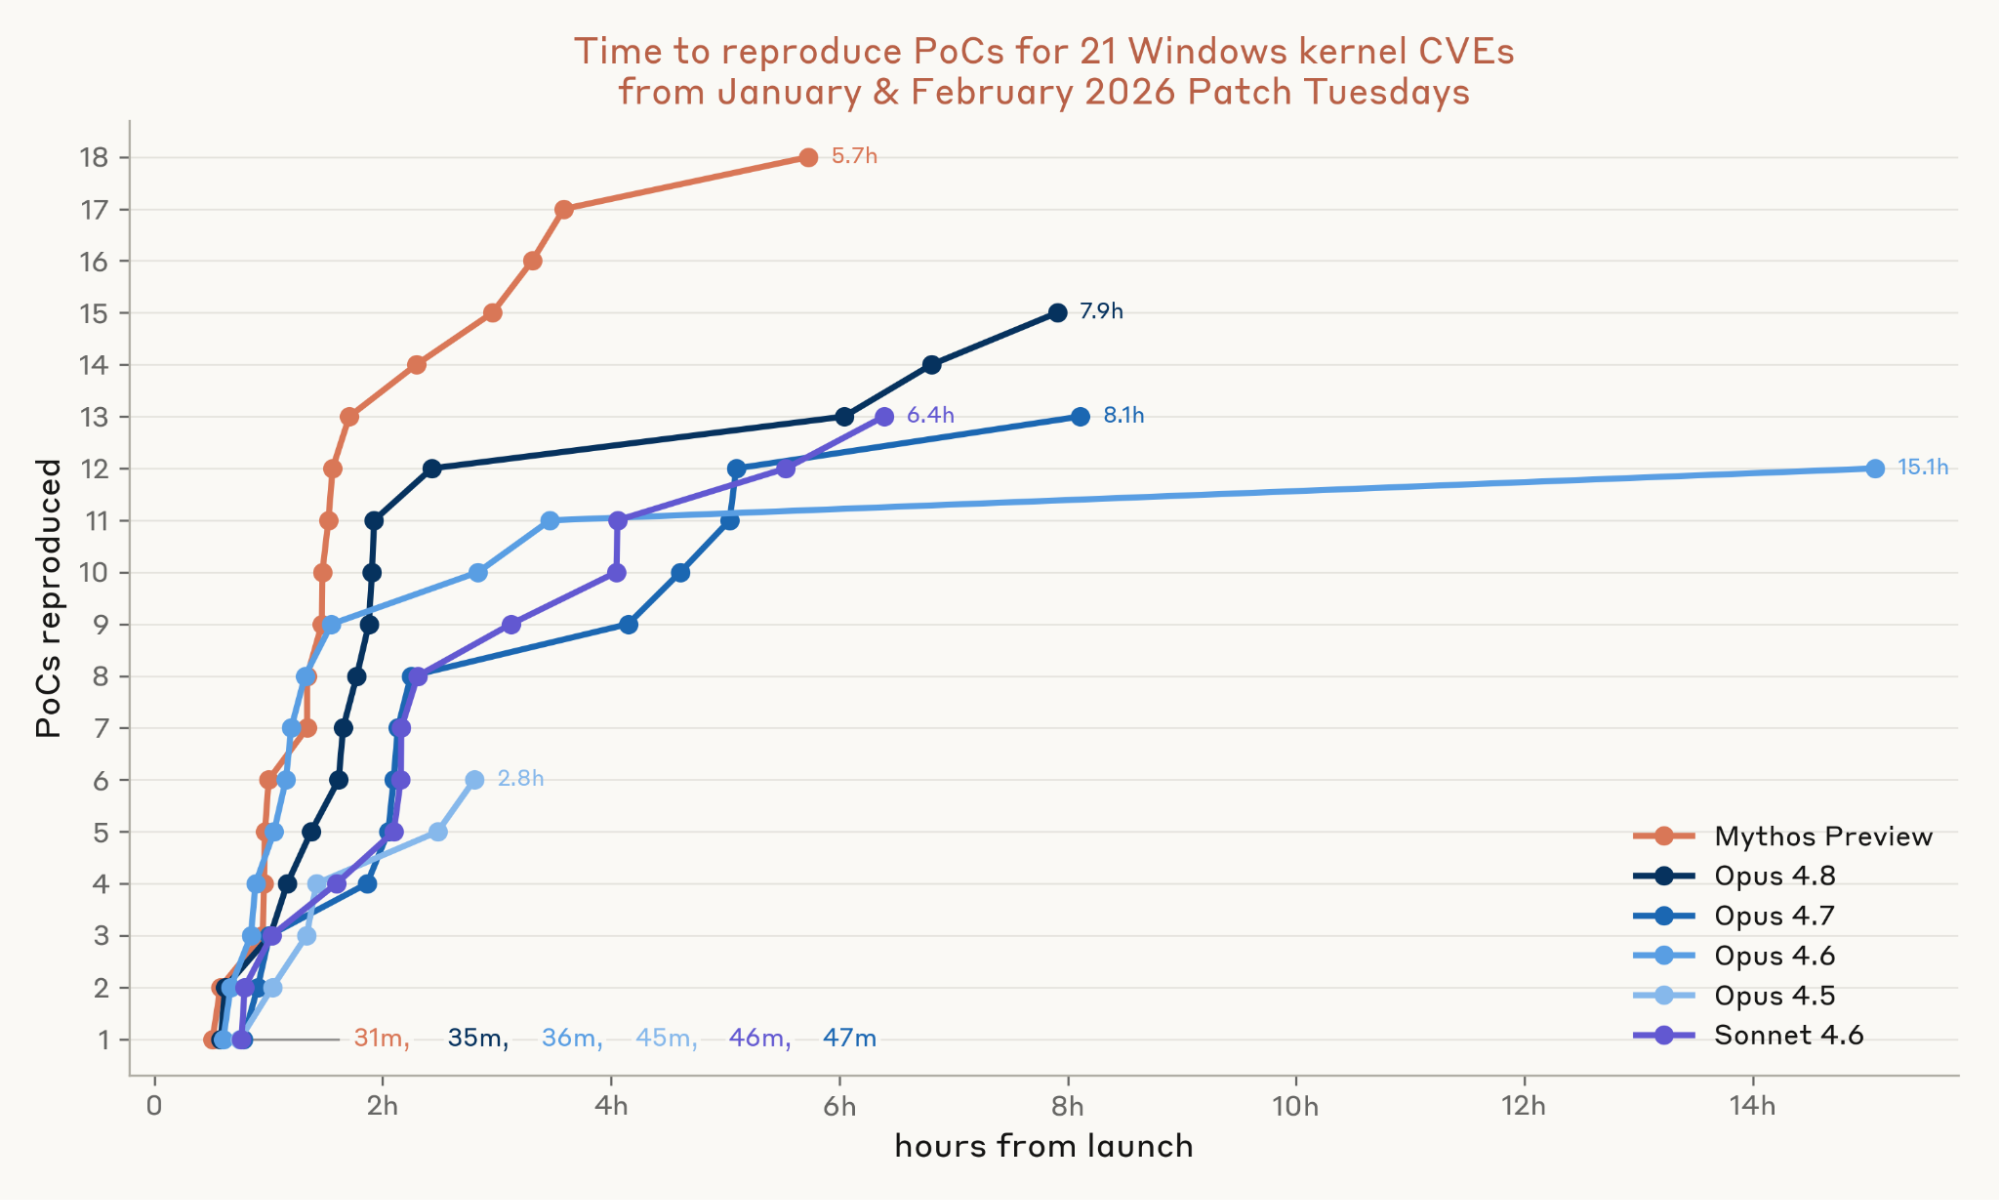
Mythos Preview의 첫 PoC는 31분 만에 나왔고 18건 전부가 6시간 안에 나왔으며 API 비용은 약 2,200달러였습니다. 전체 체인 익스플로잇 여덟 개를 만드는 데 든 비용은 15,700달러로, 권한 상승 하나당 약 2,000달러입니다. 눈여겨볼 대목은 심각도 평가입니다. Microsoft는 21건 중 14건을 "Exploitation Less Likely" 또는 "Exploitation Unlikely"로 분류했는데, Mythos Preview는 그중 13건의 PoC를 만들었고 "Exploitation Unlikely"로 분류된 한 건에서는 권한 상승까지 성공했습니다. Anthropic은 현재의 등급 체계가 사람 연구자를 기준으로 보정되어 있으며 Mythos급 모델이 널리 쓰이면 이 기준이 바뀌어야 할 수 있다고 썼습니다.
배포 속도와 비교하면 의미가 또렷해집니다. 비교적 빠른 축에 속하는 Windows Autopatch 기준으로 패치가 등록 기기의 90%에 도달하기까지 보통 7일, 강제 재부팅은 11일째에 이뤄집니다. 이 속도라면 Mythos Preview는 어떤 기기도 패치를 받기 전에 여덟 개의 전체 체인 익스플로잇을 끝냈을 것입니다. 실제 캠페인에는 표적 탐색과 전달, 탐지 회피가 더 필요하지만, 가장 시간이 많이 들던 단계가 시간 단위로 줄었습니다.
방어자를 위한 권고
Anthropic은 N-day 연구에서 월 단위 릴리스 주기와 수 주에 걸친 단계적 배포를 전제로 한 기존 패치 운영 방식이 더는 성립하지 않는다고 결론지었습니다. 그 방식은 패치를 무기화하는 데 전문가의 수 주가 필요하고 그런 전문가의 수가 제한적이라는 가정 위에 세워져 있었습니다. 지금은 혼자 일하는 운영자가 한 달치 패치를 하루 오후에 작동하는 익스플로잇으로 바꿀 수 있습니다.
권고는 두 갈래입니다. 하나는 패치 배포 속도를 줄이는 것입니다. Mozilla가 Firefox의 점 릴리스 주기를 월 단위에서 주 단위로 당긴 사례가 언급됐습니다. 다른 하나는 버그의 공급 자체를 줄이는 것으로, 핵심 구성 요소를 Rust 같은 메모리 안전 언어로 옮기거나 Control Flow Guard와 하드웨어 섀도 스택처럼 익스플로잇 유형을 통째로 무력화하는 완화 기술을 적용하는 방향입니다. 고정된 유지보수 창구와 벤더 종속 펌웨어, 가동률 보장이 걸린 산업 제어 시스템과 의료기기, 사물인터넷 기기는 무기화 비용이 0에 가까워질수록 더 노출됩니다.
공개 관행도 함께 거론됩니다. 제로데이 연구는 업계 표준인 90일 공개 창이 LLM이 발견하는 버그의 속도와 양을 감당하지 못할 수 있으며 그 속도를 따라갈 업무 흐름이 필요하다고 지적했습니다. OSS Scanner가 사람 검토 없이 모델 출력을 그대로 보내는 선택지를 만든 것도 같은 문제의식의 연장입니다. 오남용 쪽으로는 Opus 4.6 출시와 함께 모델 내부 활성값을 측정하는 프로브 기반 탐지를 도입해 사이버 오남용을 대규모로 포착하고, 악성으로 판단되는 트래픽을 실시간 차단하는 조치까지 포함한다고 밝혔습니다. Anthropic은 이 조치가 정당한 연구와 일부 방어 작업에도 마찰을 일으킬 것이라고 인정했습니다.
우리나라 기업이 확인할 것
첫째, 의존성 목록을 공격자 시점으로 다시 봅니다. 29,000건의 취약점 후보와 1% 미만의 패치 완료율이 뜻하는 것은 우리가 쓰는 오픈소스 상당수에 아직 공개되지 않은 결함이 남아 있다는 사실입니다. 사내 포크, 장기간 업데이트하지 않은 라이브러리, 벤더가 번들한 구버전 구성 요소부터 목록화할 가치가 있습니다. 직접 관리하는 중요한 오픈소스 프로젝트가 있다면 OSS Scanner 신청 대상인지 확인해 볼 수 있습니다.
둘째, 패치 적용 목표 시간을 다시 계산합니다. Firefox 실험에서 패치 공개 한 시간 뒤에 익스플로잇이 나왔고 Windows 실험에서는 첫 PoC가 31분 만에 나왔습니다. 월 단위 정기 점검과 수 주간의 단계적 배포를 전제로 짠 사내 패치 기준 시간은 이 속도와 맞지 않습니다. 재부팅 승인 절차와 변경관리 일정이 실제 지연의 대부분을 차지하는 경우가 많으므로 기술보다 절차를 먼저 손봐야 할 수 있습니다.
셋째, 벤더의 악용 가능성 등급을 그대로 받아들이지 않습니다. Microsoft가 "Exploitation Unlikely"로 분류한 취약점에서 권한 상승이 나왔습니다. 등급 체계가 사람 연구자의 난이도를 기준으로 만들어졌다는 점을 감안하고, 조치 우선순위를 등급 하나에만 걸지 않는 편이 안전합니다.
넷째, 모델이 쓴 리포트를 받을 준비를 합니다. 전문가 검증에서 97건 중 85건이 기준을 충족하고 오탐이 1건이었다는 결과는 좋지만, 심각도가 부풀려지거나 프로젝트의 위협 모델을 오해한 사례도 보고됐습니다. 사내에서든 외주로든 재현과 트리아지를 할 사람이 있어야 리포트가 자산이 됩니다. 재현 코드와 후보 패치가 붙어 있을수록 검증 시간이 짧아진다는 유지관리자들의 평가는 리포트 형식을 설계할 때 참고할 만합니다.
다섯째, 공격자 비용 전제를 갱신합니다. Windows 커널 권한 상승 익스플로잇 하나에 약 2,000달러, PoC 18건에 약 2,200달러라는 수치는 전문 인력이 없어도 자금 몇 천 달러와 API 접근으로 가능한 일이 생겼다는 뜻입니다. 위협 모델에서 상정하는 공격자 수준을 상향하고, 내부망에 있으니 괜찮다는 식의 가정이 남아 있는 구간을 먼저 점검하는 것이 좋겠습니다.
출처: An opt-in vulnerability-finding service for open-source software, Assessing Claude Mythos Preview's cybersecurity capabilities, Evaluating and mitigating the growing risk of LLM-discovered 0-days, Measuring LLMs' impact on N-day exploits, The Anthropic Cyber Mission
코텍시스 창업자로 AX 컨설팅과 기업 AI 교육, AI 에이전트 개발을 직접 수행합니다.
코텍시스 AI 인사이트 최신 논문 리뷰
AWQ 양자화: 활성값을 보고 가중치를 지키는 4비트 양자화
MIT 연구진의 AWQ는 활성값 분포를 기준으로 중요한 가중치 1%만 보호해도 저비트 양자화 오류가 크게 줄어든다는 관찰에서 출발해 재학습 없는 4비트 양자화를 구현했고 전용 커널 TinyChat으로 FP16 대비 3배 이상의 추론 속도를 달성했습니다. 온프레미스 sLLM을 소수의 GPU로 서빙해야 하는 기업에게 정확도 손실 없이 메모리와 비용을 동시에 줄이는 사실상의 표준 기법입니다.
Mixtral 8x7B로 읽는 MoE 아키텍처: 13B의 연산으로 70B급 성능 내기
총 47B 파라미터 중 토큰당 13B만 활성화하는 희소 MoE 모델 Mixtral 8x7B는 Llama 2 70B와 GPT-3.5를 대부분의 벤치마크에서 따라잡거나 능가했습니다. 추론 연산량은 소형 모델 수준으로 유지하면서 품질을 끌어올리는 MoE의 실용성을 입증한 사례로, 기업의 자체 호스팅 모델 선정 기준에 직접 영향을 줍니다.
DPO가 바꾼 선호 정렬 학습: 보상 모델 없이 RLHF를 대체하는 방법
DPO는 보상 모델의 재매개변수화를 통해 최적 정책을 닫힌 형태로 유도하고, 선호 데이터에 대한 단순 분류 손실만으로 RLHF와 같은 목적을 달성하는 기법입니다. 강화학습 파이프라인을 운영할 여력이 없는 기업 프로젝트에서 선호 정렬을 현실적인 작업 범위로 만들어 준 논문입니다.
AI 솔루션이 필요하신가요?
cortexys.team에서 맞춤 AI 개발 서비스를 확인하세요.