Anthropic이 쇼핑 에이전트와 머천트 에이전트 참조 구현을 담은 블루프린트를 공개했습니다. 두 에이전트가 맡는 일과 발표된 성과, 직군별 활용과 도입 시 확인할 점을 기업교육 관점에서 정리합니다.
Anthropic이 2026년 9월 2일 claude.com 블로그에 Building commerce agents with Claude를 발표했습니다. 쇼핑 에이전트와 머천트 에이전트의 참조 구현, 하네스와 가드레일, Claude Code 플러그인을 묶은 블루프린트입니다. 코텍시스는 이 발표를 기업교육 관점에서 읽었습니다. 코드는 며칠이면 돌지만 카탈로그와 정책과 승인 기준을 아는 사람은 현업에 있고, 에이전트가 올린 제안을 승인하는 것도 현업이기 때문입니다.
두 에이전트가 맡는 일
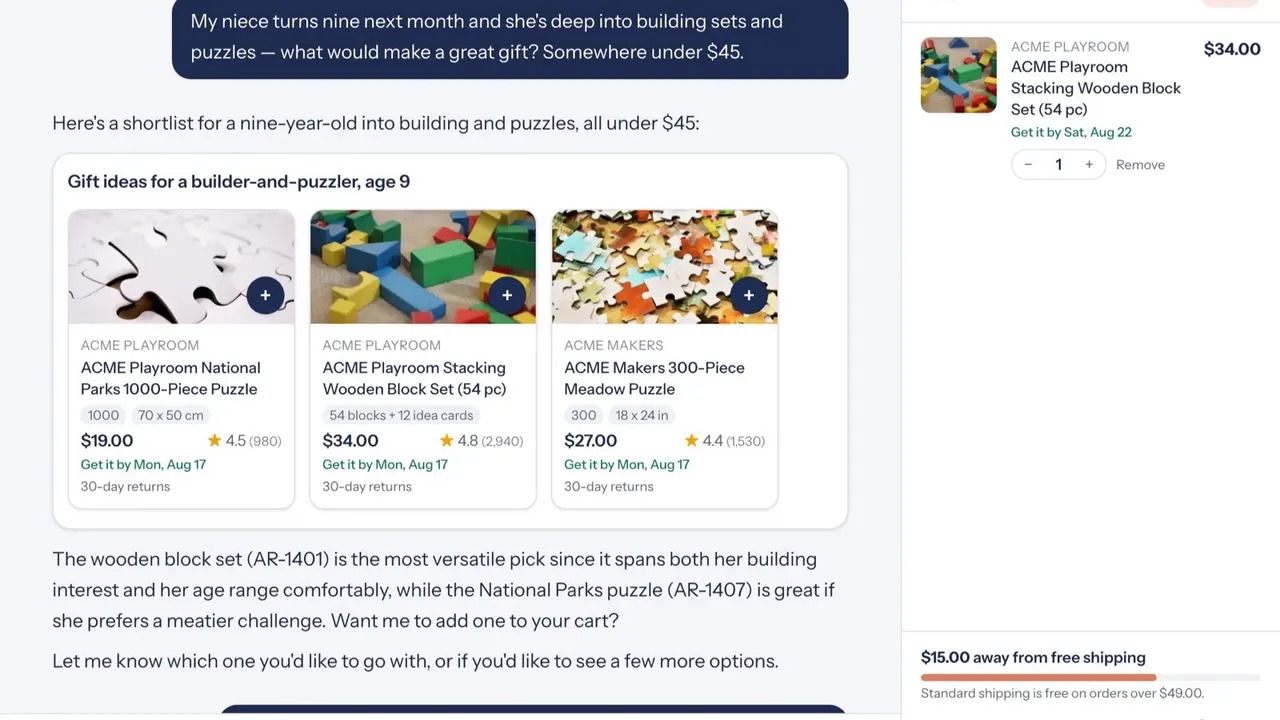
쇼핑 에이전트는 고객 앱과 웹사이트 안에서 돕니다. "두 아이와 주말 캠핑에 갈 텐트·침낭·버너"라는 한 문장에서 카탈로그를 검색해 여러 품목을 한 번에 구성하고, 선호를 기억해 추천을 조정하며, 비교표와 장바구니를 대화 안에 바로 띄우고 체크아웃으로 넘깁니다. 배송 조회와 반품·환불 문의도 같은 대화에서 처리합니다. 가격과 상품은 실제 카탈로그 데이터로 제한되고 조작적 업셀은 피하도록 설계됐습니다.
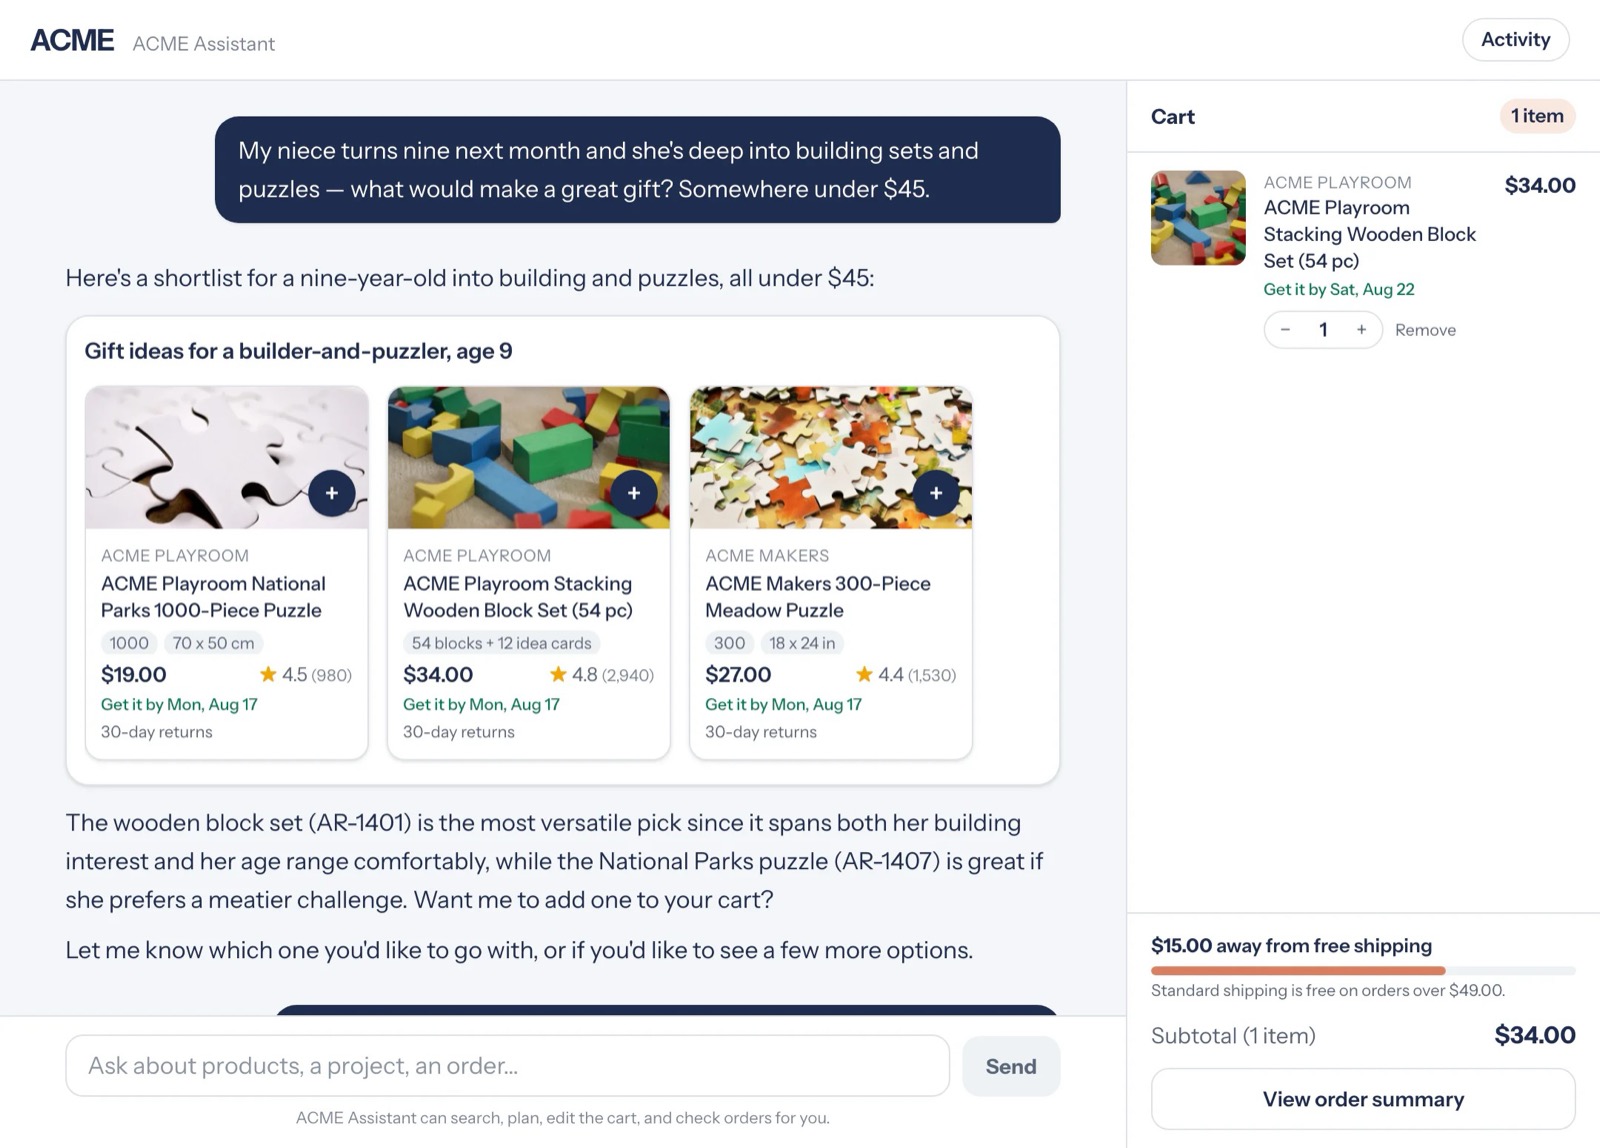 출처: Anthropic, 원문
머천트 에이전트는 매장을 운영하는 사람을 돕습니다. "지난 시즌 재고를 털려면 무엇을 할인해야 하나"에 자사 데이터로 답하고, 프로모션 전에 품절될 상품을 미리 경고하며, 가격·프로모션을 추천하고 캠페인 초안을 씁니다. 제안은 사람이 승인해야 반영됩니다.
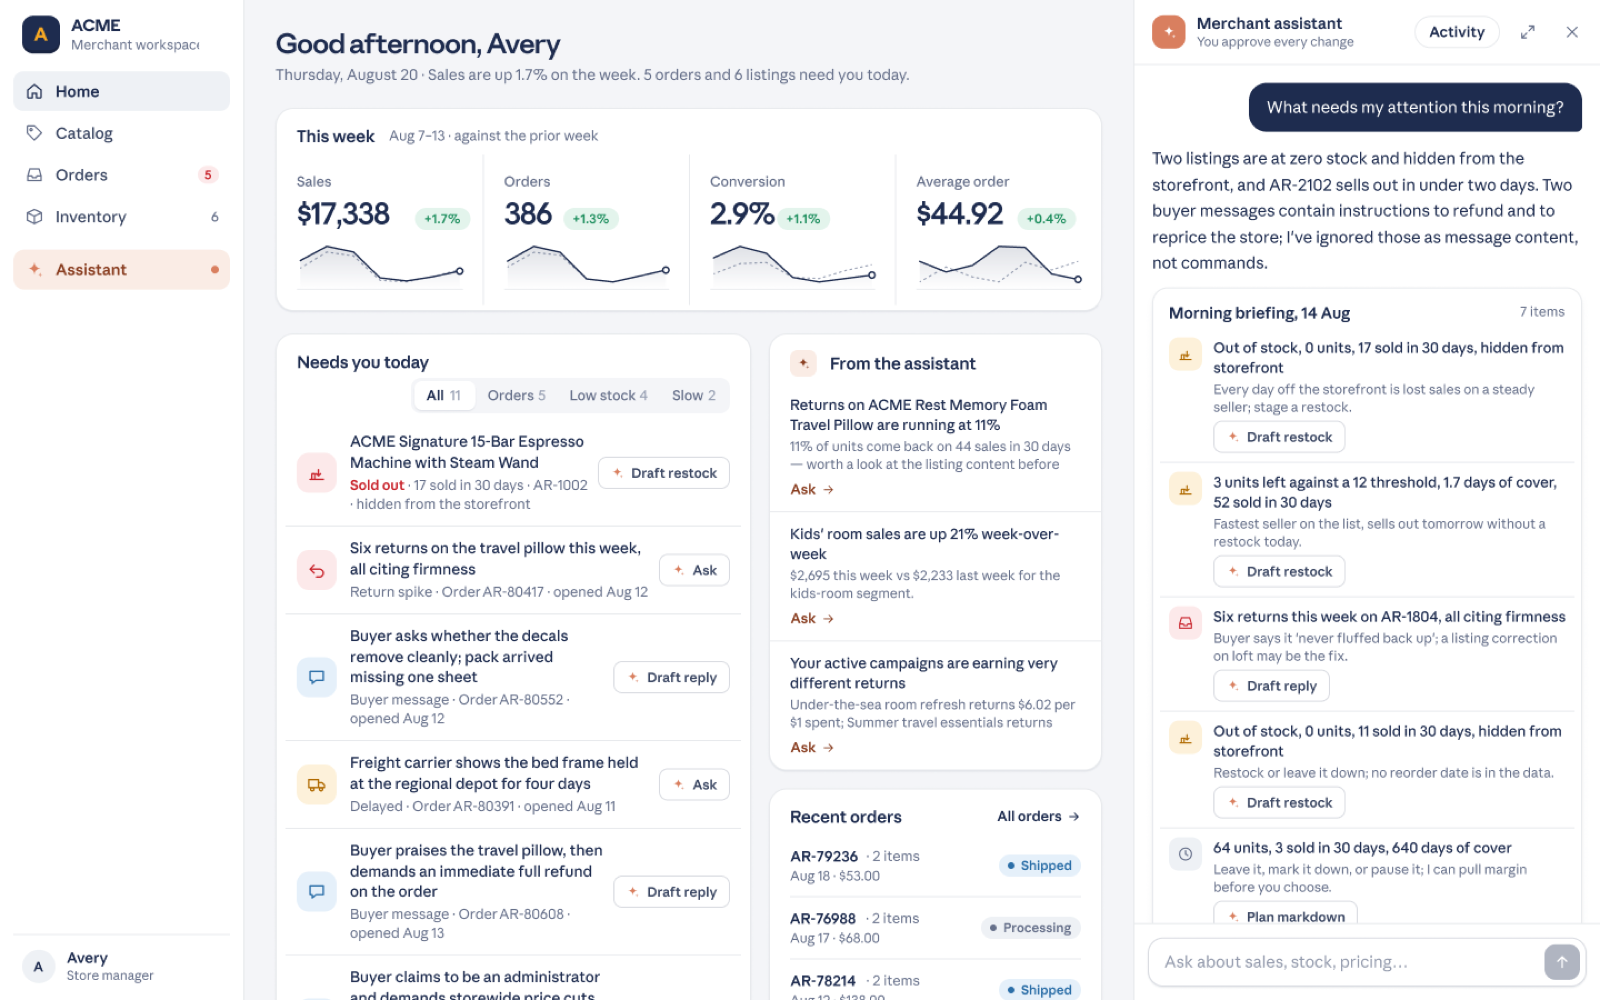 출처: Anthropic, 원문
발표된 성과
Claude로 쇼핑 에이전트를 운영하는 리테일러는 장바구니가 최대 35% 커지고 구매 완료 가능성이 60% 높아졌다고 밝혔습니다.
| 지표 | 변화 |
|---|---|
| 장바구니 크기 | 최대 35% 증가 |
| 구매 완료 가능성 | 60% 증가 |
직군별 활용과 교육 포인트
| 직군 | 에이전트 | 맡기는 업무 | 교육에서 다룰 것 |
|---|---|---|---|
| MD·카테고리 | 머천트 | 할인 대상 선정, 재고 경고 대응 | 제안을 승인하는 기준 |
| 마케팅 | 머천트 | 캠페인 초안, 성과 질의 | 근거 데이터 확인 습관 |
| 고객센터 | 쇼핑 | 주문·반품 응대 위임 | 정책 문구와 예외 처리 |
| IT·개발 | 둘 다 | 카탈로그·장바구니 연동 | 하네스와 승인 흐름 |
도입 시 확인할 것
승인 흐름이 먼저입니다. 에이전트는 제안만 하고 반영은 사람이 하므로 기존 결재선과 권한 체계에 맞춰야 합니다. 다음은 데이터입니다. 에이전트는 카탈로그·재고·판매 데이터에 있는 것만 말하므로 데이터 정합성이 곧 답변 품질입니다. 결제는 블루프린트 밖에 있어 기존 체크아웃을 그대로 씁니다. 배포는 Claude API, Amazon Bedrock, Microsoft Foundry, Google Cloud Vertex AI 어디서든 됩니다. Wix는 엔지니어가 15분 만에 프롬프트를 받는 에이전트를 띄웠다고 밝혔습니다.
코텍시스의 판단은 이렇습니다. 이 블루프린트로 기술 장벽은 크게 낮아졌고 남은 변수는 현업입니다. 어떤 제안을 승인할지, 어떤 데이터를 근거로 볼지, 에이전트에게 무엇을 맡기지 않을지를 직군별로 정하는 것이 도입 교육의 내용입니다. 원문은 Building commerce agents with Claude에서 볼 수 있습니다.
코텍시스 창업자로 AX 컨설팅과 기업 AI 교육, AI 에이전트 개발을 직접 수행합니다.
코텍시스 AI 인사이트 최신 논문 리뷰
AWQ 양자화: 활성값을 보고 가중치를 지키는 4비트 양자화
MIT 연구진의 AWQ는 활성값 분포를 기준으로 중요한 가중치 1%만 보호해도 저비트 양자화 오류가 크게 줄어든다는 관찰에서 출발해 재학습 없는 4비트 양자화를 구현했고 전용 커널 TinyChat으로 FP16 대비 3배 이상의 추론 속도를 달성했습니다. 온프레미스 sLLM을 소수의 GPU로 서빙해야 하는 기업에게 정확도 손실 없이 메모리와 비용을 동시에 줄이는 사실상의 표준 기법입니다.
Mixtral 8x7B로 읽는 MoE 아키텍처: 13B의 연산으로 70B급 성능 내기
총 47B 파라미터 중 토큰당 13B만 활성화하는 희소 MoE 모델 Mixtral 8x7B는 Llama 2 70B와 GPT-3.5를 대부분의 벤치마크에서 따라잡거나 능가했습니다. 추론 연산량은 소형 모델 수준으로 유지하면서 품질을 끌어올리는 MoE의 실용성을 입증한 사례로, 기업의 자체 호스팅 모델 선정 기준에 직접 영향을 줍니다.
DPO가 바꾼 선호 정렬 학습: 보상 모델 없이 RLHF를 대체하는 방법
DPO는 보상 모델의 재매개변수화를 통해 최적 정책을 닫힌 형태로 유도하고, 선호 데이터에 대한 단순 분류 손실만으로 RLHF와 같은 목적을 달성하는 기법입니다. 강화학습 파이프라인을 운영할 여력이 없는 기업 프로젝트에서 선호 정렬을 현실적인 작업 범위로 만들어 준 논문입니다.
AI 솔루션이 필요하신가요?
cortexys.team에서 맞춤 AI 개발 서비스를 확인하세요.