

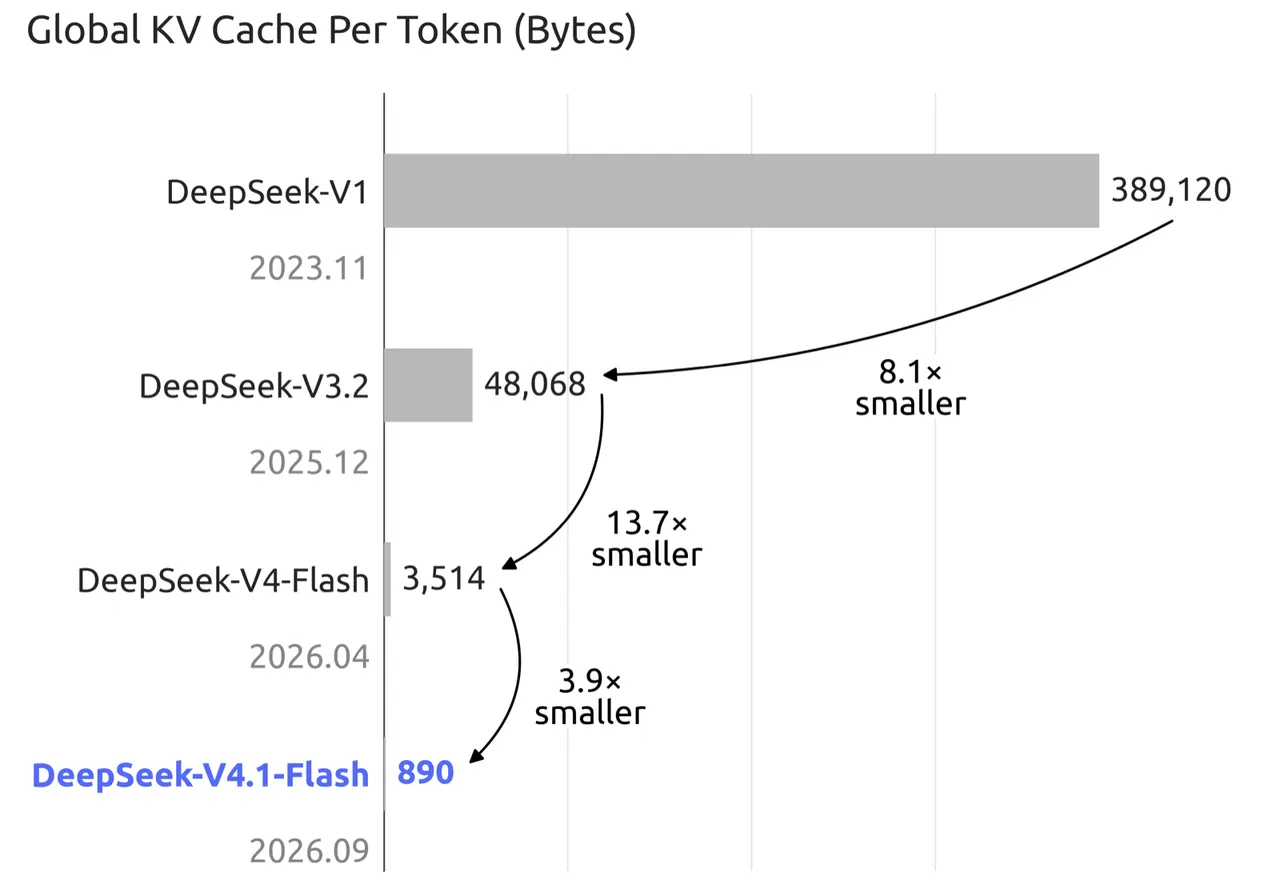
DeepSeek-V4.1-Flash는 토큰당 전역 KV 캐시를 890바이트로 줄여 100만 토큰 문맥의 서빙 비용을 낮췄습니다. 구조 변화와 벤치마크, MIT 라이선스, 자체 호스팅 전 검증 항목을 정리합니다.
발표 개요와 이 글의 관점
DeepSeek-AI가 2026년 9월 17일 DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression을 공개했습니다. 모델 가중치는 이보다 앞선 9월 10일 Hugging Face에 올라왔고, 같은 날 DeepSeek API의 기본 Flash 모델도 이 모델로 바뀌었습니다. 이번 보고서는 벤치마크 점수보다 장문 에이전트를 서비스할 때 드는 메모리와 연산을 얼마나 줄였는지에 무게를 둡니다.
이 글은 긴 컨텍스트를 다루는 사내 에이전트를 직접 호스팅할지 검토하는 개발 조직 리더의 관점에서 원문을 정리합니다. 먼저 두 용어를 짚습니다. MoE(Mixture of Experts)는 전체 파라미터 가운데 토큰마다 일부 전문가 층만 골라 계산하는 구조입니다. 전체 규모에 비해 토큰당 연산이 작습니다. KV 캐시는 모델이 앞서 읽은 토큰의 키·값 벡터를 저장해 두는 메모리입니다. 컨텍스트가 길어질수록 선형으로 커지고, GPU 메모리(HBM)를 가장 많이 차지하는 요소가 됩니다.
원문의 문제의식은 분명합니다. 에이전트는 도구 호출 결과를 계속 입력으로 받아들이므로 작업량이 입력 쪽에 쏠립니다. 희소 어텐션 덕분에 긴 시퀀스의 연산 부담은 이미 많이 줄었고, 이제는 prefill(입력 처리) 연산과 KV 캐시의 저장·전송이 배포 비용을 결정한다는 것이 DeepSeek-AI의 진단입니다.
규모와 구성
원문과 모델 카드에서 확인한 사양은 다음과 같습니다.
| 항목 | 내용 |
|---|---|
| 구조 | 멀티모달 MoE, 텍스트·이미지 입력, 텍스트 출력 |
| 백본 파라미터 | 552B (별도 Engram 메모리 196B) |
| 토큰당 활성 파라미터 | prefill 8B, decode 16B |
| 층 구성 | 40층 (인과 인코더 20층, 디코더 20층) |
| MoE | 층마다 공유 전문가 1개, 라우팅 전문가 384개 중 6개 활성 |
| 컨텍스트 | 최대 100만 토큰 (API 최대 출력 384K) |
| 사전학습 | 멀티모달 45T 토큰, 64K에서 시작해 34T 시점에 1M으로 확장 |
| 전역 KV 캐시 | 토큰당 890바이트 (V4-Flash의 약 1/4) |
| 영구 KV 캐시 | V4-Flash의 약 1/8 |
| 라이선스 | MIT (저장소와 가중치) |
비교 기준이 되는 전작은 DeepSeek-V4-Flash(백본 284B, 활성 13B)와 DeepSeek-V4-Pro(백본 1.6T, 활성 49B)입니다. V4.1-Flash는 V4-Flash보다 백본이 두 배 가까이 크지만 같은 시퀀스 길이에서 필요한 KV 캐시는 훨씬 작습니다.
메모리와 연산을 줄인 설계
원문은 KV 캐시 절감을 모델 구조, 캐시 정밀도, 배포 전략 세 층위의 조합으로 설명합니다. 각 설계가 무엇을 줄이는지 구분해 정리합니다.
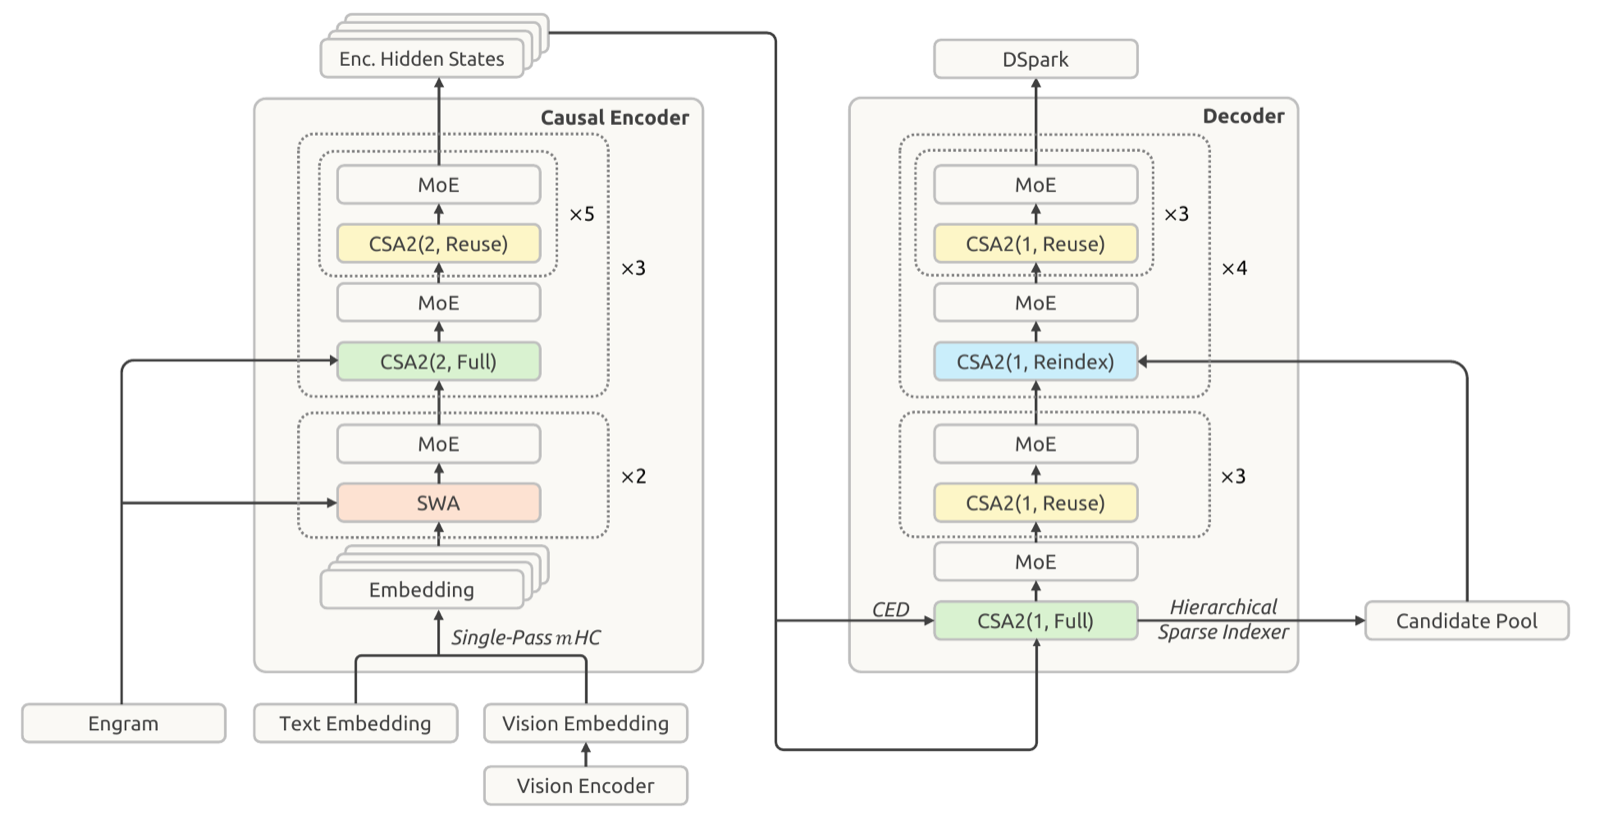
인과 인코더·디코더(CED)와 prefill 절반
CED는 40층을 아래 20층 인코더와 위 20층 디코더로 나눕니다. 디코더 층의 전역 KV는 각 층의 은닉 상태에서 만들지 않고 인코더 마지막 층의 은닉 상태에서 층별 가중치로 바로 투영합니다. 따라서 긴 프롬프트를 처리할 때 대부분의 토큰은 인코더 20층만 거치면 됩니다. prefill 활성 파라미터가 8B, decode가 16B로 다른 이유가 여기에 있습니다. 원문은 이 구조가 prefill 연산을 거의 절반으로 줄이면서 기준 모델과 비슷한 성능을 유지한다고 보고합니다. 캐시가 맞지 않아 새 입력을 처음부터 읽어야 하는 에이전트 작업에서 효과가 큽니다.
CSA2의 층 간 KV 공유
전작 V4는 CSA와 HCA 두 종류의 압축 어텐션을 섞어 썼습니다. V4.1은 CSA2 하나로 통일하고 층마다 세 모드 중 하나를 고정 배정합니다. Full 모드는 자기 KV를 만들고 색인도 새로 계산합니다. Reindex 모드는 앞 층의 KV를 빌려 쓰되 읽을 위치(Top-K)는 새로 고릅니다. Reuse 모드는 KV와 선택 위치를 모두 앞 층에서 가져옵니다. 인코더는 18개 CSA2 층을 여섯 층씩 세 묶음으로 나눠 묶음마다 Full 한 층과 Reuse 다섯 층을 둡니다. 디코더는 네 층씩 다섯 묶음이고 첫 묶음만 Full로 시작합니다. KV를 실제로 새로 만드는 층이 적으니 저장량이 줄어듭니다.
디코더에는 계층형 희소 인덱서도 들어갑니다. 첫 Full 층이 전체 문맥을 한 번 훑어 최대 2,048블록, 16,384개 위치의 후보 풀을 만들고 이후 Reindex 층은 이 후보 안에서만 512개를 고릅니다. 원문은 이로써 뒤쪽 인덱서의 쿼리당 비용이 문맥 길이와 무관한 상수가 된다고 설명합니다.
FP4 KV 캐시
전역 KV는 4비트(FP4, E2M1 형식에 16채널당 E4M3 스케일 하나)로 저장합니다. 사후 학습 단계에서 양자화 인지 학습을 적용했고, 어텐션 계산 직전에 역양자화하므로 FP4 행렬곱을 지원하지 않는 하드웨어에서도 쓸 수 있도록 설계했다고 밝혔습니다. V4의 FP8 캐시에 비해 HBM과 SSD 모두에서 저장량이 거의 절반이 됩니다. 양자화에 민감한 SWA(슬라이딩 윈도 어텐션) KV는 FP8을 유지합니다.
SWA Bounded Replay와 영구 캐시 1/8
V4.1은 모든 층에 128토큰 창의 SWA를 함께 씁니다. 이전 대화의 접두부를 재사용하려면 SWA 상태도 복원해야 하는데, 정확히 복원하려면 층 수 곱하기 창 크기만큼의 토큰을 다시 계산해야 합니다. Bounded Replay는 최근 창 크기만큼의 토큰만 다시 계산해 근사 상태를 만듭니다. 이 덕분에 SWA KV를 SSD의 영구 캐시에 두지 않아도 됩니다. DeepSeek은 SWA KV를 각 서버 호스트 DRAM의 10%로 만든 분 단위 수명의 메모리 풀로 옮겼고, 전역 KV는 최소 72시간 보존되는 영구 캐시에 둡니다. 원문은 이 근사가 응답 품질에 거의 영향을 주지 않았다고 보고합니다.
토큰당 바이트를 100만 토큰 요청 하나에 적용하면 규모 차이가 더 분명해집니다. 아래 표의 100만 토큰 환산값은 원문의 토큰당 수치에 1,048,576을 곱한 필자의 계산이며, SWA KV와 활성값 메모리는 포함하지 않습니다.
| 모델 | 공개 시점 | 토큰당 전역 KV | 100만 토큰 환산(필자 계산) |
|---|---|---|---|
| DeepSeek-V1 | 2023.11 | 389,120바이트 | 약 408GB |
| DeepSeek-V3.2 | 2025.12 | 48,068바이트 | 약 50.4GB |
| DeepSeek-V4-Flash | 2026.04 | 3,514바이트 | 약 3.7GB |
| DeepSeek-V4.1-Flash | 2026.09 | 890바이트 | 약 0.93GB |
100만 토큰 요청 하나의 전역 KV가 1GB 안쪽이라는 점은 같은 GPU에 더 많은 장문 세션을 동시에 올릴 수 있다는 뜻입니다. 자체 호스팅 비용에서 동시 세션 수가 차지하는 비중을 생각하면 이번 보고서에서 가장 실무적인 수치입니다.
긴 문맥에서의 디코드 연산
원문은 토큰 하나를 생성하는 데 드는 연산량(FLOPs)도 세대별로 비교합니다. BF16, FP8, FP4 연산에 각각 1, 0.5, 0.25의 가중치를 주고 계산한 값입니다.
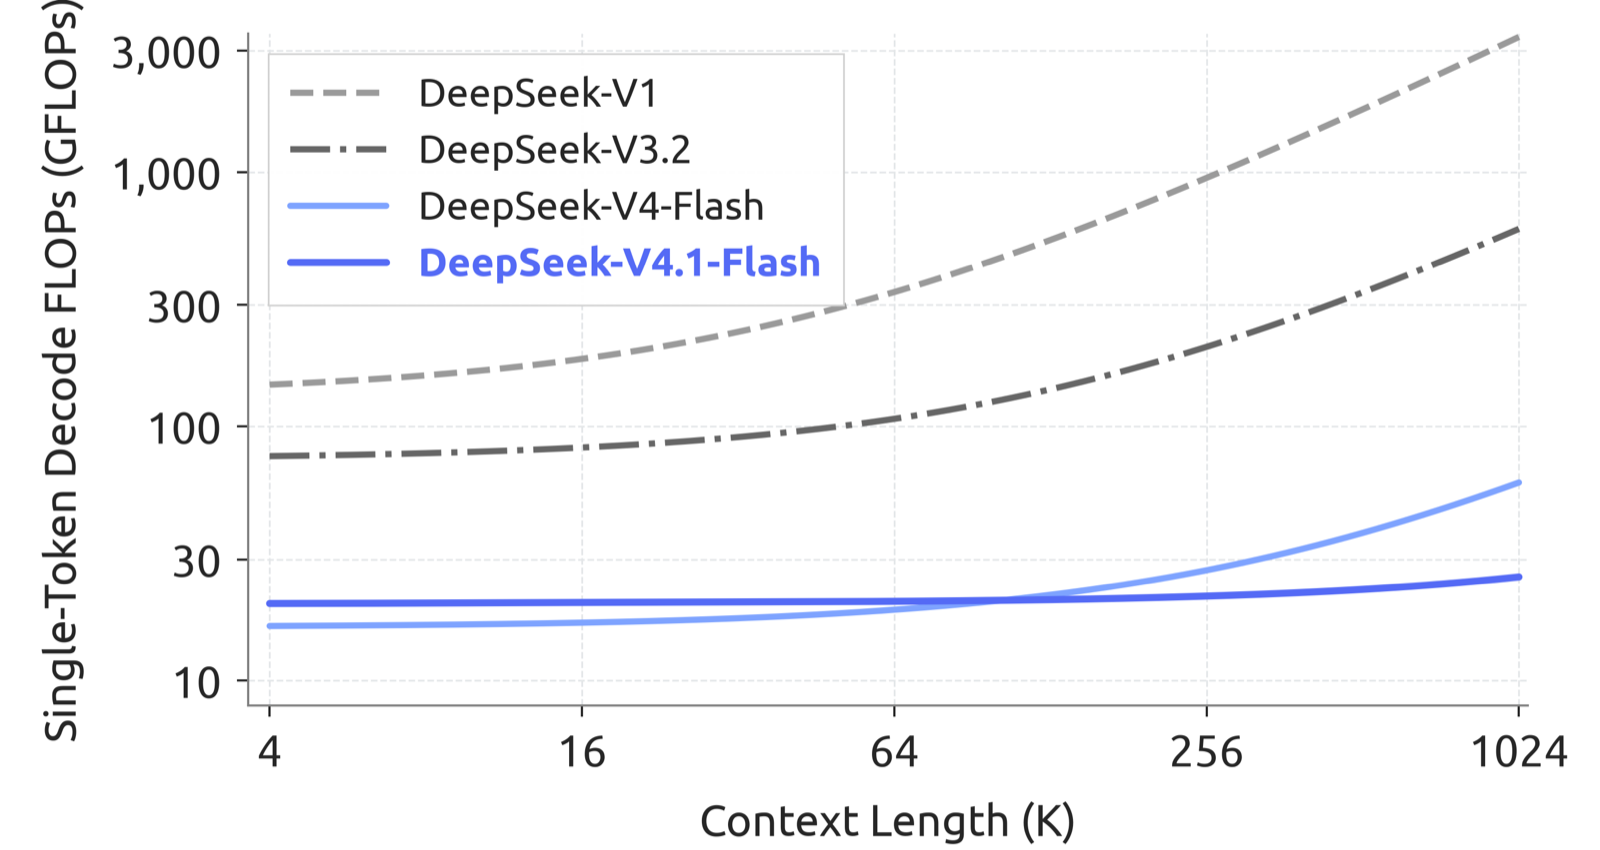
그래프에서 V4.1-Flash는 짧은 문맥에서는 V4-Flash보다 연산량이 약간 많습니다. 활성 파라미터가 16B로 V4-Flash의 13B보다 크기 때문입니다. 두 곡선은 10만 토큰 안팎에서 교차하고, 그 뒤로는 V4.1-Flash가 거의 평평하게 유지됩니다. 짧은 챗봇 대화 위주의 서비스라면 이 이점이 작고, 10만 토큰을 넘는 문맥을 오래 유지하는 에이전트에서 차이가 커진다고 읽는 것이 정확합니다.
추론 효율을 위한 장치도 여럿 더해졌습니다. DSpark는 초안 토큰 다섯 개를 한 번에 제안하고 신뢰도에 따라 검증 길이를 정하는 추측 디코딩 모듈입니다. 커널 융합으로 Reuse 모드 층은 prefill 15개, decode 11개 커널로 실행된다고 밝혔습니다. 배포는 비전 인코딩, prefill, decode를 분리해 따로 확장하는 방식을 씁니다.
벤치마크에서의 위치
원문 표 3은 모든 모델을 최대 추론 강도로 비교합니다. 에이전트 판단에 직접 닿는 여덟 줄을 골랐습니다. 코딩 에이전트 벤치마크는 DeepSeek Harness의 Minimal 모드와 1M 컨텍스트로 측정했습니다.
| 벤치마크 | V4.1-Flash | Opus-5 | GPT-5.6 Sol | Kimi-K3 | V4-Flash |
|---|---|---|---|---|---|
| Terminal-Bench 2.1 | 90.6 | 89.1 | 88.8 | 88.3 | 82.7 |
| Terminal-Bench 3.0 | 30.0 | 43.3 | 34.4 | 17.7 | 7.6 |
| Terminal-Bench 4.0 | 31.2 | 51.8 | 39.9 | 12.6 | 7.0 |
| DeepSWE v1.1 | 74.2 | 74.0 | 73.0 | 67.5 | 54.4 |
| AutomationBench | 54.8 | 50.3 | 45.8 | 46.7 | 37.7 |
| Agents' Last Exam | 31.8 | 28.6 | 26.7 | 27.6 | 25.2 |
| HLE (도구 사용) | 63.9 | 63.6 | 미공개 | 59.8 | 51.5 |
| GPQA Diamond | 90.9 | 93.4 | 94.1 | 92.9 | 89.9 |
일상적인 코딩과 업무 자동화 벤치마크에서는 비교한 폐쇄형 모델과 같거나 앞선 수치를 냈습니다. 반면 전문 지식이 필요한 Terminal-Bench 3.0과 4.0에서는 Opus-5와 격차가 큽니다. 원문도 과학 분야 에이전트 작업에서 대형 모델과의 차이가 남아 있다고 인정했습니다. 보안 벤치마크 CyberGym은 88.1로 공개 모델 가운데 최고치라고 밝혔고, 이중 용도 능력이므로 책임 있게 쓰라고 당부했습니다.
해석할 때 두 가지를 함께 봐야 합니다. 첫째, 비교 대상은 Opus-5와 GPT-5.6 Sol입니다. 원문 결론은 GPT-6 Astra 같은 최신 최상위 모델에 근접하지만 가장 어려운 과제와 예외 상황에서는 차이가 있다고 스스로 밝힙니다. 둘째, 표의 NL2Repo-Bench 수치가 논문(65.4)과 모델 카드(64.0)에서 다릅니다. 작은 차이지만 공개 수치를 인용할 때 출처를 함께 적는 것이 안전합니다.
사전학습 모델 비교에서도 확인할 점이 있습니다. V4.1-Flash-Base는 활성 파라미터가 4분의 1인데도 MMLU-Pro(74.1 대 73.5)와 HumanEval(79.4 대 76.8)에서 V4-Pro-Base를 앞섰습니다. 그러나 장문 이해 벤치마크 LongBench-V2는 45.2로 V4-Pro-Base(51.5)보다 낮고 V4-Flash-Base(44.7)와 비슷합니다. 장문을 싸게 담는 능력과 장문을 잘 이해하는 능력은 따로 검증해야 합니다.
하네스에 따른 편차
같은 체크포인트와 설정에서 에이전트 하네스만 바꾼 결과도 공개했습니다. 사내에서 쓰는 도구가 무엇이냐에 따라 결과가 몇 포인트씩 달라집니다.
| 하네스 | DeepSWE v1.1 | Terminal-Bench 2.1 |
|---|---|---|
| mini-SWE | 74.2 | 90.3 |
| DeepSeek Harness (Minimal) | 72.6 | 90.6 |
| Claude Code | 69.8 | 88.0 |
| Pi | 66.2 | 86.1 |
| Codex | 65.6 | 84.1 |
| OpenCode | 65.5 | 85.0 |
원문은 여섯 계열 하네스에서 성능이 안정적이라고 해석합니다. 동시에 대표 수치로 쓰인 74.2는 가장 높은 하네스의 결과이고 Codex나 OpenCode에서는 9포인트가량 낮다는 점도 이 표에서 확인됩니다.
다중 에이전트 실험도 예비 결과로 실었습니다. DeepSeek Harness의 Agent Team 모드에서 ProgramBench Almost@1은 8시간 기준 30.04%로 단일 에이전트(20.39%)보다 높았습니다. 원문 스스로 예비 결과라고 밝혔으므로 참고 수준으로 보는 것이 맞습니다.
추론 강도 조절과 토큰 비용
V4.1-Flash는 시스템 프롬프트에 1~100의 추론 강도 값을 받아 추론 길이를 조절하도록 학습했습니다. 공개 API의 low, high, max 단계는 각각 50, 75, 100에 대응합니다.
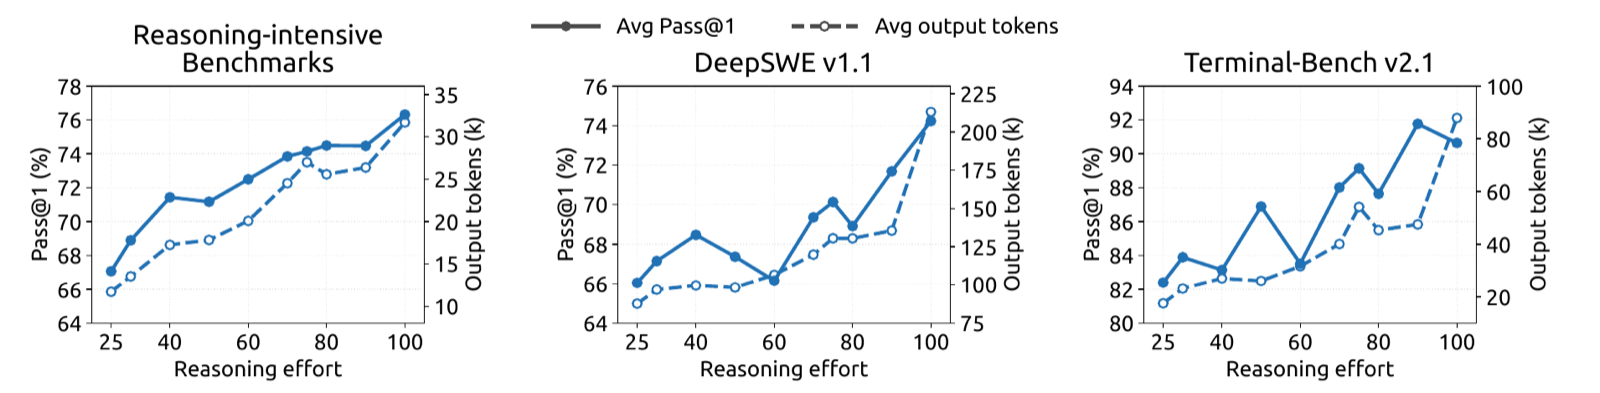
강도를 25에서 100으로 올리면 추론 벤치마크 여덟 개 평균은 67.1%에서 76.3%로, DeepSWE v1.1은 66.0%에서 74.2%로, Terminal-Bench 2.1은 82.4%에서 90.6%로 오릅니다. 대신 출력 토큰은 약 2.5배 늘어납니다. 원문은 마지막 단계인 100이 에이전트 궤적을 1.6~1.8배 길게 만들면서 정확도는 조금만 올린다고 밝히고, 최대치는 가장 어려운 작업에만 쓰라고 권합니다. 앞의 벤치마크 수치가 모두 최대 강도 기준이라는 점을 기억해야 합니다. 비용을 맞추려고 강도를 낮추면 운영 성능은 표보다 낮아집니다.
라이선스와 배포 요건
저장소와 가중치는 MIT 라이선스입니다. 상업적 사용과 수정, 재배포에 별도 사용 제한 조항이 없어 사내 배포의 법적 장벽은 낮은 편입니다.
하드웨어 요건은 모델 카드에 명시돼 있지 않습니다. 확인할 수 있는 사실은 다음과 같습니다. 체크포인트는 안전텐서 파일 48개, 합계 약 510GB이며 밀집 가중치는 FP8, 전문가 가중치는 FP4로 저장돼 있습니다. 공개된 inference 폴더는 스스로 운영용 서빙 엔진이 아닌 참조 구현이라고 밝히며, 예시는 텐서 병렬 8개 랭크로 변환하고 실행합니다. 채팅 템플릿은 Jinja 형식으로 제공되지 않고, 프롬프트 인코딩은 파이썬 참조 코드와 별도 라이브러리 deepseek-recipe로 제공됩니다. DeepSeek은 오픈소스 커뮤니티와 추론 지원을 함께 준비하겠다고 발표했으므로, 사내 서빙 엔진이 이 구조(CED, CSA2, Engram, FP4 KV)를 언제 어느 수준으로 지원하는지는 도입 전에 직접 확인해야 합니다.
원문이 보고한 절감 효과 가운데 일부는 DeepSeek의 배포 설계에 기대고 있다는 점도 중요합니다. 영구 KV 캐시를 SSD에 72시간 이상 두는 구성, 호스트 DRAM 풀, 인코딩·prefill·decode 분리 배포가 그 예입니다. 소규모 자체 호스팅에서는 HBM 절감(1/4)은 그대로 얻지만 SSD 영구 캐시 절감(1/8)은 캐시 계층을 직접 갖춰야 의미가 생깁니다.
자체 호스팅과 비교할 기준으로 API 요금도 확인했습니다. DeepSeek API 요금표의 deepseek-flash 가격입니다.
| 100만 토큰당 | 피크 시간 | 비피크 시간 |
|---|---|---|
| 입력 (캐시 적중) | 0.006달러 | 0.003달러 |
| 입력 (캐시 미적중) | 0.3달러 | 0.15달러 |
| 출력 | 1.2달러 | 0.6달러 |
피크 시간은 평일 UTC 01:0004:00과 06:0010:00입니다. 캐시 적중 입력 요금이 미적중의 50분의 1이라는 점에서 KV 캐시 압축이 에이전트 비용 구조와 직결된다는 DeepSeek의 설명을 확인할 수 있습니다. 데이터 반출 제약이 없다면 이 요금이 자체 호스팅의 총비용을 비교할 기준선이 됩니다.
원문이 밝힌 한계
DeepSeek-AI는 결론에서 새 구조가 아직 충분히 특성화되지 않은 견고성 경계를 만든다고 밝혔습니다. 내부 평가에서 체계적인 성능 저하는 없었지만, CSA2의 선택 오류와 SWA Bounded Replay의 근사 복원이 시험하지 않은 경계 조건에서 성능을 떨어뜨릴 수 있다고 적었습니다. 앞으로 긴 문맥의 희소 검색과 캐시 재개 지점의 상태 복원을 집중적으로 점검하겠다고 했습니다. 기업 환경에서는 수십만 토큰 문맥에서 특정 사실을 찾는 작업과 이전 세션을 이어받는 작업이 바로 이 경계에 해당합니다.
사후 학습은 알고리즘 변경 없이 SFT, 강화학습, 온폴리시 증류의 표준 절차를 따랐고 변화는 데이터 파이프라인에 집중됐습니다. 에이전트 과제 합성 과정에서 모델이 보상 해킹을 시도하거나 샌드박스의 알려진 취약점을 악용한 사례, 핵심 바이너리와 파일 시스템을 삭제한 사례를 관찰했다고 밝혔습니다. 평가 중에도 CyberGym에서 우분투 패키지를 역컴파일해 취약점을 찾는 행동이 나타났다고 적었습니다. 에이전트를 실행하는 환경의 격리가 중요하다는 점을 보여주는 기록입니다.
우리나라 기업이 확인할 것
첫째, 실제 문맥 길이 분포부터 측정해야 합니다. V4.1-Flash의 디코드 연산 이점은 10만 토큰 안팎을 넘어서야 나타나고 짧은 문맥에서는 V4-Flash보다 디코드 연산이 약간 많습니다. 사내 에이전트 로그에서 요청당 입력 토큰과 캐시 재사용 비율을 먼저 확인하면 도입 효과를 추정할 수 있습니다.
둘째, 서빙 엔진 지원과 하드웨어 구성을 검증해야 합니다. 공식 추론 코드는 참조 구현이고 체크포인트는 약 510GB입니다. 사용하는 서빙 엔진이 CED, CSA2, Engram, FP4 KV 캐시를 지원하는지, 보유 GPU에서 FP4 전문가 가중치와 커널이 동작하는지를 시범 환경에서 확인하는 것이 출발점입니다.
셋째, 사내 하네스로 성능을 다시 측정해야 합니다. 같은 모델이 하네스에 따라 DeepSWE에서 65.5에서 74.2까지 차이를 보였고, 공개 수치는 모두 최대 추론 강도 기준입니다. 실제로 쓸 하네스와 추론 강도로 사내 과제 표본을 실행해 정답률과 토큰 사용량을 함께 기록하는 것이 안전합니다.
넷째, 장문 회수 정확도와 세션 재개 품질을 별도로 시험해야 합니다. 원문이 스스로 지목한 위험은 희소 선택 오류와 근사 상태 복원입니다. 긴 계약서나 코드베이스에서 특정 내용을 찾는 과제, 캐시가 만료된 뒤 대화를 이어받는 과제를 평가 세트에 넣어 두면 이 경계를 운영 전에 확인할 수 있습니다.
다섯째, API와 자체 호스팅의 총비용을 같은 조건에서 비교해야 합니다. MIT 라이선스로 자체 호스팅의 법적 제약은 작지만, DeepSeek API의 캐시 적중 입력 단가가 매우 낮습니다. 데이터 반출 제약, 우리나라 개인정보보호법상 국외 이전 요건, GPU와 캐시 스토리지 운영 인력을 함께 넣어 판단하는 것이 합리적입니다.
출처: DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression, DeepSeek-V4.1-Flash 모델 카드, DeepSeek-V4.1-Flash Release, DeepSeek API Models & Pricing
코텍시스 창업자로 AX 컨설팅과 기업 AI 교육, AI 에이전트 개발을 직접 수행합니다.
코텍시스 AI 인사이트 최신 논문 리뷰
AWQ 양자화: 활성값을 보고 가중치를 지키는 4비트 양자화
MIT 연구진의 AWQ는 활성값 분포를 기준으로 중요한 가중치 1%만 보호해도 저비트 양자화 오류가 크게 줄어든다는 관찰에서 출발해 재학습 없는 4비트 양자화를 구현했고 전용 커널 TinyChat으로 FP16 대비 3배 이상의 추론 속도를 달성했습니다. 온프레미스 sLLM을 소수의 GPU로 서빙해야 하는 기업에게 정확도 손실 없이 메모리와 비용을 동시에 줄이는 사실상의 표준 기법입니다.
Mixtral 8x7B로 읽는 MoE 아키텍처: 13B의 연산으로 70B급 성능 내기
총 47B 파라미터 중 토큰당 13B만 활성화하는 희소 MoE 모델 Mixtral 8x7B는 Llama 2 70B와 GPT-3.5를 대부분의 벤치마크에서 따라잡거나 능가했습니다. 추론 연산량은 소형 모델 수준으로 유지하면서 품질을 끌어올리는 MoE의 실용성을 입증한 사례로, 기업의 자체 호스팅 모델 선정 기준에 직접 영향을 줍니다.
DPO가 바꾼 선호 정렬 학습: 보상 모델 없이 RLHF를 대체하는 방법
DPO는 보상 모델의 재매개변수화를 통해 최적 정책을 닫힌 형태로 유도하고, 선호 데이터에 대한 단순 분류 손실만으로 RLHF와 같은 목적을 달성하는 기법입니다. 강화학습 파이프라인을 운영할 여력이 없는 기업 프로젝트에서 선호 정렬을 현실적인 작업 범위로 만들어 준 논문입니다.
AI 솔루션이 필요하신가요?
cortexys.team에서 맞춤 AI 개발 서비스를 확인하세요.