구글이 3.7 Flash와 같은 가격에 코딩·추론 성능을 올린 Gemini 3.8 Flash와 보안 특화 Flash Cyber를 내놓았습니다. 벤치마크 수치와 2027년 정식 가격, 코딩 에이전트 백엔드를 Flash급으로 내릴 때의 판단 기준을 정리했습니다.
구글이 2026년 9월 2일 Introducing Gemini 3.8 Flash and 3.8 Flash Cyber를 발표했습니다. 3.7 Flash 이후 3주 만의 릴리스입니다. 가격은 3.7과 같은 소개 가격인 100만 토큰당 입력 $0.75, 출력 $3.75(2026년 12월 31일까지)를 유지하면서 코딩과 추론 성능을 올렸고, 보안 특화 변형인 Flash Cyber는 새로 만든 Fairwind Program을 통해 검증된 방어 조직에만 제공합니다. 코텍시스는 이를 개발·구축 관점에서 읽습니다. 코딩 에이전트 백엔드를 Flash급 비용으로 내릴 근거가 생겼고, "더 열심히 일한다"는 설명은 작업당 토큰이 늘 수 있다는 뜻이므로 비용 예측 방식도 바꿔야 합니다.
 출처: Google, Introducing Gemini 3.8 Flash and 3.8 Flash Cyber
같은 가격에서 달라진 성능
3.8 Flash는 장기 소프트웨어 엔지니어링(DeepSWE v1.1)에서 입력 단가가 6.7배 비싼 Claude Opus 5와 0.3%p 차이이고, 금융 에이전트 벤치마크에서는 비교 대상 전부를 앞섭니다. 반면 범용 에이전트 능력을 보는 Terminal-bench 4.0과 컴퓨터 사용(OSWorld-2.0)에서는 상위 모델과 격차가 큽니다.
| 벤치마크 | 3.8 Flash | 3.7 Flash | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| DeepSWE v1.1 | 73.7% | 65.3% | 74.0% | 72.7% |
| Vals Finance Agent v2 | 61.4% | 59.0% | 58.6% | 53.8% |
| Terminal-bench 4.0 | 19.1% | 11.2% | 51.8% | 37.3% |
| OSWorld-2.0 | 59.0% | 50.6% | 75.4% | 62.6% |
더 열심히 일하는 모델의 비용
구글은 성능 향상의 핵심을 "3.8 Flash는 더 열심히 일한다"로 설명합니다. 복잡한 작업에서 추론 단계를 더 밟고 도구를 반복 호출하며 높은 effort 수준에서는 토큰을 더 씁니다. 단가가 같아도 작업당 비용은 오를 수 있습니다. 소개 가격은 2026년 12월 31일에 끝나고 2027년부터 입력 $1.50, 출력 $7.50로 두 배가 되므로 연간 예산은 정식 가격으로 잡아야 합니다.
Flash Cyber의 취약점 발견과 패치
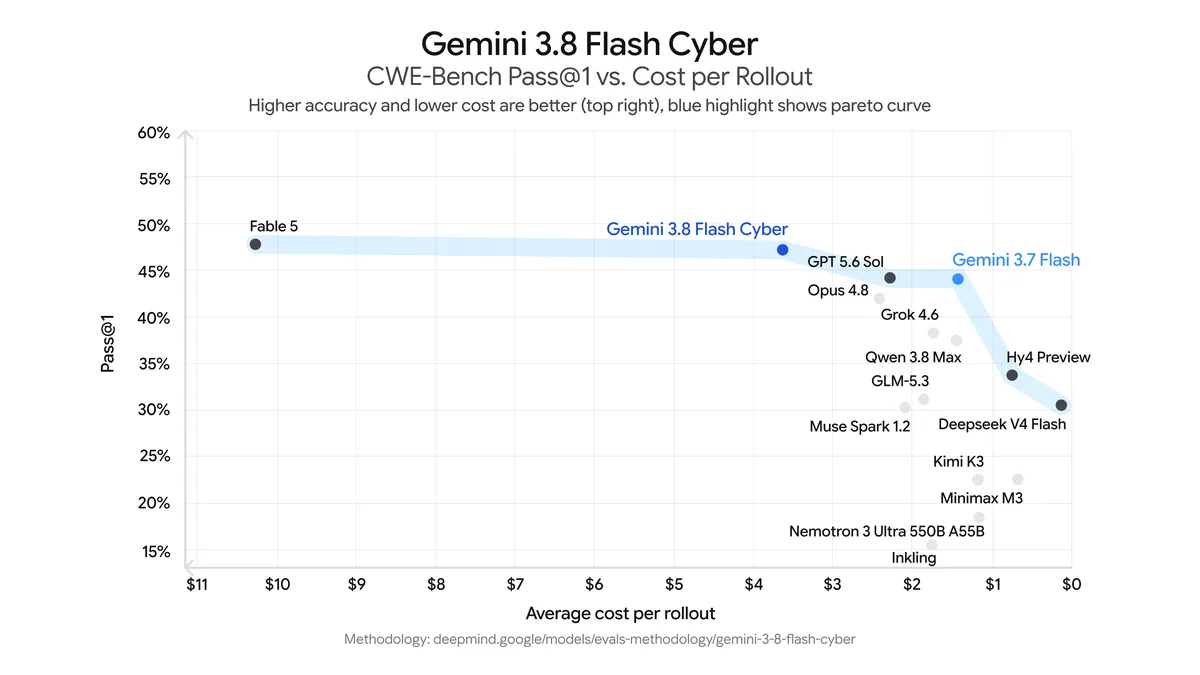
Flash Cyber는 C/C++ 취약점 발견 벤치마크 CyberGym에서 86.2%로 3.5 Flash Cyber(77.5%)와 GPT-5.5-Cyber(85.6%)를 넘었고, 20개 언어를 아우르는 내부 벤치마크에서 70%를 넘는 성공률을 냈습니다. 패치 벤치마크 CWE-Bench에서 pass@1 47.2%로 선두 모델(47.8%)에 근접하면서 롤아웃당 비용은 절반 이하입니다. Chrome 보안팀은 훨씬 큰 상용 모델보다 2.6배 많은 정확한 패치를 얻었다고 보고했습니다.
 출처: Google, Introducing Gemini 3.8 Flash and 3.8 Flash Cyber
구축 시 판단 기준
3.8 Flash는 Gemini API와 Antigravity, Gemini Enterprise에서 바로 쓸 수 있고 CBRN·사이버 공격 완화 장치가 기본입니다. Flash Cyber는 완화 수준이 느슨한 대신 Fairwind Program을 통해 신뢰 방어자만 신청할 수 있습니다. 코텍시스의 판단은 두 가지입니다. 코딩 에이전트와 도메인 분석 에이전트는 백엔드를 3.8 Flash로 내려 비용을 비교해 볼 시점이고, 그 실험은 작업당 토큰 사용량을 계측하는 장치를 갖춘 뒤에 해야 합니다. 원문은 Introducing Gemini 3.8 Flash and 3.8 Flash Cyber에서 볼 수 있습니다.
코텍시스 창업자로 AX 컨설팅과 기업 AI 교육, AI 에이전트 개발을 직접 수행합니다.
코텍시스 AI 인사이트 최신 논문 리뷰
AWQ 양자화: 활성값을 보고 가중치를 지키는 4비트 양자화
MIT 연구진의 AWQ는 활성값 분포를 기준으로 중요한 가중치 1%만 보호해도 저비트 양자화 오류가 크게 줄어든다는 관찰에서 출발해 재학습 없는 4비트 양자화를 구현했고 전용 커널 TinyChat으로 FP16 대비 3배 이상의 추론 속도를 달성했습니다. 온프레미스 sLLM을 소수의 GPU로 서빙해야 하는 기업에게 정확도 손실 없이 메모리와 비용을 동시에 줄이는 사실상의 표준 기법입니다.
Mixtral 8x7B로 읽는 MoE 아키텍처: 13B의 연산으로 70B급 성능 내기
총 47B 파라미터 중 토큰당 13B만 활성화하는 희소 MoE 모델 Mixtral 8x7B는 Llama 2 70B와 GPT-3.5를 대부분의 벤치마크에서 따라잡거나 능가했습니다. 추론 연산량은 소형 모델 수준으로 유지하면서 품질을 끌어올리는 MoE의 실용성을 입증한 사례로, 기업의 자체 호스팅 모델 선정 기준에 직접 영향을 줍니다.
DPO가 바꾼 선호 정렬 학습: 보상 모델 없이 RLHF를 대체하는 방법
DPO는 보상 모델의 재매개변수화를 통해 최적 정책을 닫힌 형태로 유도하고, 선호 데이터에 대한 단순 분류 손실만으로 RLHF와 같은 목적을 달성하는 기법입니다. 강화학습 파이프라인을 운영할 여력이 없는 기업 프로젝트에서 선호 정렬을 현실적인 작업 범위로 만들어 준 논문입니다.
AI 솔루션이 필요하신가요?
cortexys.team에서 맞춤 AI 개발 서비스를 확인하세요.