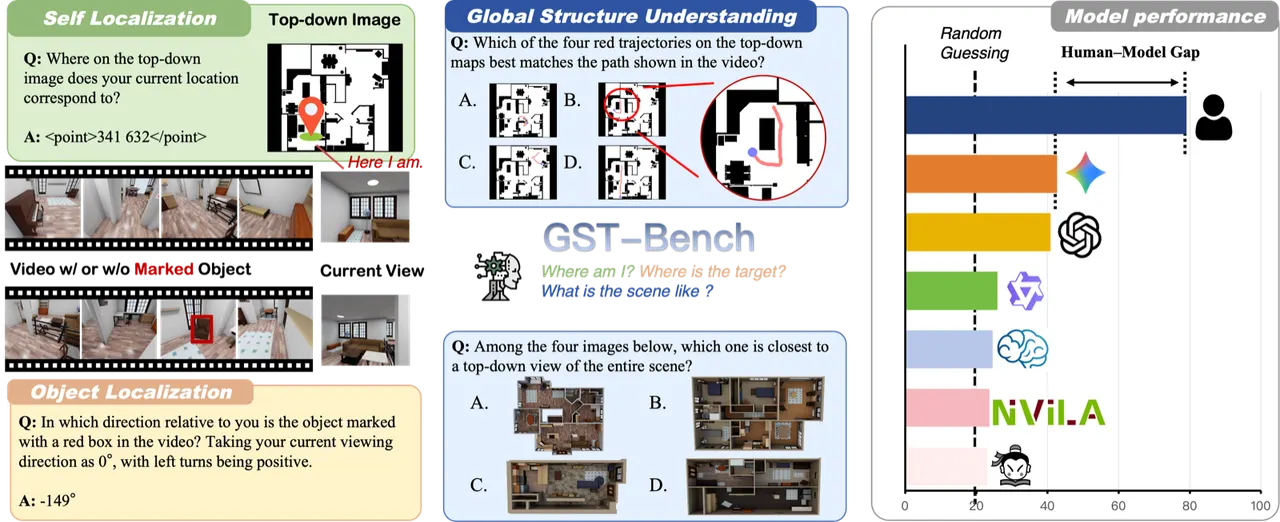
최신 VLM 22개를 영상 기반 전역 공간 인지로 평가했더니 최고 점수가 42.68점이었습니다. 사람은 79.08점입니다. 국소 공간 이해는 되지만 전체를 하나의 지도로 합치지 못한다는 것이 원인입니다.
2026년 8월 6일 공개된 GST-Bench는 시각 언어 모델이 영상을 보고 공간을 얼마나 이해하는지 측정합니다. 결과는 분명합니다. 아직 못 합니다.
무엇을 측정하는가
기존 공간 인지 벤치마크는 한 장 또는 몇 장의 이미지에서 국소적인 공간 관계를 묻습니다. GST-Bench는 다르게 묻습니다. 연속된 긴 영상을 보고 전체 공간을 파악했는지를 봅니다.
구체적으로 두 가지를 요구합니다.
| 요구 사항 | 내용 |
|---|---|
| 새로운 시점 추론 | 입력 영상에 나오지 않은 시점에서의 공간 관계를 추론합니다 |
| 좌표계 변환 | 1인칭 관찰을 전역 조감도 위에 매핑합니다 |
데이터는 합성 영상 6,790분 분량에서 뽑았고 사람이 검증했습니다.
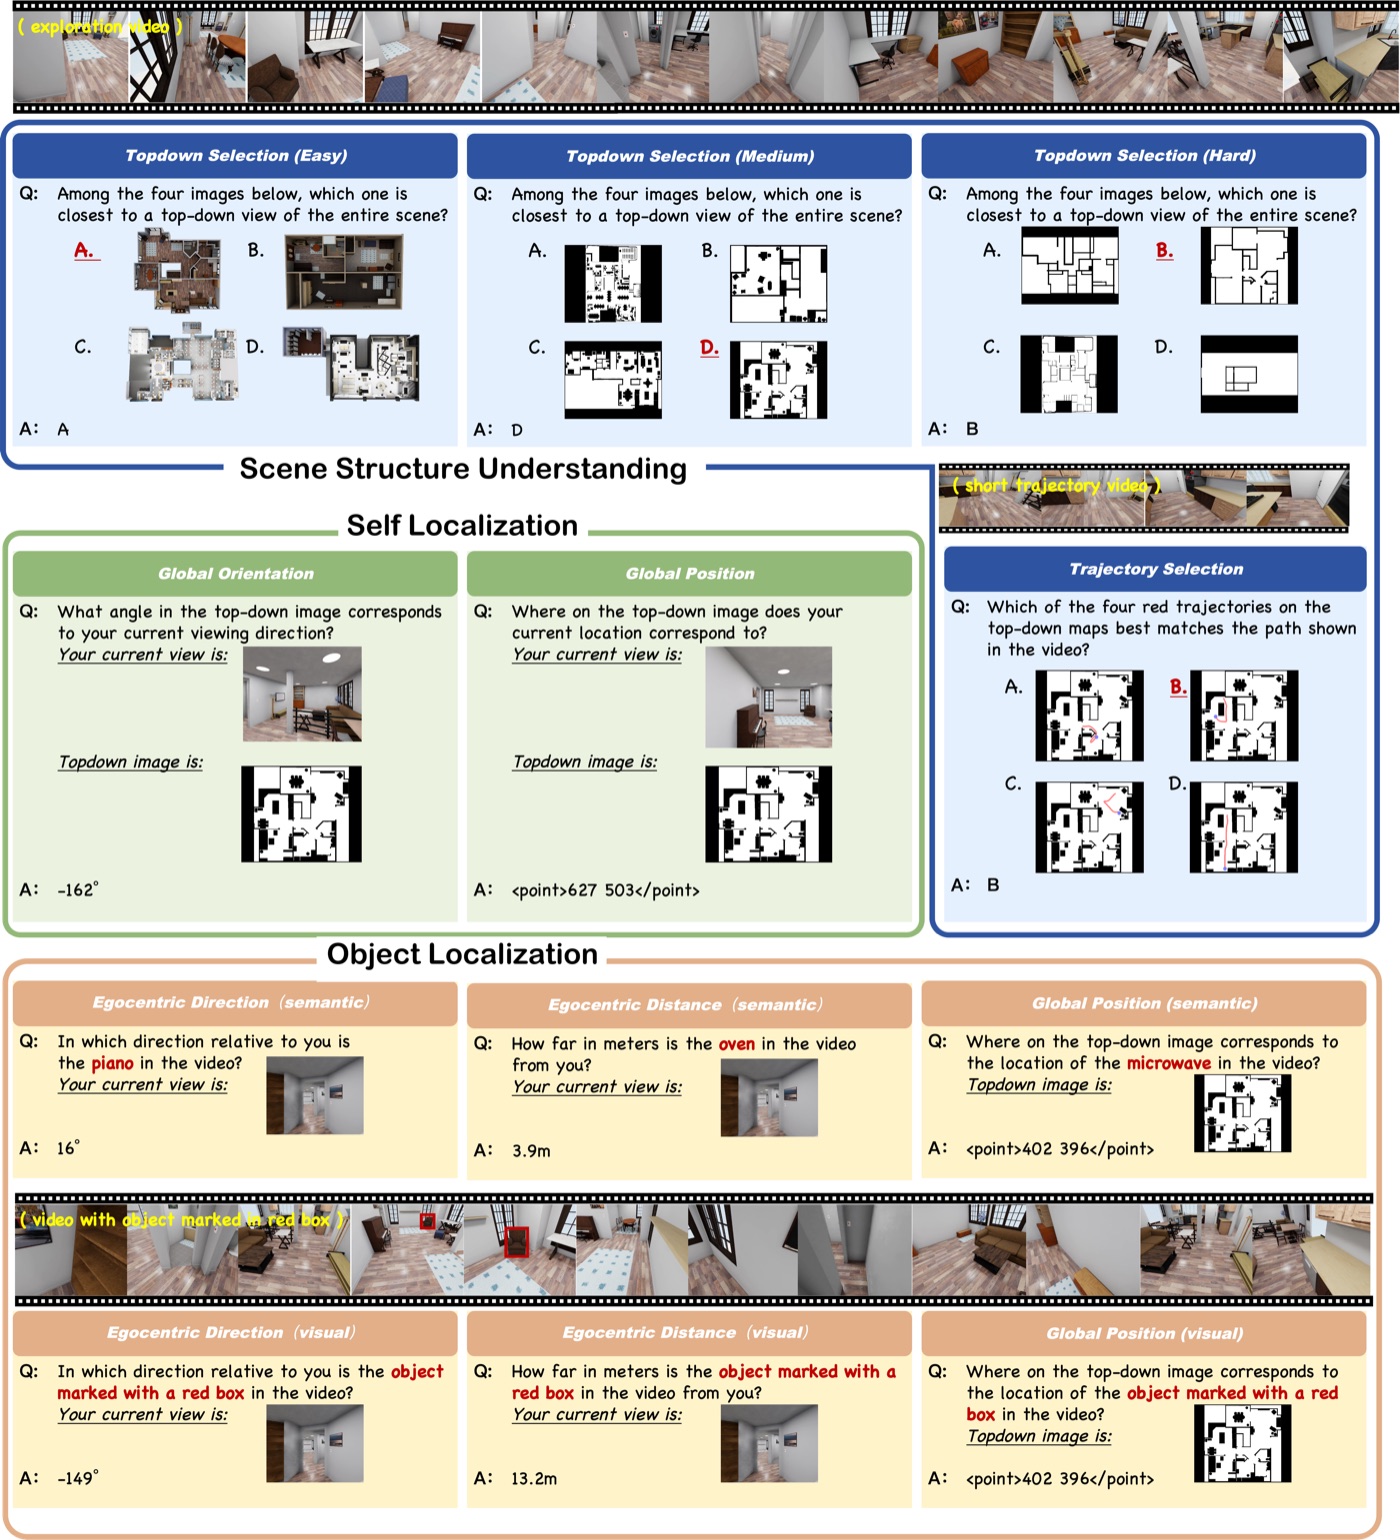 출처: GST-Bench 논문 (arXiv:2608.05747)
결과
최신 VLM 22개를 평가한 결과입니다.
| 대상 | 점수 |
|---|---|
| 가장 강한 제로샷 모델 | 42.68 |
| 사람 | 79.08 |
거의 두 배 차이입니다.
원인이 흥미롭다
논문은 원인을 확인하기 위해 GST-Bench-Local을 따로 만들었습니다. 같은 형식으로 국소 공간 이해만 묻는 버전입니다.
여기서 모델들은 좋은 성적을 냅니다. 즉 개별 장면의 공간 관계는 이해합니다. 그런데도 전역 과제에서 무너지는 이유는, 논문의 표현대로 "장시간 관찰을 전역적으로 일관된 장면 표현으로 통합"하지 못하기 때문입니다.
부분은 보는데 전체 지도를 그리지 못한다는 뜻입니다.
제조 현장 관점에서
이 결과는 산업 현장에 VLM을 적용할 때 직접적인 시사점이 있습니다.
고정 카메라로 한 지점을 보는 검사 작업은 국소 공간 인지에 가깝습니다. 이 영역은 이미 실용 수준입니다. 저희가 수행한 컴퓨터 비전 기반 공정 자동화 PoC도 여기에 해당합니다.
반면 이동하는 카메라로 설비 전체를 순회하며 배치를 파악하거나, 작업자 시점 영상에서 공간 흐름을 이해하는 과제는 이 벤치마크가 지적한 약점에 정면으로 부딪힙니다. 데모에서 잘 되던 것이 현장에서 무너지는 지점이 대체로 여기입니다.
적용 범위를 정할 때 국소 인지로 풀 수 있는 문제인지 전역 인지가 필요한 문제인지 먼저 구분하는 편이 안전합니다.
논문은 후속 연구용 학습 데이터셋 GST-Train도 함께 공개했습니다.
출처: GST-Bench: Can VLMs Develop Global Spatial Awareness from Video? (arXiv:2608.05747, 2026-08-06)
코텍시스 창업자로 AX 컨설팅과 기업 AI 교육, AI 에이전트 개발을 직접 수행합니다.
코텍시스 AI 인사이트 최신 논문 리뷰
MultiHop-RAG: 멀티홉 질의 앞에서 무너지는 RAG를 측정하다
여러 문서의 증거를 모아 추론해야 답할 수 있는 멀티홉 질의에서 기존 RAG는 GPT-4를 써도 정답률이 절반 수준에 그칩니다. 이를 체계적으로 측정한 벤치마크 MultiHop-RAG를 구축한 논문으로, 단일 검색 한 번으로 설계된 시스템의 한계를 미리 알고 보완해야 함을 보여줍니다.
깃허브 이슈로 코드 에이전트를 시험하는 SWE-bench
SWE-bench는 12개 파이썬 오픈소스 저장소의 실제 깃허브 이슈 2,294건을 언어 모델이 해결할 수 있는지 테스트로 검증하는 벤치마크로, 발표 당시 최고 모델의 해결률은 1.96%에 그쳤습니다. 이후 코드 에이전트 경쟁의 표준 척도가 된 이 벤치마크는 개발 업무 자동화의 성숙도를 기업이 수치로 추적할 수 있게 해줍니다.
에이전트에게 진짜 컴퓨터를 쥐여준 벤치마크, OSWorld
OSWorld는 Ubuntu와 Windows 등 실제 운영체제 위에서 369개 과업으로 멀티모달 에이전트를 평가하는 최초의 확장 가능한 실컴퓨터 벤치마크로, 사람은 72.36%를 해내는 과업을 최고 모델이 12.24%밖에 완수하지 못함을 보였습니다. 화면을 보고 업무 프로그램을 조작하는 자동화를 검토하는 기업에게 현재 기술의 위치와 도입 시 안전장치의 필요성을 알려주는 기준선입니다.