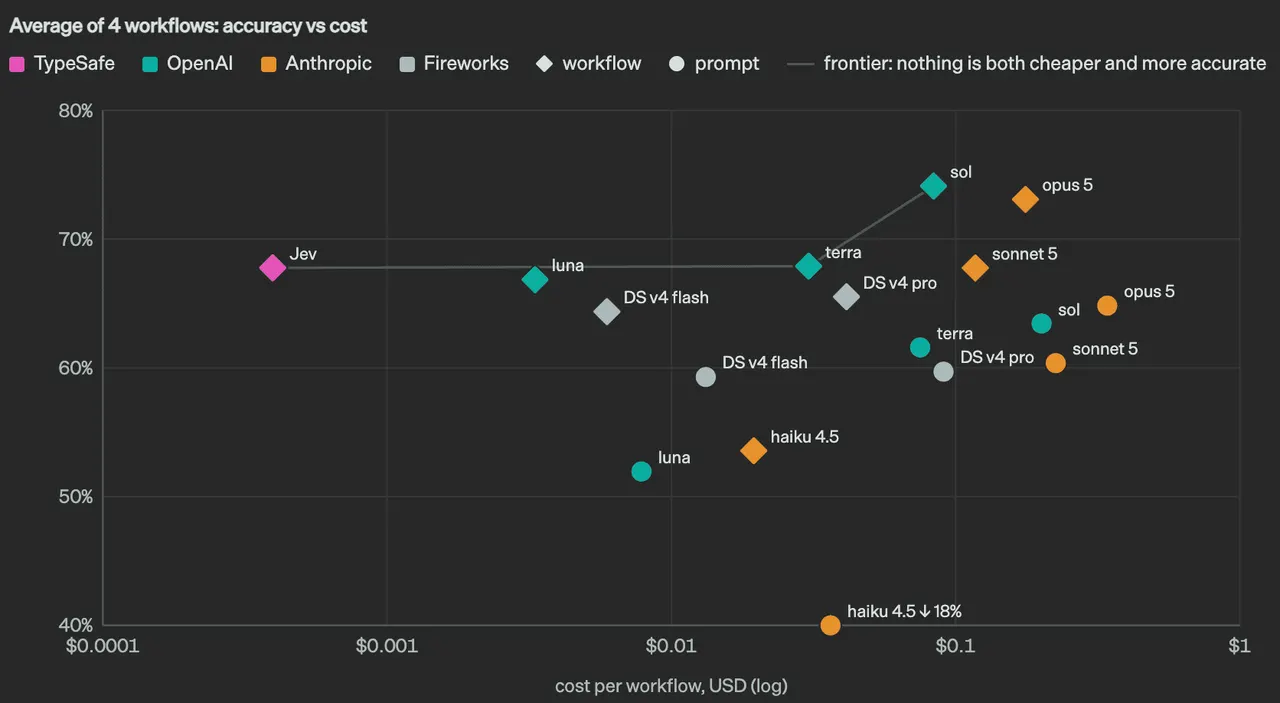
TypeSafe AI의 System One 판단 모델 Jev가 무엇을 돌려주는지, 문의 분류·환불 요청 분류·LLM 출력 검증 같은 판단 단계에 어떻게 붙이는지 공식 문서 기준으로 정리합니다. Next.js 라우트 핸들러 예제, 가격과 컨텍스트 한도, 한국어와 산술·날짜 같은 공식 약점, LLM과 나눠 쓰는 기준을 함께 다룹니다.
Jev는 TypeSafe AI가 2026년 9월 15일 얼리 액세스로 공개한 판단 전용 모델입니다. 문장을 생성하지 않고 미리 정한 선택지, 점수, 참거짓 확률을 돌려주며 선택지와 점수에는 신뢰도가 붙습니다. TypeSafe 공식 문서와 OpenRouter·Vercel 모델 페이지(2026-10-17 확인)를 기준으로 바이브코딩 앱의 어디에 Jev를 넣을지 정리합니다.
핵심 요약
- Jev는 상태(state)와 타입이 정해진 질문(questions)을 받아 질문마다 구조화된 답을 돌려줍니다. 텍스트 생성, 코드 작성, 대화는 하지 않습니다.
- 질문 유형은 Choice(선택지 중 하나), Score(순서 있는 등급), Noul(참일 확률 0~1)이 기본이고 이미지 영역을 찾는 Box는 실험 기능입니다.
- 입력 100만 토큰당 0.042달러이고 출력 토큰은 과금하지 않습니다(TypeSafe Models 문서).
- 공식 문서는 영어 정확도가 가장 높고 한국어를 포함한 CJK는 그보다 낮다고 적습니다. 한국어 문의에는 자기 데이터로 먼저 시험합니다.
- 산술, 날짜 비교, 개수 세기, 이중 부정은 공식 문서가 적은 약점입니다. 환불 금액과 기간 계산은 코드에 둡니다.
Jev가 하는 일
TypeSafe는 Jev를 첫 번째 System One 모델이라고 부릅니다. 이름은 카너먼의 빠르고 직관적인 사고(System 1)에서 왔습니다. 요청 하나에 상태와 여러 질문을 보내면 각 질문을 같은 상태에 대해 병렬로, 서로 독립적으로 평가합니다.
| 질문 유형 | 묻는 것 | 응답 필드 | 제한(공식 문서) |
|---|---|---|---|
| Choice | 선택지 중 어느 것인가 | choice, probabilities, confidence | 선택지 최대 255개 |
| Score | 순서 있는 등급 중 어디인가 | score, legend, probabilities, confidence | 등급 2~10개 |
| Noul | 이 문장이 참인가 | noul(0~1) | confidence 없음 |
| Box(실험) | 이미지 안의 위치 | box의 네 변 좌표 | jev-1.14 전용 |
confidence는 확률 분포에서 계산한 값입니다. Choice라면 1위 선택지 확률이 균등 분배(1/n)보다 얼마나 높은지를 0~1로 나타냅니다. Noul은 0.5에 가까울수록 모델이 확신하지 못한다는 뜻입니다. 문서는 높으면 자동 처리, 중간이면 확인, 낮으면 사람 검토로 나누고 기준값은 작업 위험도별로 정하라고 안내합니다.
입력은 문자열, JSON 객체, 텍스트 배열입니다. 이미지는 TypeSafe-Danger-Zone-Images: true 헤더가 필요한 실험 기능이고 PNG·JPEG만 받습니다. 10월 14일 블로그는 이미지와 긴 컨텍스트를 운영용으로 보증하지 않는다고 밝혔습니다.
바이브코딩 앱 활용처
System One 개념 문서에는 환불 요청 흐름이 예시로 나옵니다. 고객 메시지, 거래 내역, 환불 정책을 상태로 만들고 "환불을 요청했는가", "중복 결제를 뜻하는 근거가 있는가", "정책상 환불 대상인가"를 따로 물은 뒤 코드의 결정적 검사와 합쳐 처리나 검토로 보내는 구조입니다.
| 앱 안의 판단 단계 | 질문 구성 | 코드에 남길 것 |
|---|---|---|
| 문의 분류와 라우팅 | Choice(담당 큐) + Score(긴급도) | 신뢰도 미달 시 사람 검토 |
| 결제·환불 요청 분류 | Noul(환불 요청, 중복 결제 주장) | 금액, 결제 횟수, 청약철회 기간 |
| 사용자 콘텐츠 검수 | Noul 여러 개(욕설, 스팸, 개인정보) | 차단·보류 임계값, 이의 제기 |
| LLM 출력 검증 | Noul(근거 문서가 주장을 뒷받침하는가) | 실패 시 더 큰 모델로 재생성 |
결제 단계에서 Jev는 "무슨 요청인가"만 판단하고, 승인이나 환불 같은 돈이 움직이는 호출은 서버 코드가 PG 조회 결과를 확인한 뒤 수행합니다. 결제 경로는 바이브코딩 결제 연동 가이드에, 점검 항목은 AI가 짠 결제 코드 점검표에 정리했습니다.
Jev는 코딩 에이전트의 LLM을 대신하지 않습니다. 공식 문서는 Claude Code 같은 에이전트가 Jev 호출 코드를 짜게 하라고 안내하며, 이를 위한 스킬은 claude plugin install typesafe@typesafe-ai(마켓플레이스 typesafe-ai/skills 추가 후)로 설치합니다.
호출 경로와 Next.js 예제
| 경로 | 엔드포인트·모델 ID | 키 | 비고 |
|---|---|---|---|
| TypeSafe 직접 | https://api.typesafe.ai/v1/systemone, jev-1.13.0·jev-1.14.0 | TypeSafe 콘솔 키 | 공식 SDK 기본 경로 |
| OpenRouter | https://openrouter.ai/api/v1/systemone, typesafe/jev-1.14·typesafe/jev-1.13 | OpenRouter 키 | 같은 요청 형식, 응답에 usage.cost 추가 |
| Vercel AI Gateway | typesafe-ai/jev, typesafe-ai/jev-1.14.0 | AI Gateway 키 | 예제는 AI SDK experimental_decide, 참거짓 타입 이름이 boolean |
공식 SDK @typesafe-ai/sdk(0.7.0)는 Node.js 22 이상에서 돌고, apiKey·baseURL·defaultModel을 생략하면 TYPESAFE_API_KEY, TYPESAFE_BASE_URL, TYPESAFE_DEFAULT_MODEL 환경변수를 읽습니다. 브라우저 사용은 dangerouslyAllowBrowser 기본값 false로 막혀 있습니다. 아래 예제는 SDK 0.7.0으로 tsc --strict를 통과했습니다.
// app/api/support/triage/route.ts
import { APIError, choice, noul, TypeSafeClient } from "@typesafe-ai/sdk";

const client = new TypeSafeClient({
  apiKey: process.env.TYPESAFE_API_KEY, // 서버 전용 env
  defaultModel: process.env.TYPESAFE_MODEL ?? "jev-1.13.0", // 버전 고정
});

export async function POST(request: Request) {
  const { message } = (await request.json()) as { message: string };

  try {
    const { model, answers } = await client.systemOne({
      // 사용자 입력은 state에만 둔다
      state: { customer_message: message },
      questions: {
        category: choice("Which queue should handle `customer_message`?", {
          refund: "Asks for money back or cancels a paid order",
          payment_failure: "Payment did not go through",
          technical: "Bugs, login, or app errors",
          other: "None of the above",
        }),
        claims_duplicate: noul(
          "Does `customer_message` say the customer was charged more than once?",
        ),
      },
    });

    const c = answers.category;
    return Response.json({
      model,
      route: c.confidence < 0.6 ? "human_review" : c.choice,
      confidence: c.confidence,
      claimsDuplicate: answers.claims_duplicate.noul,
    });
  } catch (err) {
    // 판단이 실패해도 문의 접수는 막지 않는다
    console.error("triage failed", err instanceof APIError ? err.status : 0);
    return Response.json({ route: "human_review" });
  }
}
코드의 규칙은 네 가지입니다.
- 모델은 버전 ID로 고정합니다. Models 문서는 2026-10-17 기준
jev-latest가jev-1.13.0을,jev-preview가jev-1.14.0을 가리킨다고 적고, 10월 14일 블로그는jev-latest를 1주일 뒤 1.14.0으로 옮긴다고 예고했습니다. OpenRouter의~typesafe/jev-latest는 이미 1.14를 가리킵니다. 문서는 신뢰도 기준값을 특정 버전에 맞췄다면 버전 ID를 보내라고 권합니다. - 사용자 문장은
state에만 넣고instructions·criteria는 코드에서 정합니다. jaggedness 문서는 상태 안의 주입 문구가 답을 움직일 수 있다고 적습니다. - 중복 결제 사실은 PG 조회로 확정합니다. Jev는 "고객의 주장 여부"까지만 답합니다. 0.6은 예시값입니다.
- OpenRouter로 바꿀 때는
apiKey에 OpenRouter 키,baseURL에https://openrouter.ai/api, 모델에typesafe/jev-1.13같은 OpenRouter ID를 넣습니다.
SDK는 429와 529(과부하)를 기본 재시도하고 시도당 타임아웃은 기본 10,000ms입니다. 문의 원문이 미국 서비스로 가므로 처리방침의 국외 이전 항목도 확인합니다. Models 문서는 고객 요청·응답으로 학습하지 않는다고 적고 데이터 무보관(ZDR)은 엔터프라이즈 대상으로 안내합니다. 콘솔 조직 설정의 모델 개선 옵트인을 켜면 TypeSafe가 입출력을 읽을 수 있으므로(10월 14일 블로그) 꺼져 있는지 확인합니다.
비용 구조
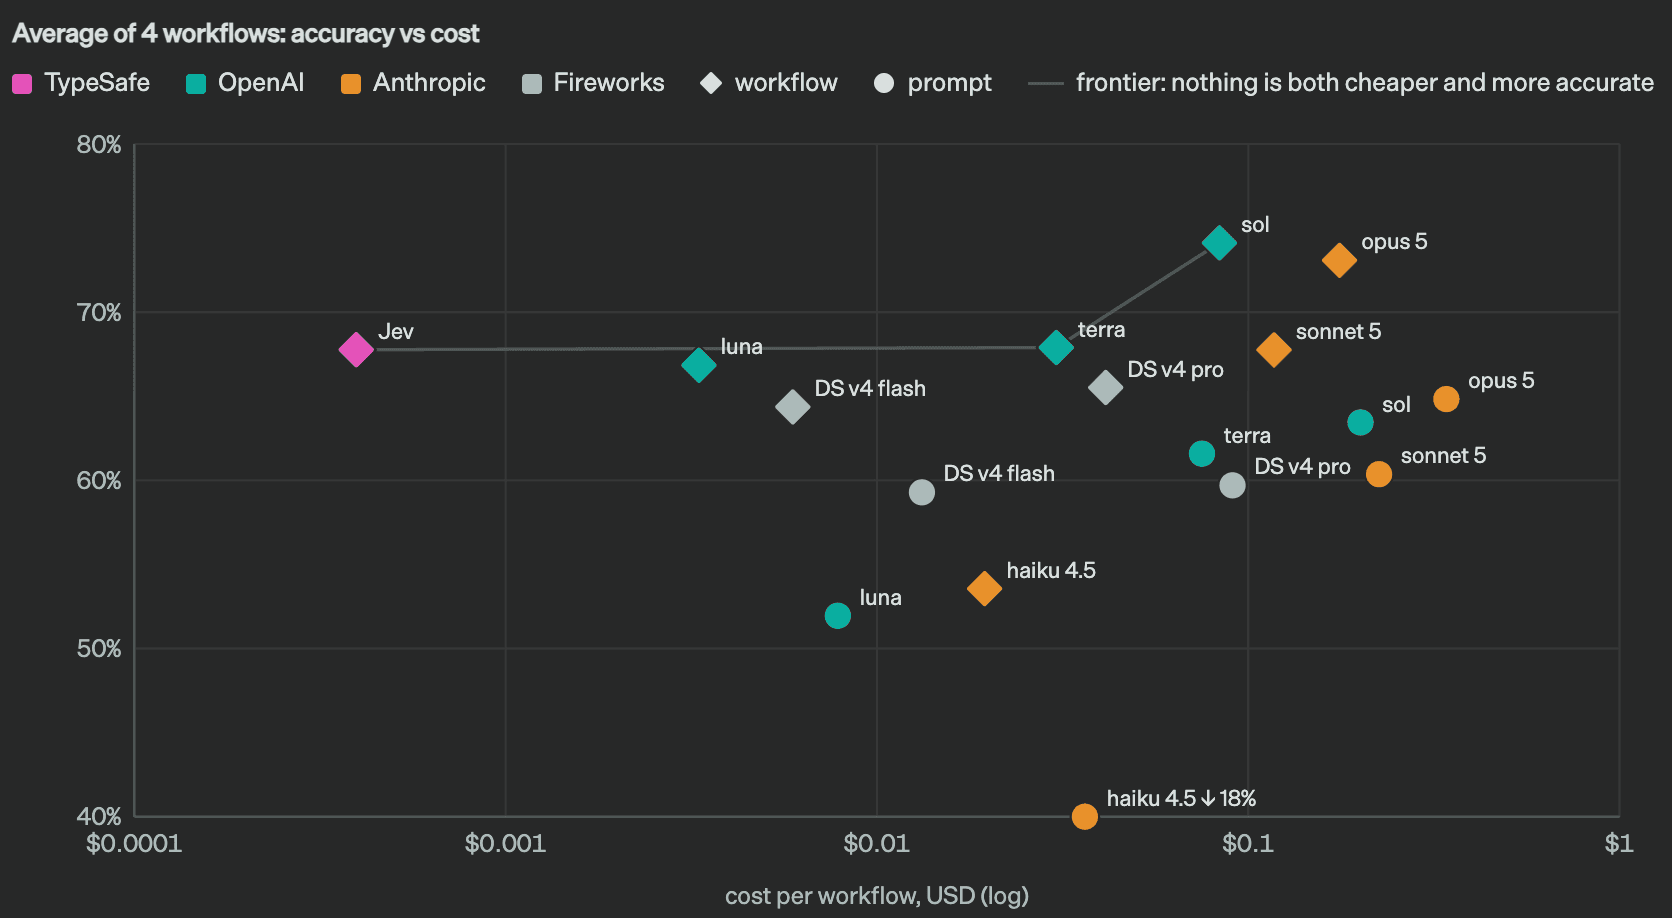
Models 문서(2026-10-17 확인)에 따르면 입력은 100만 토큰당 0.042달러(10억 토큰당 42달러)로 jev-1.13과 1.14가 같고 출력은 과금하지 않습니다. OpenRouter도 같고 Vercel은 0.04달러/M으로 반올림해 표시합니다.
기본 컨텍스트는 요청 전체 64k, 질문 하나(상태 포함) 32k 토큰입니다. TypeSafe-Danger-Zone-Long-Context: true 헤더를 붙이면 둘 다 262k가 되며 단가는 같지만 더 느리고 덜 정확하다고 적혀 있습니다. OpenRouter가 표시하는 262,144토큰은 이 긴 컨텍스트 기준이고, OpenRouter 가이드는 약 32,000바이트를 넘는 텍스트와 이미지 요청을 긴 컨텍스트 모드로 처리한다고 밝힙니다. 같은 문의의 질문은 요청 하나에 모읍니다.
속도와 비용 배수는 TypeSafe AI 발표 기준입니다. 소개 블로그는 응답 시간 70500ms, 같은 System One 작업에서 LLM보다 40200배 빠르다고 적었습니다. 홈페이지의 "193.6배 빠름, 444.6배 저렴"은 자체 워크플로 평가 수치이며, 블로그는 이를 실제 효과의 상한에 가까운 수치로 봅니다. 측정 위치가 미국 서부라 한국 지연 시간은 따로 잽니다.
한계와 대응
공식 jaggedness 문서(jev-1.13 기준, 2026-10-02 검토)의 항목입니다.
| 공식 문서의 약점 | 대응 |
|---|---|
| 문자 그대로 읽기, 부정·범위 표현 | 조건을 정확히 쓰고 경계 사례를 criteria에 적음 |
| 산술, 개수 세기 | 계산은 코드, 개수는 항목별 Noul을 코드에서 합산 |
| 날짜 비교, 기간 판정 | 연·월·일을 Choice로 추출하고 비교는 코드 |
| 여러 단계의 간접 참조 | 질문을 쪼개고 상태 필드 이름을 직접 지목 |
| 관련 없는 내용이 많은 상태 | 코드에서 걸러 필요한 필드만 전달 |
| Choice 선택지 순서 영향 | 순서를 바꿔 답이 같은지 확인 |
Models 문서의 언어 지원 항목에 따르면 영어가 주 학습 언어이고 CJK를 포함한 다른 언어는 처리하지만 정확도가 같지 않으므로 자기 데이터로 시험하고 신뢰도를 주의해서 보라고 적혀 있습니다. 10월 14일 블로그는 jev-1.14의 가장 큰 개선을 다국어 지원으로 예상했습니다. 한국어 정확도 수치는 공식 문서에서 확인하지 못했습니다(2026-10-17 확인).
LLM과 나눠 쓰는 기준
| 상황 | Jev | 생성형 LLM | 코드 |
|---|---|---|---|
| 답의 범위가 정해짐(큐, 등급, 예·아니오) | 적합 | 파싱·검증 필요 | 규칙이 명확하면 코드 |
| 답장, 요약, 설명문 | 불가 | 적합 | 해당 없음 |
| 금액, 기간, 횟수 계산 | 부적합 | 부적합 | 적합 |
| 판단 근거를 글로 남김 | 확률만 반환 | 적합 | 해당 없음 |
| 확신이 낮을 때 멈춤 | 확률·신뢰도로 분기 | 자기 보고에 의존 | 임계값 관리 |
OpenRouter 가이드도 판단은 Jev, 설명문은 채팅 모델, 신뢰도가 낮은 건은 사람이 맡는 분업을 권합니다.
함께 읽을 글
- 바이브코딩 결제 연동 가이드: 국내 PG·해외 MoR 선택 기준
- AI가 짠 결제 코드 점검표: 금액 위변조·시크릿 키·웹훅 검증 8가지
- Claude Code 운영 기준: 루프 설계·같은 과제의 비용 편차·스타트업 다섯 규칙
- 코텍시스 서비스 구축 사업부 · 문의 분류와 결제 흐름 설계가 필요하면 문의하기
자주 묻는 질문
TypeSafe 계정이 꼭 필요한가요?
필수는 아닙니다. OpenRouter 가이드는 대기 목록이나 TypeSafe 계정 없이 OpenRouter 키로 호출할 수 있다고 적고, Vercel AI Gateway 모델 목록에도 올라 있습니다.
한국어 문의 분류에 바로 써도 되나요?
공식 문서가 영어 외 언어의 정확도가 같지 않다고 밝힙니다. 정답 라벨을 붙인 실제 문의로 버전별 정확도와 신뢰도 기준값을 정한 뒤 운영에 넣습니다.
JSON 모드 LLM과 무엇이 다른가요?
Jev는 가능한 답을 요청에서 먼저 정의하고 그 범위 안의 확률 분포를 돌려줍니다. 다만 문서는 보정된 확률이 개별 답의 정답을 보장하지 않는다고 적으므로 신뢰도 분기와 사람 검토 경로는 그대로 둡니다.
환불 승인까지 맡겨도 되나요?
권하지 않습니다. 공식 예제도 Jev의 판단을 코드의 결정적 검사와 합쳐 처리나 검토로 보냅니다. 금액, 청약철회 기간, 중복 결제 사실은 DB와 PG 조회로 확인하고 실행은 서버 코드가 맡습니다.
출처
모두 2026-10-17 접속.
- TypeSafe AI 블로그 Introducing System One Models & Jev(2026-09-15): https://typesafe.ai/blog/introducing-system-one-models-and-jev
- TypeSafe AI 블로그 Jev: For the builders AND dreamers(2026-10-14): https://typesafe.ai/blog/jev-1-14
- TypeSafe AI 홈페이지: https://typesafe.ai/
- TypeSafe Docs Quick start·System One·Jev with coding agents: https://docs.typesafe.ai/introduction/quickstart
- TypeSafe Docs Models: https://docs.typesafe.ai/models
- TypeSafe Docs API reference: https://docs.typesafe.ai/api
- TypeSafe Docs Confidence·Choice: https://docs.typesafe.ai/confidence, https://docs.typesafe.ai/primitives/choice
- TypeSafe Docs Jev 1.13 jaggedness: https://docs.typesafe.ai/model-jaggedness/jev-1.13
- TypeSafe Docs JavaScript SDK: https://docs.typesafe.ai/sdk/javascript
- OpenRouter Jev Latest 모델 페이지: https://openrouter.ai/~typesafe/jev-latest
- OpenRouter Docs Jev·TypeSafe SDK 가이드: https://openrouter.ai/docs/guides/community/jev
- Vercel AI Gateway Jev 모델 페이지: https://vercel.com/ai-gateway/models/jev
코텍시스 창업자로 AX 컨설팅과 기업 AI 교육, AI 에이전트 개발을 직접 수행합니다.
코텍시스 AI 인사이트 최신 논문 리뷰
토큰당 KV 캐시 크기로 계산하는 온프레미스 동시 처리량
vLLM 논문이 보인 것처럼 LLM 서빙의 동시 처리량은 GPU 메모리에서 가중치를 빼고 남은 공간을 토큰당 KV 캐시 크기로 나눈 값이 정합니다. Qwen3-8B와 Qwen3-32B의 config.json으로 계산하면 80GiB GPU 1장에서 8,192토큰 세션 상한이 57개와 9개로, 가중치 크기 차이 4배보다 큰 6배 이상의 차이가 납니다.
초안 모델로 생성 속도를 높이는 추측 디코딩
Google Research의 추측 디코딩은 작은 초안 모델이 제안한 토큰을 큰 모델이 한 번에 검증하고 확률적 수락 규칙으로 출력 분포를 그대로 유지해, T5-XXL의 생성 속도를 재학습 없이 2배에서 3배 높였습니다. M3 Pro 맥북의 Gemma 4 12B 단일 사용자 실측에서는 초안을 켜면 같은 출력을 유지한 채 생성 속도가 15.3 tok/s에서 33.4 tok/s로 2.18배 올랐습니다.
AWQ 양자화: 활성값을 보고 가중치를 지키는 4비트 양자화
MIT 연구진의 AWQ는 활성값 분포를 기준으로 중요한 가중치 1%만 보호해도 저비트 양자화 오류가 크게 줄어든다는 관찰에서 출발해 재학습 없는 4비트 양자화를 구현했고 전용 커널 TinyChat으로 FP16 대비 3배 이상의 추론 속도를 달성했습니다. 온프레미스 sLLM을 소수의 GPU로 서빙해야 하는 기업에게 정확도 손실 없이 메모리와 비용을 동시에 줄이는 사실상의 표준 기법입니다.