강화학습으로 외부 도구 없이 스스로 코드를 반성하고 수정하는 ReflexiCoder를 분석합니다. 8B 파라미터로 GPT-5.1과 경쟁하며 반성 과정이 오히려 토큰 사용량을 36% 줄이는 역설적인 결과까지 살펴봅니다.
코드 생성 AI의 다음 단계. 스스로 틀린 코드를 고친다
"CompileBot이 빌드 실패 메시지를 보내줘야만 코드를 고칠 수 있다면 진짜 실력인가?"
최근 발표된 ReflexiCoder 논문(Jiang et al., 2026)은 이 질문에 정면으로 맞서는 연구입니다. 외부 실행 환경과 컴파일러와 사람의 피드백 없이 모델 스스로 코드를 반성하고 고치는 능력을 강화학습으로 내재화하는 방법을 제안합니다.
기존 접근법의 한계
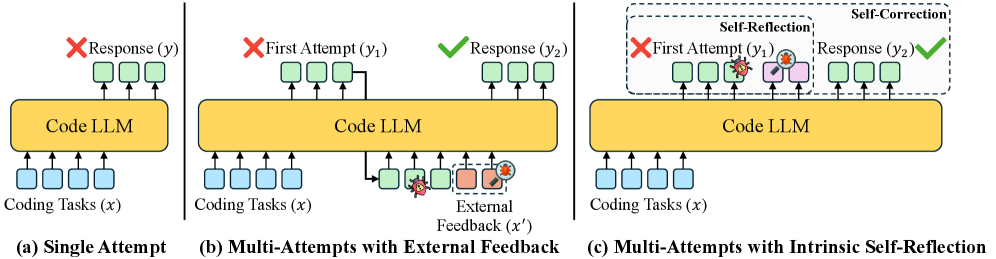
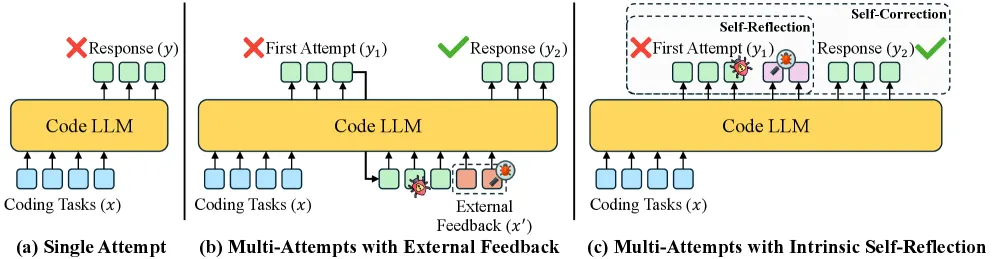
코드 생성 LLM을 개선하는 기존 방법들은 크게 두 가지 패턴을 보입니다.
| 접근 | 방식 | 문제 |
|---|---|---|
| 단일 패스 생성 | 한 번에 코드를 생성하고 종료 | 복잡한 문제에서 실패율이 높음 |
| 외부 피드백 활용 | 컴파일러 실행 결과나 테스트케이스 통과 여부나 사람의 검토 같은 외부 오라클에 의존해 반복 수정 | 배포 환경에서 외부 오라클을 항상 사용할 수 없음 |
두 번째 방법은 성능을 올릴 수 있습니다. 하지만 배포 환경에서 외부 오라클을 항상 사용할 수 없다는 치명적인 한계가 있습니다. 프로덕션 환경에서 매번 코드를 실행해볼 수는 없습니다.
ReflexiCoder는 세 번째 길을 제시합니다. 자기반성 능력 자체를 모델 가중치에 내재화하는 것입니다.
ReflexiCoder의 핵심 아이디어
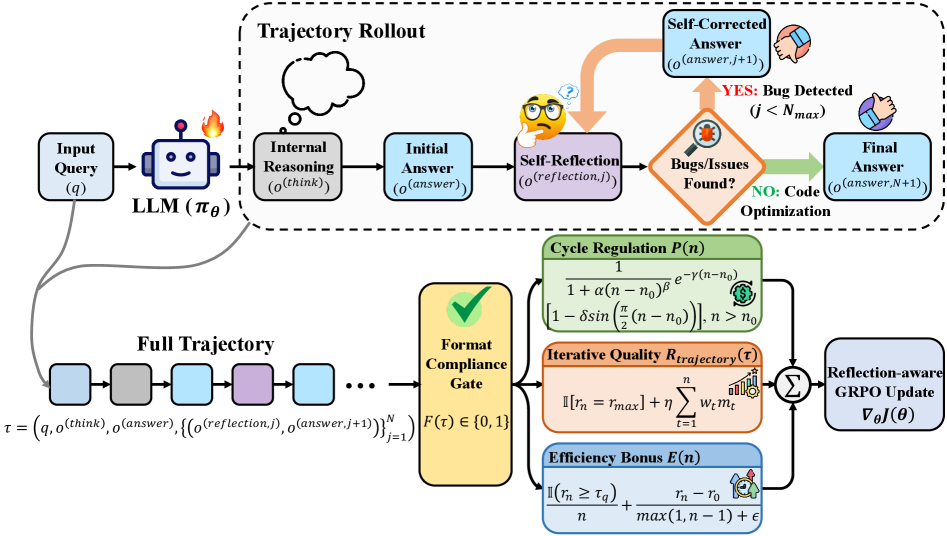
ReflexiCoder는 코드 생성 과정을 구조화된 추론 반성 궤적(trajectory)으로 정의합니다.
$$o^{\text{think}} \rightarrow o^{\text{answer}}_1 \rightarrow o^{\text{reflection}}_1 \rightarrow o^{\text{answer}}_2 \rightarrow \cdots \rightarrow o^{\text{answer}}_n$$
모델은 이 구조를 엄격히 따르도록 학습됩니다. 핵심은 각 단계가 강화학습의 보상으로 최적화된다는 점입니다. 단순히 올바른 출력만 보상하는 게 아니라 반성하는 과정 자체를 보상합니다.
왜 RL이 필요한가
단순 지도 학습(SFT)으로도 자기반성 패턴을 학습시킬 수 있습니다. 하지만 SFT는 외부에서 준 정답 궤적을 따라 하는 것에 불과합니다. RL은 모델이 직접 탐색하면서 최적의 반성 전략을 발견하게 합니다.
복합 보상 함수 설계
논문에서 가장 흥미로운 부분은 보상 함수 설계입니다. 네 가지 컴포넌트로 구성됩니다.
1. 형식 준수 게이팅 $F(\tau)$
형식을 위반한 궤적에 보상 0을 주는 바이너리 게이트입니다. 아무리 코드가 옳아도 형식이 틀리면 학습에 반영하지 않습니다.
이건 단순해 보이지만 강력합니다. 모델이 형식을 무시하고 결과만 맞히는 지름길을 차단합니다.
2. 사이클 수 규제 $P(n)$
최대 $n_0 = 5$회의 반성 사이클은 패널티 없이 허용합니다. 5회 이후부터는 다항 지수 감쇠와 진동 섭동을 적용합니다.
$$P(n) = e^{-\alpha(n-n_0)^\beta} \cdot \bigl(1 + \gamma \cdot \sin(\omega n)\bigr), \quad n > n_0$$
왜 이렇게 복잡하게 설계했을까요. 단순 지수 감쇠를 쓰면 모델이 반성을 아예 포기하거나 반대로 무한 반복하는 패턴으로 붕괴됩니다. 진동 항 $\gamma \cdot \sin(\omega n)$이 이 극단적 수렴을 막습니다.
3. 반복 품질 향상 보상 $R_{\text{trajectory}}$
가장 정교한 컴포넌트입니다. 단순히 최종 정답을 보상하는 게 아니라 반성을 통해 점진적으로 나아지는 궤적을 보상합니다.
| 상황 | 보상 |
|---|---|
| 이전 시도보다 개선 | 지수 가중 보상. 나중 개선일수록 높은 가중치 |
| 정체 | 패널티 |
| 올바른 해에 수렴 | 보너스 |
$$R_{\text{trajectory}} = \sum_{j=1}^{n} e^{\lambda j} \cdot \Delta r_j + \mathbf{1}[r_n \geq \tau_q] \cdot B$$
여기서 $\Delta r_j = r_j - r_{j-1}$은 $j$번째 반성 후의 품질 향상입니다. $B$는 수렴 보너스입니다.
4. 효율 보상 $E(n)$
최소한의 반성 횟수로 최대한 개선하는 것을 보상합니다.
$$E(n) = \frac{\mathbf{1}[r_n \geq \tau_q]}{n} + \frac{r_n - r_0}{\max(1,, n-1) + \varepsilon}$$
최종 보상 공식
$$R_{\text{total}}(\tau) = \mathbf{1}[F(\tau)=1] \cdot P(n) \cdot \bigl(\varphi \cdot R_{\text{trajectory}} + \psi \cdot E(n)\bigr) + \xi \cdot F(\tau)$$
이 설계의 핵심은 형식과 효율과 품질과 점진적 개선 네 가지를 동시에 최적화한다는 것입니다.
Reflection-aware GRPO
최적화 알고리즘으로는 Group Relative Policy Optimization(GRPO)을 반성에 맞게 수정한 버전을 사용합니다.
기존 RL의 가치 함수(value function) 대신 그룹 내 상대적 이점(advantage) 추정을 사용합니다. 같은 문제에 대해 $G$개의 궤적을 샘플링하고 그룹 내 정규화된 보상으로 이점을 추정합니다.
$$\hat{A}i = \frac{R_i - \mu_G}{\sigma_G}, \quad \mu_G = \frac{1}{G}\sum{i=1}^{G} R_i$$
복잡한 코드 생성 같은 대규모 행동 공간에서 이 방식이 더 안정적이라는 게 논문의 주장입니다.
실험 결과
기본 성능 (HumanEval, MBPP 기준)
| 모델 | HumanEval | HumanEval+ | MBPP | MBPP+ |
|---|---|---|---|---|
| Qwen3-8B (베이스) | 89.02% | 80.49% | 70.20% | 59.60% |
| DeepCoder-14B | 94.51% | 85.37% | 77.20% | 66.40% |
| ReflexiCoder-8B (Single) | 94.51% | 87.20% | 81.80% | 69.00% |
| ReflexiCoder-8B (Multiple) | 95.73% | 87.80% | 82.00% | 70.20% |
| GPT-5.1 (참고) | 95.12% | 88.41% | 83.33% | 미공개 |
8B 파라미터 모델이 14B 모델을 능가하고 GPT-5.1과 경쟁적인 성능을 보입니다.
더 어려운 벤치마크
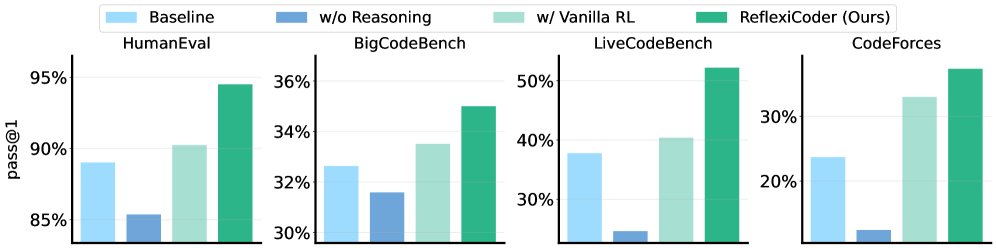
실제 경쟁 프로그래밍 문제인 LiveCodeBench와 알고리즘 대회 문제인 CodeForces에서의 결과입니다.
| 벤치마크 | ReflexiCoder-8B | 비교 기준 | 격차 |
|---|---|---|---|
| LiveCodeBench | 54.12% | DeepCoder-14B-Preview 35.96% | 40% 적은 파라미터로 +18.16%p |
| CodeForces | 37.68% | 베이스 모델 | +13.64%p |
복잡한 문제일수록 자기반성 능력의 차이가 더 크게 드러납니다.
모델 크기별 스케일링
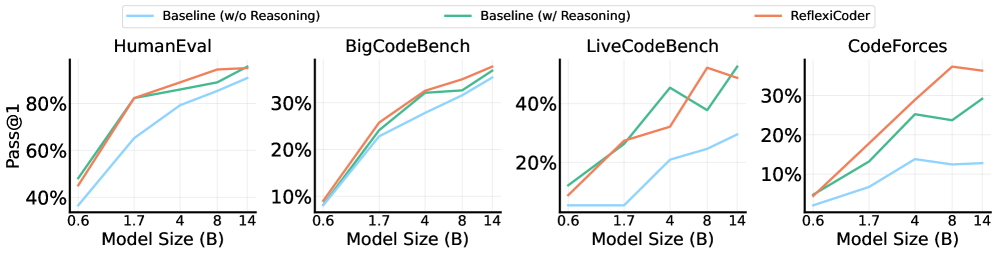
$0.6\text{B}$부터 $14\text{B}$까지 실험한 결과 ReflexiCoder의 성능 향상은 모델 크기와 함께 초선형(super-linear)으로 증가합니다. 큰 모델일수록 자기반성 능력을 더 효과적으로 내재화합니다.
놀라운 발견. 반성이 토큰을 줄인다
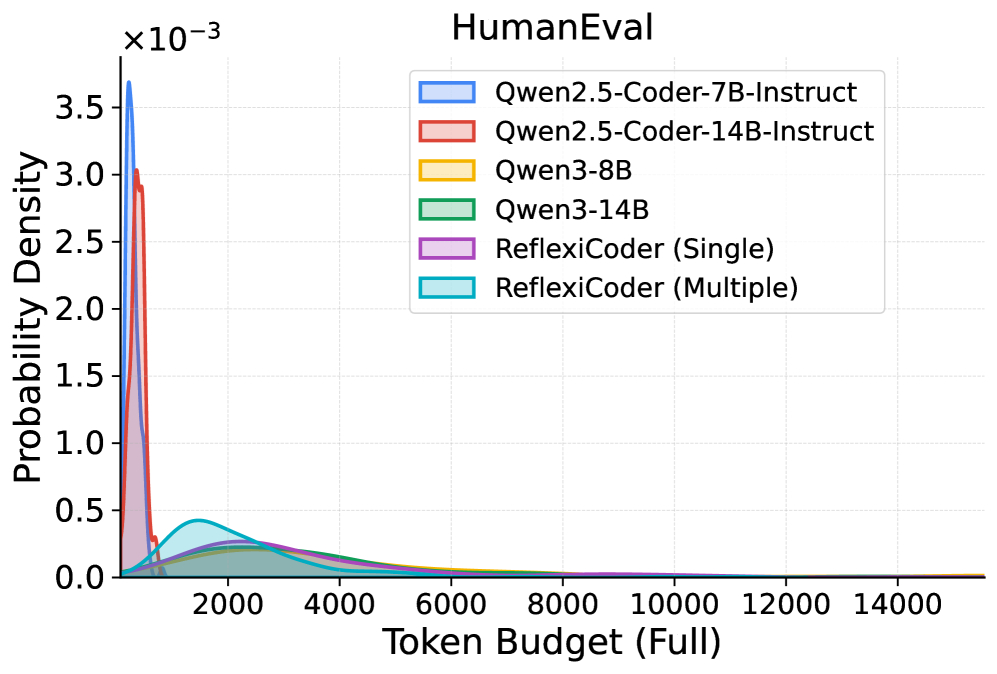
가장 반직관적인 발견입니다. 반성 과정을 추가하면 당연히 토큰이 더 많이 사용될 것 같습니다. 실제로는 반대입니다.
| 모델 | HumanEval 평균 토큰 | BigCodeBench 평균 토큰 |
|---|---|---|
| Qwen3-8B | 약 5,000 이상 | 약 5,000 이상 |
| ReflexiCoder (Single) | 3,455 | 3,477 |
| ReflexiCoder (Multiple) | 2,214 | 2,422 |
반성을 허용한 Multiple 모드가 Single 모드보다 약 36% 적은 토큰을 사용합니다.
왜 이런 결과가 나올까요. 반성 능력을 내재화한 모델은 처음부터 더 신중하게 사고합니다. 불필요한 추론 토큰을 줄이고 핵심에 집중합니다. 논문은 이를 규율 잡힌 추론(disciplined reasoning)이라 부릅니다.
실제로 ReflexiCoder는 약 99.9%의 케이스에서 정확히 $n=1$번의 반성 사이클만 수행하고 종료합니다. 무한히 반복하지 않고 최적 지점에서 멈추는 법을 학습한 것입니다.
어블레이션. 각 보상 컴포넌트의 기여
| 제거된 컴포넌트 | HumanEval 하락폭 |
|---|---|
| 형식 게이팅 $F(\tau)$ 제거 | $-9.76%$p |
| 효율 보상 $E(n)$ 제거 | $-3.05%$p |
| 사이클 규제 $P(n)$ 제거 | $-1.83%$p |
| 점진적 개선 보상 $R_{\text{trajectory}}$ 제거 | $-1.22%$p |
형식 게이팅이 가장 중요합니다. 구조를 강제하지 않으면 모델이 즉각 지름길을 찾습니다.
시사점. AI 코딩 어시스턴트의 미래
이 연구는 AI 코딩 도구의 다음 방향을 시사합니다.
| 시사점 | 내용 |
|---|---|
| 실행 환경 의존성 탈피 | 컴파일러와 런타임과 테스트 환경에 의존하지 않는 자율적 디버깅. 에지 디바이스나 보안이 엄격한 환경에서도 동작 가능 |
| 추론의 내재화 | 외부 도구 호출이 아닌 모델 자체의 인지 능력. CoT와 RL과 자기반성이 결합될 때 단순 합이 아닌 시너지 발생 |
| 효율성의 역설 | 더 많이 생각하면 더 많이 쓴다는 상식을 뒤집음. 잘 훈련된 반성은 오히려 전체 연산량을 줄임 |
| 소형 모델의 가능성 | 8B 파라미터로 14B 모델과 GPT-5.1을 넘보는 성능. 파라미터 수보다 훈련 방식이 더 중요할 수 있음 |
한계
논문도 솔직하게 한계를 인정합니다.
| 한계 | 내용 |
|---|---|
| 단일 파일 중심 | 저장소 수준의 멀티파일 코드베이스에는 적용이 어려움 |
| 알고리즘 중심 | API 설계나 아키텍처 결정 같은 실제 엔지니어링 작업은 별개의 문제 |
| Python 편향 | 주요 벤치마크가 Python 중심이라 다른 언어로의 전이성이 불확실 |
| 싱글 패스 대비 지연 | 어떤 경우에는 여전히 반성 과정이 지연을 추가 |
마치며
ReflexiCoder는 단순한 성능 경쟁을 넘어 AI가 어떻게 오류를 인식하고 수정하는가라는 근본적 질문을 다룹니다.
강화학습으로 자기반성을 내재화한다는 아이디어는 코드 생성을 넘어 다양한 추론 작업에 적용될 수 있습니다. 앞으로의 LLM 연구에서 외부 도구에 의존하지 않는 자율적 오류 수정이 핵심 키워드가 될 것으로 보입니다.
참고 자료
코텍시스 창업자로 AX 컨설팅과 기업 AI 교육, AI 에이전트 개발을 직접 수행합니다.
코텍시스 AI 인사이트 최신 논문 리뷰
검색 전에 질문부터 고쳐 쓰는 RAG
사용자 질문을 검색에 맞게 고쳐 쓰는 재작성 단계를 검색 앞에 추가하면 RAG 성능이 일관되게 개선됩니다. Rewrite-Retrieve-Read 프레임워크를 제안한 이 논문은 소형 재작성 모델을 LLM 리더의 피드백으로 강화학습해, 검색기와 생성기를 그대로 둔 채 QA 성능을 끌어올렸습니다.
언어 모델이 스스로 도구 사용을 배우는 방법, Toolformer
Meta AI의 Toolformer는 언어 모델이 사람의 개입 없이 스스로 API 호출 시점과 인자를 학습하는 자기지도 방식을 제시한 논문입니다. 업무 자동화 에이전트를 도입하려는 기업에게는 도구 호출 능력이 별도의 대규모 수작업 라벨링 없이도 학습될 수 있다는 근거가 되어 사내 시스템 연동 에이전트 설계의 출발점이 됩니다.
토큰당 KV 캐시 크기로 계산하는 온프레미스 동시 처리량
vLLM 논문이 보인 것처럼 LLM 서빙의 동시 처리량은 GPU 메모리에서 가중치를 빼고 남은 공간을 토큰당 KV 캐시 크기로 나눈 값이 정합니다. Qwen3-8B와 Qwen3-32B의 config.json으로 계산하면 80GiB GPU 1장에서 8,192토큰 세션 상한이 57개와 9개로, 가중치 크기 차이 4배보다 큰 6배 이상의 차이가 납니다.