

논문리뷰 글 목록
코텍시스 기술 블로그에서 논문리뷰 태그가 붙은 글 5편을 모았습니다. 기업 AI 도입과 AX 현장에서 확인한 내용을 정리합니다.
글 5편
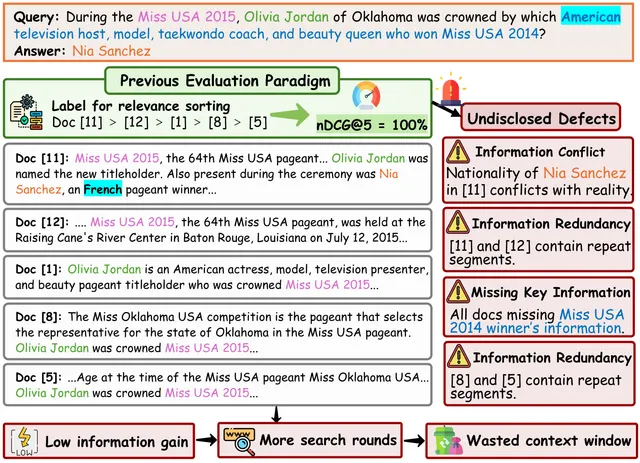
[논문] 문서 세트 품질로 다시 보는 RAG 검색 평가
USTC와 Tencent Yuanbao 팀이 RAG 검색 평가를 개별 문서의 관련성이 아닌 문서 세트 품질로 재정의했다. 최신 리랭커 12종이 세트 차원에서 낙제한 반면 세트 단위 선택은 평균 2.66개 문서만으로 EM을 7.47점 높였다.
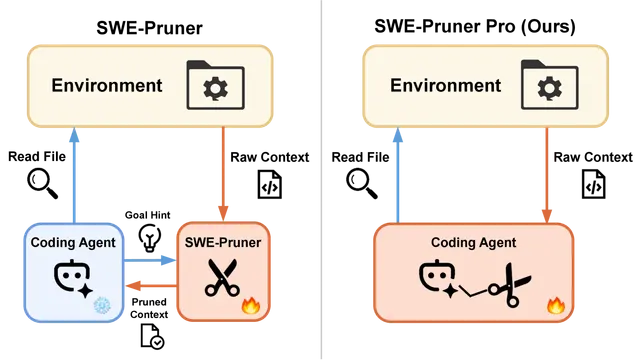
[논문] 코딩 에이전트의 토큰을 최대 39% 줄이는 SWE-Pruner Pro
상하이교통대 연구팀이 발표한 SWE-Pruner Pro는 별도 분류기 없이 백본 LLM의 히든 스테이트를 읽어 도구 출력을 라인 단위로 정리한다. 토큰을 최대 39.4% 절감하면서 SWE-Bench Verified 해결률을 3.8%포인트 끌어올렸다.
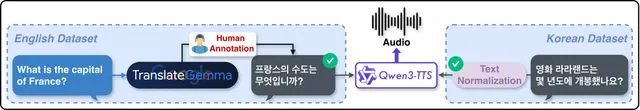
[논문] 한국어 음성 AI를 제대로 평가하는 최초의 종합 벤치마크 KoALa
Qwen3-Omni와 Gemini와 GPT-4o Audio 같은 대형 오디오 언어 모델의 한국어 음성 이해 능력을 평가하는 최초의 종합 벤치마크 KoALa-Bench를 분석한다. ASR과 번역과 질의응답에 더해 음성 모달리티 충실성(SCA-QA)과 위치 인식 장형식 이해(PA-QA)라는 두 가지 새로운 평가 차원을 제시한다.
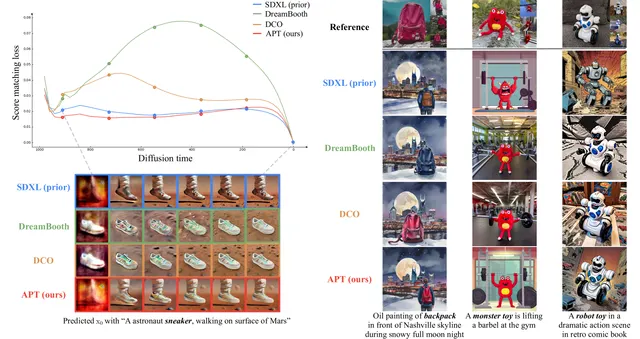
[논문] 데이터가 적을 때 이미지 AI를 제대로 훈련하는 APT 기법
참조 이미지가 몇 장 없을 때 디퓨전 모델이 과적합되는 문제를 세 가지 전략으로 해결하는 APT를 분석한다. 타임스텝별 실시간 과적합 감지(ATA)와 특성 맵 통계 안정화(RS)와 크로스 어텐션 정렬(AA)로 FID를 21% 개선하고 사용자 선호도 56%를 달성했다.
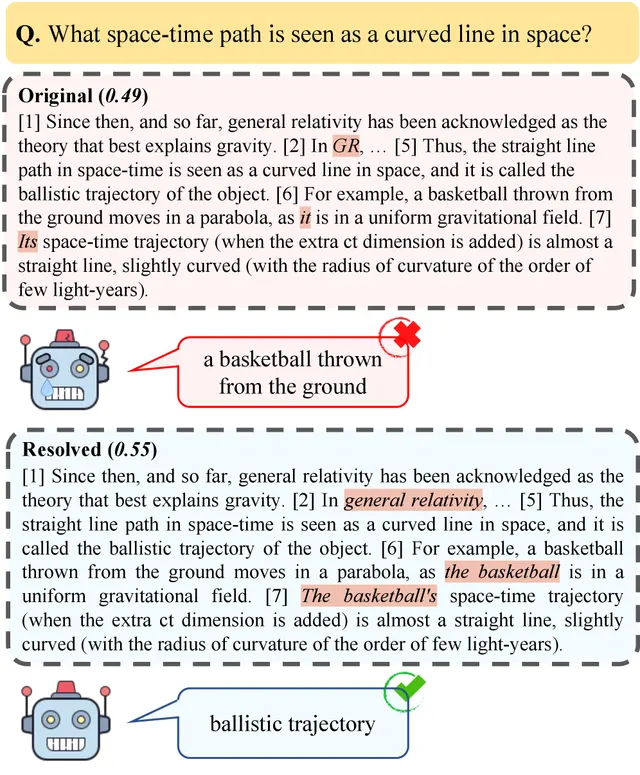
[논문] 코리퍼런스 해소로 RAG 검색 정확도를 높이는 법
RAG 시스템에서 대명사와 지시사로 인한 참조 모호성이 검색과 생성 품질을 떨어뜨린다. 8개 임베딩 모델과 7개 LLM과 4개 데이터셋 실험으로 공지시 해소가 Mean pooling 모델의 검색 성능을 높이고 Qwen2.5-7B의 SQuAD F1을 0.40에서 0.80으로 두 배 끌어올림을 보인다.