

MoE 글 목록
코텍시스 기술 블로그에서 MoE 태그가 붙은 글 4편을 모았습니다. 기업 AI 도입과 AX 현장에서 확인한 내용을 정리합니다.
글 4편
AI
[모델] 2.4조 파라미터를 100만 토큰에, Qwen3.8-Max
알리바바가 8월 3일 Qwen3.8-Max를 공개했습니다. 2.4조 파라미터 MoE에 100만 토큰 컨텍스트, 입력 100만 토큰당 2달러입니다. 성능보다 가격표를 먼저 볼 만한 모델입니다.
Cortexys2026.08.10
AI
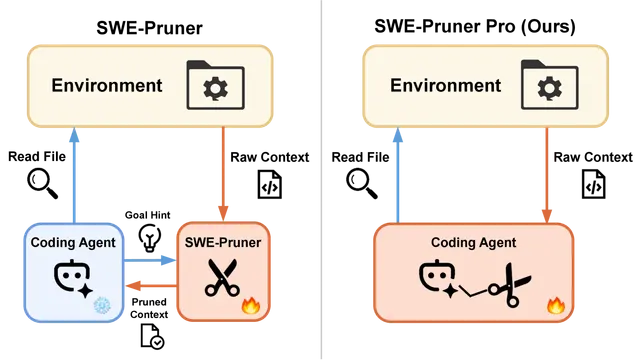
[논문] 코딩 에이전트의 토큰을 최대 39% 줄이는 SWE-Pruner Pro
상하이교통대 연구팀이 발표한 SWE-Pruner Pro는 별도 분류기 없이 백본 LLM의 히든 스테이트를 읽어 도구 출력을 라인 단위로 정리한다. 토큰을 최대 39.4% 절감하면서 SWE-Bench Verified 해결률을 3.8%포인트 끌어올렸다.
Cortexys2026.07.26

AI
[모델] 2.8조 파라미터 오픈웨이트 모델 Kimi K3
Moonshot AI의 Kimi K3는 2.8조 파라미터 스파스 MoE 모델로 역대 최대 오픈웨이트 모델을 표방한다. Frontend Code Arena 1위와 BrowseComp 90.4를 기록하며 클로즈드 프론티어와의 격차를 크게 좁혔다.
Cortexys2026.07.26
AI
[KANANA429] 텍스트와 음성과 이미지를 한 모델로 처리하는 Kanana-o 아키텍처와 서빙 구조
국내 최초로 텍스트와 음성과 이미지를 통합한 멀티모달 모델 Kanana-o의 모델 머징 개발 방법론과 LMSPT 음성 토크나이저와 스트리밍 서빙 최적화를 분석합니다. API를 직접 호출해 수집한 48청크와 TTFA 3.477초의 실측 데이터도 함께 다룹니다.
Cortexys2026.03.24