Google DeepMind 연구원이 설명한 WeatherNext의 사이클론 예측 원리와 허리케인 Melissa 사례를 정리한다. 물리 모델과의 차이, TPU 한 장이라는 추론 비용, 오픈소스 공개가 구축에 갖는 의미를 짚는다.
Google이 2026년 9월 1일 Ask a Scientist: How do researchers use AI to predict a cyclone?를 실었습니다. Google DeepMind 연구원 Ferran Alet가 WeatherNext 모델이 사이클론 예측을 어떻게 바꿨는지 설명한 인터뷰입니다. 코텍시스는 이 글을 연구·구축 관점에서 읽습니다. 계산 비용 구조가 바뀌면 누가 예측을 돌릴 수 있는지가 바뀌고, 모델이 오픈소스로 풀렸으므로 국내 기관도 같은 모델을 직접 검증할 수 있기 때문입니다.
물리 모델과 AI 모델의 차이
기존 예보는 유체역학 방정식을 슈퍼컴퓨터로 시뮬레이션합니다. 전 세계 센서 데이터는 불완전하고 노이즈가 많으며, 정확한 물리 시뮬레이션은 막대한 계산을 요구합니다. 기상학계는 모델 개선과 위성 추가와 컴퓨팅 증설로 10년에 하루씩 예보 범위를 늘려 왔습니다. WeatherNext는 물리 모델이 만든 데이터에 AI를 적용해 한 세대 안에 그 10년치 진전을 냈습니다.
| 항목 | 물리 기반 예보 | WeatherNext |
|---|---|---|
| 계산 자원 | 건물 크기의 슈퍼컴퓨터 | TPU 한 장 |
| 학습 데이터 | 해당 없음 (방정식 시뮬레이션) | 50년치 기상 이력 |
| 강점 | 과거와 현재 상태의 설명 | 패턴에 기반한 미래 예측 |
| 공개 예보 범위 | 5일 | 7일로 확장 추진 |
대표 사례: 허리케인 Melissa
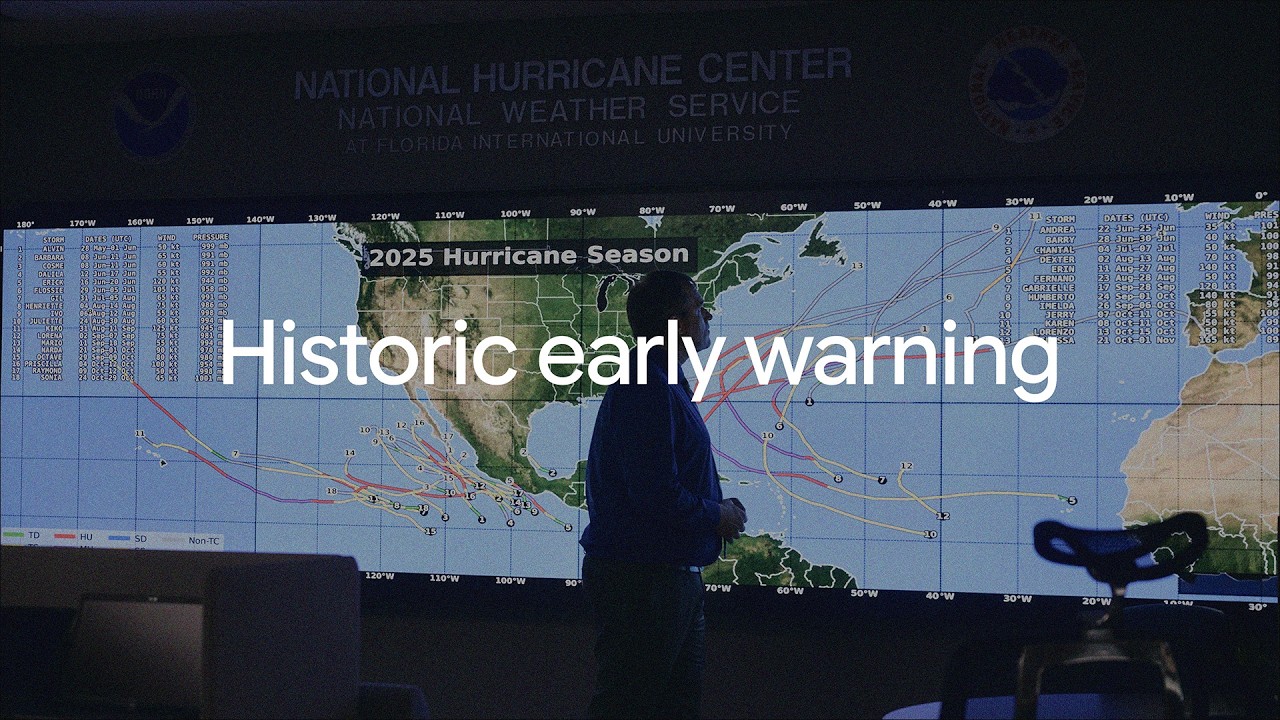
2025년 허리케인 시즌을 앞두고 Google은 미국 국립허리케인센터(NHC)의 예보를 지원했습니다. Melissa는 처음에 약한 폭풍으로 보였지만 AI 모델이 1등급에서 5등급으로 급격히 강해질 것을 높은 확신으로 예측했고, NHC는 이를 근거로 이례적인 조기 예보를 냈습니다. 하루 앞선 경고 덕에 자메이카 당국이 대비 시간을 벌었습니다.
 출처: Google, Ask a Scientist: How do researchers use AI to predict a cyclone?
구축 관점에서 읽는 점
- 추론 비용: TPU 한 장이면 대학과 지방 기관도 자체 앙상블을 돌릴 수 있는 규모입니다. 예측 능력이 국가 기상청 밖으로 퍼집니다.
- 데이터 의존성: 모델은 물리 모델의 출력으로 학습했습니다. 물리 모델 위에 얹는 구조이므로 재분석 데이터 파이프라인은 계속 유지해야 합니다.
- 오픈소스: WeatherNext 2와 WeatherNext Cyclones 모델이 공개됐고 Weather Lab 사이트에서 결과를 볼 수 있습니다. 국내 데이터로 편향을 검증하는 일이 가능합니다.
 출처: Google, Ask a Scientist: How do researchers use AI to predict a cyclone?
코텍시스의 판단
이 사례에서 우리나라 기업이 배울 것은 도메인 데이터 50년치의 가치입니다. 정확도의 원천은 아키텍처보다 축적된 이력 데이터에 있습니다. 제조 설비 이력이나 물류 수요 기록처럼 오래 쌓인 데이터를 가진 조직은 같은 방식으로 자체 예측 모델을 세울 근거를 이미 갖고 있습니다.
원문은 Ask a Scientist: How do researchers use AI to predict a cyclone?에서 볼 수 있습니다.
코텍시스 창업자로 AX 컨설팅과 기업 AI 교육, AI 에이전트 개발을 직접 수행합니다.
코텍시스 AI 인사이트 최신 논문 리뷰
AWQ 양자화: 활성값을 보고 가중치를 지키는 4비트 양자화
MIT 연구진의 AWQ는 활성값 분포를 기준으로 중요한 가중치 1%만 보호해도 저비트 양자화 오류가 크게 줄어든다는 관찰에서 출발해 재학습 없는 4비트 양자화를 구현했고 전용 커널 TinyChat으로 FP16 대비 3배 이상의 추론 속도를 달성했습니다. 온프레미스 sLLM을 소수의 GPU로 서빙해야 하는 기업에게 정확도 손실 없이 메모리와 비용을 동시에 줄이는 사실상의 표준 기법입니다.
Mixtral 8x7B로 읽는 MoE 아키텍처: 13B의 연산으로 70B급 성능 내기
총 47B 파라미터 중 토큰당 13B만 활성화하는 희소 MoE 모델 Mixtral 8x7B는 Llama 2 70B와 GPT-3.5를 대부분의 벤치마크에서 따라잡거나 능가했습니다. 추론 연산량은 소형 모델 수준으로 유지하면서 품질을 끌어올리는 MoE의 실용성을 입증한 사례로, 기업의 자체 호스팅 모델 선정 기준에 직접 영향을 줍니다.
DPO가 바꾼 선호 정렬 학습: 보상 모델 없이 RLHF를 대체하는 방법
DPO는 보상 모델의 재매개변수화를 통해 최적 정책을 닫힌 형태로 유도하고, 선호 데이터에 대한 단순 분류 손실만으로 RLHF와 같은 목적을 달성하는 기법입니다. 강화학습 파이프라인을 운영할 여력이 없는 기업 프로젝트에서 선호 정렬을 현실적인 작업 범위로 만들어 준 논문입니다.
AI 솔루션이 필요하신가요?
cortexys.team에서 맞춤 AI 개발 서비스를 확인하세요.