SpaceXAI가 Grok 4.7을 Grok 4.6과 같은 100만 토큰당 입력 2달러, 출력 6달러에 공개했습니다. 이번 주 GPT-6 Sol, Claude Opus 5.5와 비교한 가격, 벤치마크, 데이터 조건을 정리합니다.
가격을 유지하고 기반 모델을 키운 업데이트
SpaceXAI(xAI)가 2026년 9월 21일 Introducing Grok 4.7을 공개했습니다. SpaceXAI는 Grok 4.7을 코딩과 지식 업무용으로 가장 성능이 높은 자사 모델로 소개하며 Grok 4.6과 같은 가격과 속도로 제공한다고 밝혔습니다. 같은 주에 OpenAI는 9월 22일 GPT-6 Sol과 Luna를 발표했고(코텍시스 정리 글), Anthropic은 같은 날 Claude Opus 5.5를 내놓았습니다. 이 글은 여러 모델을 함께 운영하는 기업의 관점에서 Grok 4.7을 어디에 배치할지 가격, 벤치마크, 제공 채널, 데이터 정책 순서로 정리합니다.
발표에 따르면 Grok 4.7은 Grok 4.6보다 큰 새 기반 모델을 사용합니다. 강화학습은 더 길게 진행했고 과제 구성은 완료에 여러 시간이 걸리는 어려운 문제 쪽에 비중을 두었습니다. SpaceXAI는 모델이 자기 작업을 검증하는 능력과 긴 컨텍스트를 관리하는 능력이 나아졌다고 설명합니다. 자사 에이전트 제품인 Grok Bot의 실행 환경을 모델이 기본으로 이해하도록 학습시켜 대화형 작업과 일반 지식 업무도 개선했다고 밝혔습니다.
파라미터 수는 공식 발표와 개발자 문서 어디에도 없습니다. Yahoo Tech 보도는 Grok 4.7이 2조 1천억 개 파라미터로 Grok 4.6의 1조 5천억 개보다 40% 늘었다고 전했지만 SpaceXAI가 문서로 확인한 수치는 아닙니다. 같은 보도에 따르면 일론 머스크는 출시 며칠 전 Grok 4.7이 Claude Opus 5.0과 대략 같은 수준일 것이라고 기대치를 낮춰 두었습니다.
이번 주 발표된 모델과의 가격 비교
개발자 문서의 API 모델명은 grok-4.7이고 컨텍스트 창은 50만 토큰입니다. 입력은 텍스트와 이미지, 출력은 텍스트이며 지식 기준 시점은 2026년 5월입니다. 추론 노력 수준은 low, medium, high(기본값), xhigh 네 단계입니다. 가격표는 Grok 4.6과 완전히 같습니다.
| 모델 | 입력(100만 토큰) | 출력(100만 토큰) | 캐시 입력 | 발표일 |
|---|---|---|---|---|
| Grok 4.7 (20만 토큰 미만) | $2 | $6 | $0.50 | 9월 21일 |
| Grok 4.7 (20만 토큰 이상) | $4 | $12 | $1 | 9월 21일 |
| GPT-6 Sol | $2 | $10 | 입력가의 10% | 9월 22일 |
| GPT-6 Luna | $0.10 | $0.50 | 입력가의 10% | 9월 22일 |
| Claude Opus 5.5 | $4 | $20 | $0.20 | 9월 22일 |
| Claude Fable 5.1 | $10 | $50 | 미기재 | xAI 발표 표 기준 |
GPT-6 Sol과 Luna의 단가는 OpenAI가 발표한 가격을 앞서 정리한 코텍시스 글에서 옮겼습니다. 입력 단가는 GPT-6 Sol과 같고 출력 단가는 Sol보다 40% 낮습니다. Claude Opus 5.5와 비교하면 입력은 절반, 출력은 30% 수준입니다. 캐시 입력은 Opus 5.5가 $0.20으로 더 쌉니다. Anthropic은 캐시 읽기가 에이전트와 코딩 작업 비용의 대부분을 차지한다고 밝혔으므로 반복 컨텍스트가 큰 작업에서는 표의 기본 단가 차이가 그대로 청구액 차이로 이어지지 않습니다.
기업 예산에 영향을 주는 조건은 네 가지입니다. 첫째, 프롬프트가 20만 토큰에 닿으면 그 요청의 모든 토큰에 두 배 요율이 적용됩니다. 50만 토큰 창을 채워 쓰는 설계라면 $4와 $12를 기준으로 계산해야 합니다. 둘째, 출력 속도가 두 배인 Grok 4.7 Fast는 두 배 가격이며 Cursor와 Grok Build에서만 제공되고 공개 API에는 없습니다. 셋째, grok-4.7은 Batch API를 지원하지 않아 대량 비동기 할인을 받을 수 없습니다. 넷째, 기본 요청 한도는 초당 150건, 분당 5,000만 토큰입니다.
벤치마크 성적
SpaceXAI가 발표에 실은 비교표는 모델마다 추론 노력 수준이 다릅니다. Grok 4.7은 xHigh, Grok 4.6은 High, GPT-5.6 Sol과 Claude Fable 5.1은 Max입니다. OpenAI 쪽 비교 대상은 이전 세대 GPT-5.6 Sol이며 이번 주 나온 GPT-6 Sol과 Claude Opus 5.5는 표에 없습니다. 표의 순위를 이번 주 라인업 전체의 순위로 읽으면 안 됩니다.
| 벤치마크 | Grok 4.7 (xHigh) | Grok 4.6 (High) | GPT-5.6 Sol (Max) | Claude Fable 5.1 (Max) |
|---|---|---|---|---|
| CursorBench 4.0 | 46.3% | 40.4% | 41.7% | 51.8% |
| DeepSWE v1.1 | 71.0% (high) | 65.2% | 72.7% | 70.0% |
| EEBench | 64.0% | 53.0% | 39.4% | 56.4% |
| Terminal-Bench 4.0 | 37.6% | 20.3% | 37.3% | 57.9% |
| Harvey Legal Agent Benchmark | 19.6% | 15.8% | 2.5% | 6.7% |
| HealthBench Professional | 56.7% | 48.5% | 60.5% | 62.1% |
| AA Briefcase v1.1 (Elo) | 1,657 | 1,546 | 1,487 | 1,678 |
코딩에서는 Claude Fable 5.1이 여전히 앞섭니다. CursorBench 4.0은 5.5%포인트, 여러 시간짜리 터미널 작업을 보는 Terminal-Bench 4.0은 20.3%포인트 차이입니다. DeepSWE v1.1은 Grok 4.7이 71.0%로 Fable 5.1보다 높지만 이 수치에는 high 설정에서 측정했다는 단서가 붙었습니다. Grok 4.7이 앞선 영역은 전기공학(EEBench 64.0%)과 법률 에이전트 과제(Harvey 19.6%)입니다. 다만 EEBench에서도 별도 차트의 GPT-6 Astra(max)는 69.3%로 더 높습니다.
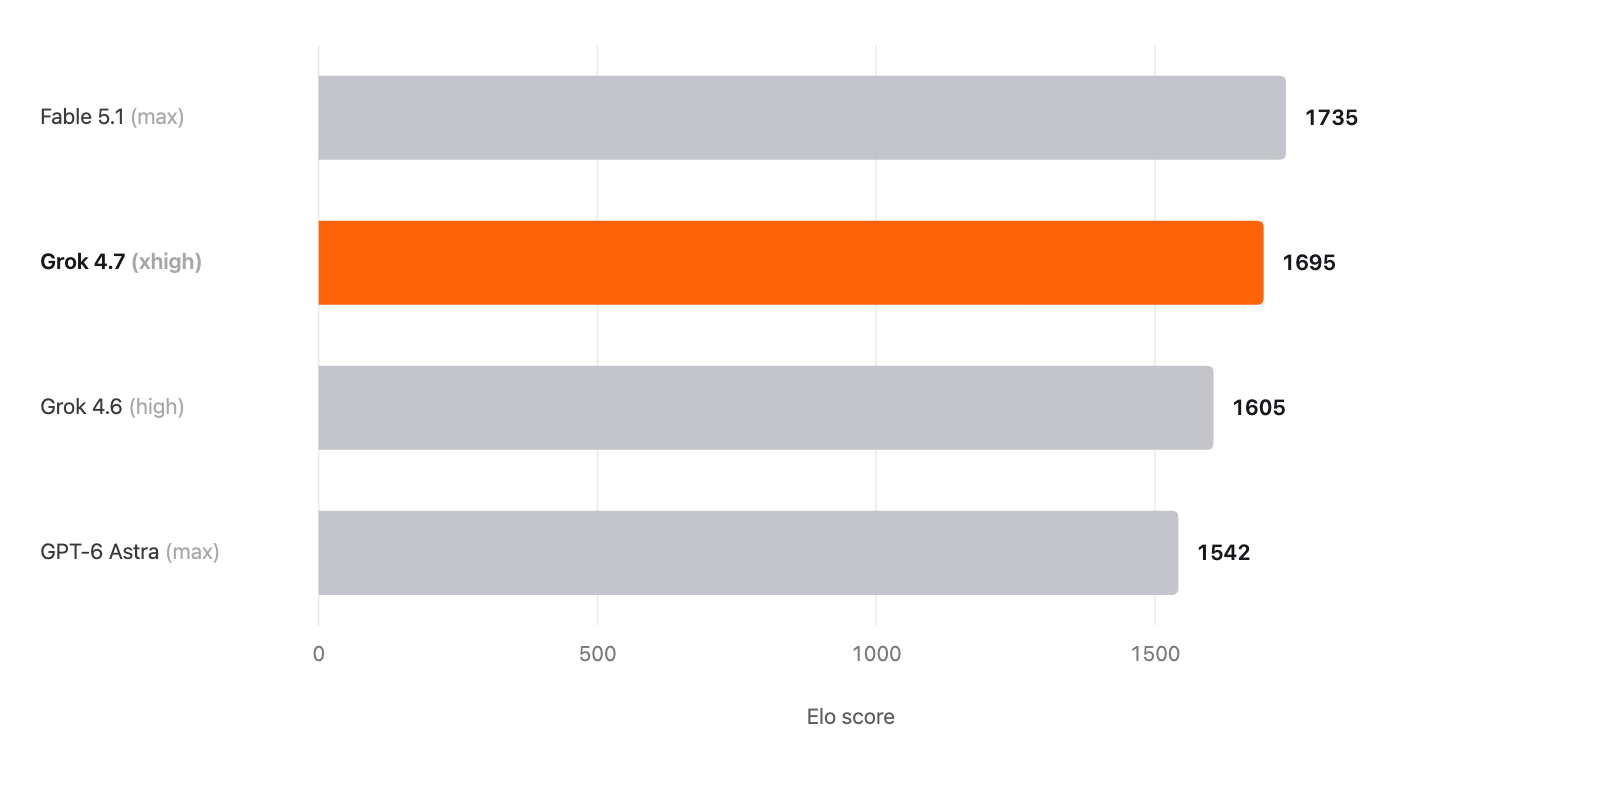
문서와 발표 자료 작성 같은 전문 지식 업무는 Elo 점수로 따로 제시됐습니다. GDPval에서 Claude Fable 5.1(max) 1,735, Grok 4.7(xhigh) 1,695, Grok 4.6(high) 1,605, GPT-6 Astra(max) 1,542 순이고 AA Briefcase에서는 Fable 5.1 1,678, Grok 4.7 1,657, GPT-6 Astra 1,569입니다. SpaceXAI의 표현대로 Grok 4.6 대비 개선이 뚜렷하고 선두와는 근소한 차이입니다. Anthropic도 Opus 5.5의 GDPval 계열 점수를 공개했지만 평가 버전과 표기가 달라 같은 축에 놓지 않았습니다.
CursorBench 4.0의 비용 대비 점수
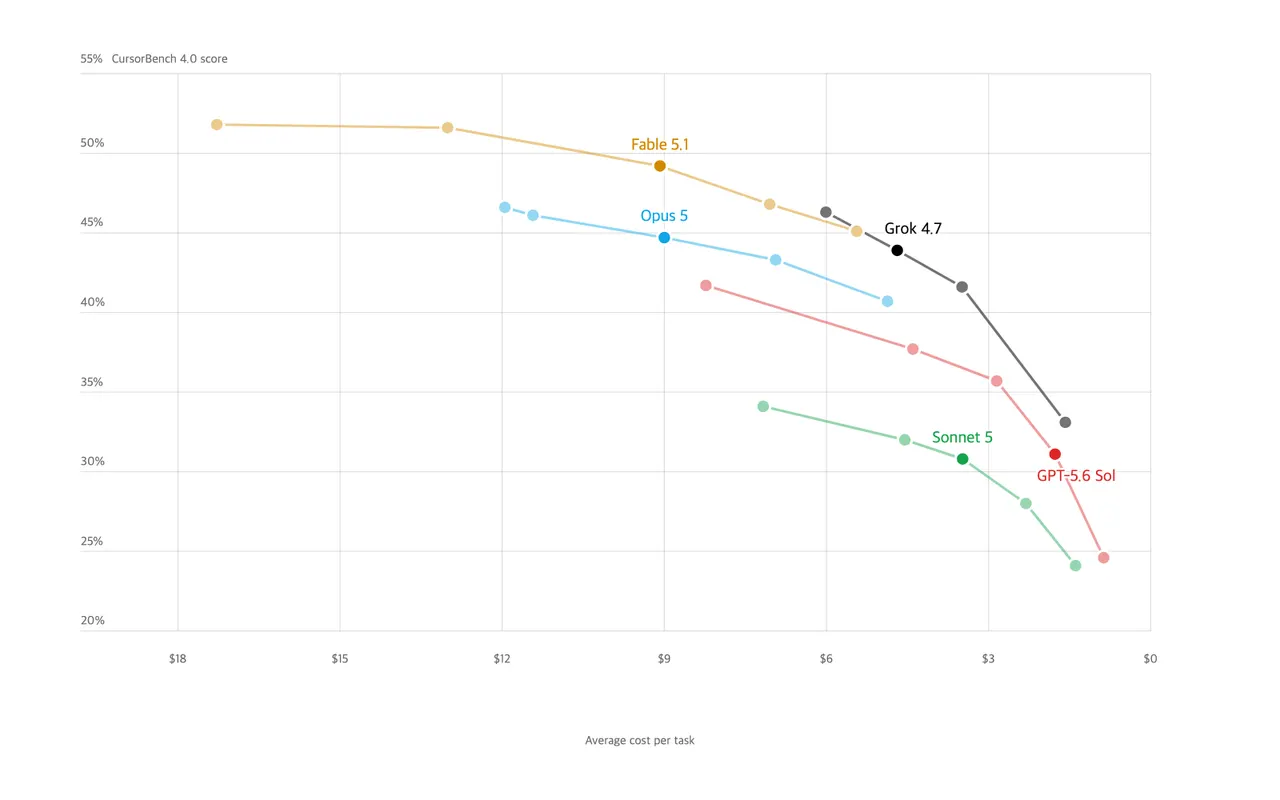
발표에서 가장 판단에 쓸모 있는 자료는 CursorBench 4.0의 산점도입니다. 모델별로 추론 노력 수준을 바꿔 가며 점수와 과제당 평균 비용을 함께 찍었습니다. 가로축은 오른쪽으로 갈수록 비용이 낮아지도록 그려져 있어 오른쪽 위에 있을수록 같은 점수를 더 적은 비용에 낸 것입니다. Grok 4.7은 Low $1.58에 33.1%, Medium $3.49에 41.6%, High $4.69에 43.9%를 기록했습니다.
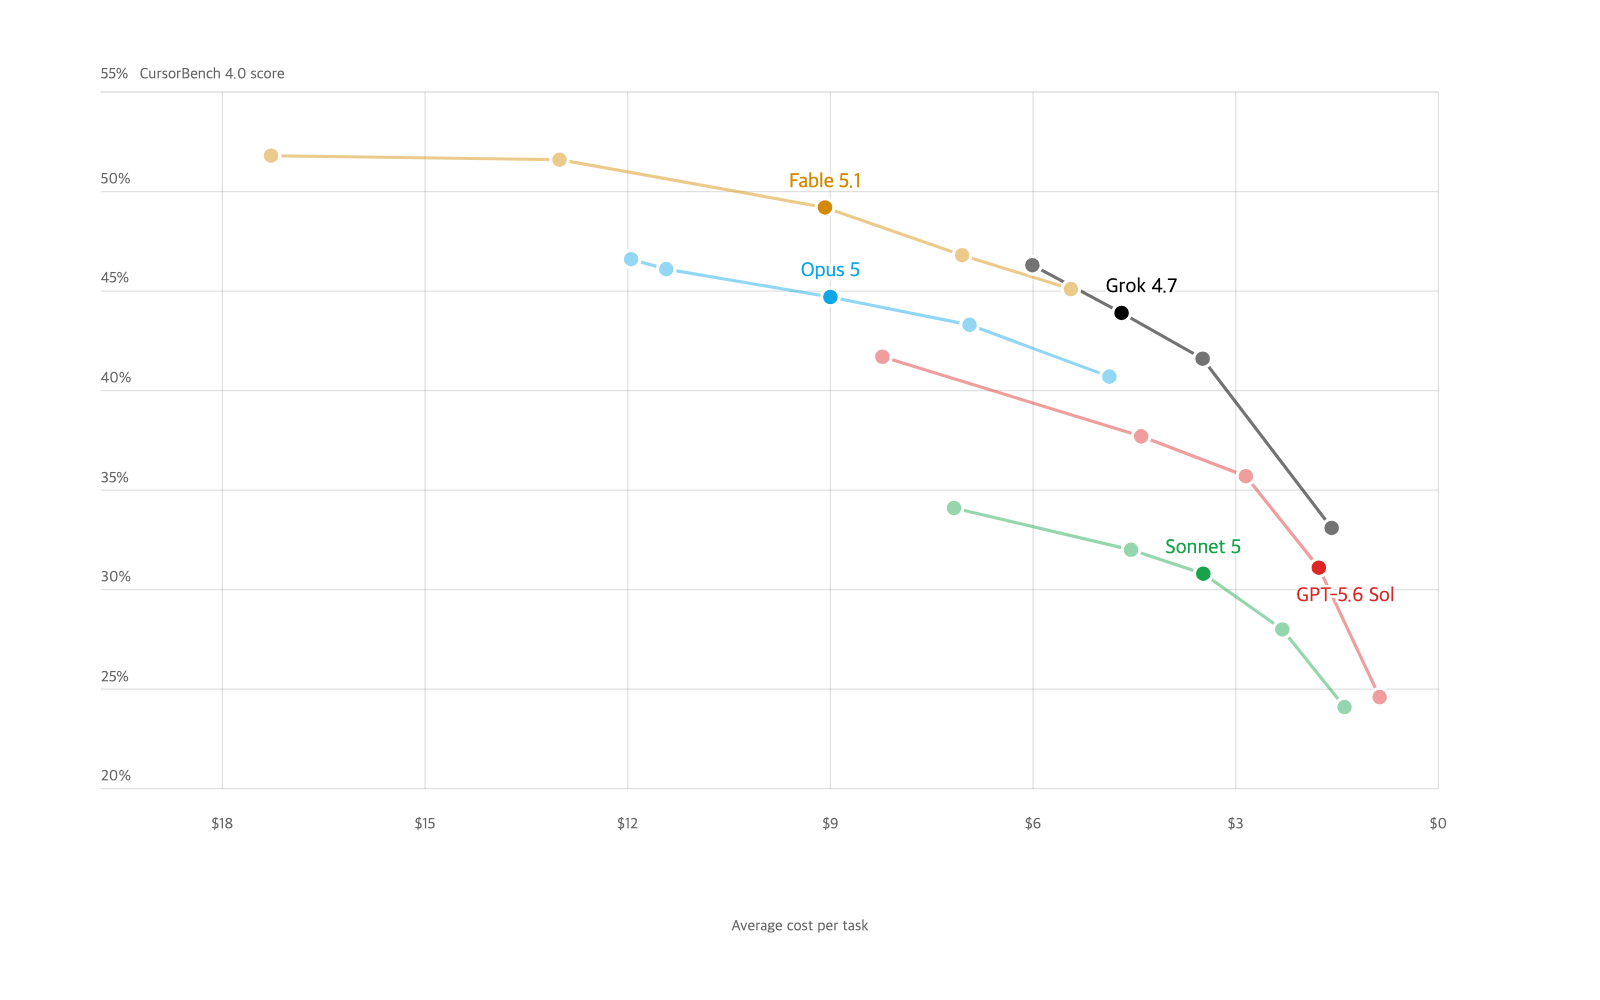
Grok 4.7 Extra High는 46.3%를 과제당 $6.01에 냈습니다. Claude Opus 5 Max(46.6%, $11.95)와 점수가 비슷하고 비용은 절반 수준입니다. 같은 비용대의 Claude Fable 5.1과 비교하면 차이가 작습니다. Fable 5.1 Low는 $5.44에 45.1%, Medium은 $7.05에 46.8%입니다. 따라서 과제당 6달러 안팎에서는 두 모델이 비슷한 위치에 있고, 과제당 비용 상한을 올릴 수 있는 조직이라면 Fable 5.1의 High 이상이 더 높은 점수를 냅니다. Fable 5.1은 High $9.08에 49.2%, Max $17.28에 51.8%입니다. GPT-5.6 Sol은 Max $8.23에서도 41.7%에 그쳐 Grok 4.7 Medium과 비슷한 점수에 두 배 넘는 비용이 들었습니다. 이 차트에는 이번 주 나온 GPT-6 Sol과 Claude Opus 5.5가 없으므로 같은 조건의 비교는 아직 공개되지 않은 상태입니다.
제공 채널과 데이터 정책
개발자 문서가 밝힌 제공 경로는 xAI API, 미국 리전 엔드포인트, 코딩 에이전트 Grok Build(기본 모델), Cursor(모든 요금제), 모델 게이트웨이 OpenRouter와 Vercel과 Cloudflare입니다. 발표문은 클라우드 플랫폼에서도 제공한다고 적었습니다. Google Cloud Vertex AI 연동 문서는 모델 ID 예시로 xai/grok-4.7을 들면서 실제 제공 여부는 Google Cloud 리전과 할당량에 따른다고 밝혔습니다. Microsoft Foundry 문서는 Grok 모델 제공을 설명하지만 Grok 4.7을 특정해 언급하지는 않습니다. 기존 클라우드 계약과 청구 체계로 쓰려는 조직은 각 카탈로그에서 직접 확인해야 합니다.
| 항목 | 문서 내용 |
|---|---|
| 학습 사용 | 명시적 허락 없이 API 입력과 출력으로 학습하지 않음 |
| 기본 보관 | 오남용 감사 목적으로 30일 암호화 보관 후 자동 삭제 |
| Zero Data Retention | 팀 단위 적용. 상태 저장형 Responses API, Files, Collections, Batch API, 지연 응답을 쓸 수 없음 |
| 처리 지역 | 글로벌 엔드포인트는 처리 지역을 보장하지 않음. 미국 엔드포인트는 요청 처리, 추론, 모더레이션, 보관 데이터를 미국 안에서 처리하고 토큰 요금 10% 가산 |
| 미국 보장 제외 | Files, Collections, 웹 검색 등 서버 측 도구, 고객 측 네트워크 경로 |
| 인증·계약 | SOC 2 Type 2, BAA는 설문 후 협의, Enterprise Terms와 DPA 제공 |
모델 상세 페이지에 적힌 리전은 us-east-1, us-west-2, us-central-1 세 곳이며 아시아 리전은 없습니다. 문서는 미국 엔드포인트만으로는 포괄적인 데이터 거주 보장이 되지 않으며 계약상 요건이 있으면 영업 조직과 먼저 협의하라고 명시합니다. Responses API에서는 요청하지 않아도 암호화된 추론 내용이 항상 반환됩니다. 이용 지침 위반으로 판정된 요청은 생성 비용이 그대로 청구되고 생성 전에 차단되면 건당 $0.05의 수수료가 붙습니다.
안전성 발표
SpaceXAI는 Grok 4.7에 새 안전장치 체계를 적용했고 거부와 탈옥 저항에서 자사가 시험한 모델 중 가장 강하다고 밝혔습니다. LatchBio의 생물안전 벤치마크에서 62.4%로 1위를 기록했고, 자체 벤치마크 HackerBench v0.3에서는 위험한 이중 용도 사이버 요청의 3.3%만 통과시켰다고 설명합니다. 정상적인 보안 업무는 거의 막지 않는다는 주장도 함께 실었지만 이를 뒷받침하는 거부율 수치는 발표에 없습니다. 일부 사이버보안 파트너에게는 초대 방식으로 레드팀 기능을 방어 연구용으로 열었습니다. 모두 자사 발표 수치이며 발표 페이지와 개발자 문서에는 별도 시스템 카드 링크가 없습니다.
우리나라 기업이 확인할 것
첫째, Grok 4.7은 출력 비중이 큰 작업의 비용 후보로 검토할 만합니다. 출력 단가 $6은 이번 주 발표된 상위 모델 가운데 GPT-6 Luna를 제외하면 가장 낮고 CursorBench에서는 과제당 6달러 안팎에서 Claude Fable 5.1의 낮은 노력 설정과 비슷한 점수를 냈습니다. 반대로 여러 시간짜리 터미널 작업처럼 Terminal-Bench 격차가 큰 영역은 기존 상위 모델을 유지하는 편이 근거에 맞습니다.
둘째, 50만 토큰 창을 쓰는 설계라면 20만 토큰 경계를 비용 모델에 넣어야 합니다. 경계를 넘는 순간 요청 전체가 두 배 요율로 계산되고 Batch 할인도 없습니다. 긴 문서를 한 번에 넣을지 나눠 넣을지를 단가표로 먼저 계산해 두는 것이 좋습니다.
셋째, 개인정보나 영업비밀이 들어가는 업무에 쓰기 전에 처리 지역과 보관 조건을 확인해야 합니다. 글로벌 엔드포인트는 처리 지역을 보장하지 않고 아시아 리전은 없으며 기본 30일 보관이 적용됩니다. 우리나라 개인정보보호법의 국외 이전 요건과 사내 보안 기준에 비춰 ZDR 적용 여부와 DPA 조건을 법무·보안 부서와 함께 검토해야 합니다. ZDR을 켜면 Files와 Batch 같은 기능을 잃는다는 점도 설계에 반영해야 합니다.
넷째, 벤더 비교표를 자체 평가로 대체해야 합니다. 발표의 비교 대상은 GPT-5.6 Sol과 Claude Fable 5.1이며 이번 주 나온 GPT-6 Sol과 Claude Opus 5.5는 빠져 있습니다. 추론 노력 수준도 모델마다 다릅니다. 사내 코드베이스와 한국어 문서로 구성한 소규모 과제 세트에서 같은 비용 상한을 두고 비교하는 편이 정확합니다.
다섯째, 도입 채널을 먼저 정해야 합니다. 개발 조직이 Cursor를 이미 쓰고 있다면 별도 계약 없이 시험할 수 있지만 기업 차원의 API 사용은 xAI API 계약, 모델 게이트웨이, 클라우드 카탈로그 가운데 무엇을 쓰느냐에 따라 데이터 조건과 청구 경로가 달라집니다.
출처: Introducing Grok 4.7, Grok 4.7 개발자 문서, Pricing, Security FAQ, Regional Endpoints, Google Cloud Vertex AI, Introducing Claude Opus 5.5, GPT-6 Sol·Luna 출시, 전사 AI 단가 재계산으로 더 저렴해진 비용, xAI Launches Grok 4.7. It's Bigger, But Late to the AI Frontier Party
코텍시스 창업자로 AX 컨설팅과 기업 AI 교육, AI 에이전트 개발을 직접 수행합니다.
코텍시스 AI 인사이트 최신 논문 리뷰
AWQ 양자화: 활성값을 보고 가중치를 지키는 4비트 양자화
MIT 연구진의 AWQ는 활성값 분포를 기준으로 중요한 가중치 1%만 보호해도 저비트 양자화 오류가 크게 줄어든다는 관찰에서 출발해 재학습 없는 4비트 양자화를 구현했고 전용 커널 TinyChat으로 FP16 대비 3배 이상의 추론 속도를 달성했습니다. 온프레미스 sLLM을 소수의 GPU로 서빙해야 하는 기업에게 정확도 손실 없이 메모리와 비용을 동시에 줄이는 사실상의 표준 기법입니다.
Mixtral 8x7B로 읽는 MoE 아키텍처: 13B의 연산으로 70B급 성능 내기
총 47B 파라미터 중 토큰당 13B만 활성화하는 희소 MoE 모델 Mixtral 8x7B는 Llama 2 70B와 GPT-3.5를 대부분의 벤치마크에서 따라잡거나 능가했습니다. 추론 연산량은 소형 모델 수준으로 유지하면서 품질을 끌어올리는 MoE의 실용성을 입증한 사례로, 기업의 자체 호스팅 모델 선정 기준에 직접 영향을 줍니다.
DPO가 바꾼 선호 정렬 학습: 보상 모델 없이 RLHF를 대체하는 방법
DPO는 보상 모델의 재매개변수화를 통해 최적 정책을 닫힌 형태로 유도하고, 선호 데이터에 대한 단순 분류 손실만으로 RLHF와 같은 목적을 달성하는 기법입니다. 강화학습 파이프라인을 운영할 여력이 없는 기업 프로젝트에서 선호 정렬을 현실적인 작업 범위로 만들어 준 논문입니다.
AI 솔루션이 필요하신가요?
cortexys.team에서 맞춤 AI 개발 서비스를 확인하세요.