macOS 26.2의 RDMA over Thunderbolt 5와 MLX로 맥미니·맥스튜디오를 묶는 방법을 Apple 측정값과 단일 맥 실습 캡처로 정리합니다. 배선 규칙, 구성 절차, 실습 키트, 그리고 확장·운영상의 한계를 함께 다룹니다.
Apple이 2026년 10월 15일 Local and Distributed Large LLM Inference with MLX and RDMA on Mac Studio를 공개했습니다. M5 Ultra Mac Studio 4대를 Thunderbolt 5로 묶어 816B 파라미터 MoE 모델을 초당 36.73토큰으로 생성한 결과입니다. 이 글은 맥미니·맥스튜디오 클러스터가 무엇으로 성립하는지, 직접 따라 할 수 있는 절차, 그리고 이 방식으로 할 수 없는 일을 정리합니다. 실습 명령과 호스트 파일은 글 끝의 실습 키트에 담았습니다.
클러스터를 성립시키는 세 가지 요소
맥 클러스터는 세 가지 구성 요소가 맞물려야 동작합니다.
| 구성 요소 | 내용 | 근거 |
|---|---|---|
| RDMA over Thunderbolt | macOS 26.2부터 Thunderbolt 5 포트가 있는 Apple 실리콘 맥에서 RDMA Verbs API 제공 | Apple TN3205 |
| MLX 분산 백엔드 | jaccl(RDMA, MLX 0.30.1 이상)과 ring(TCP) 중 선택 | MLX 문서 |
| 모델 분할 방식 | 텐서 병렬(층 내부를 나눔)과 파이프라인 병렬(층 묶음을 나눔) | Apple ML Research |
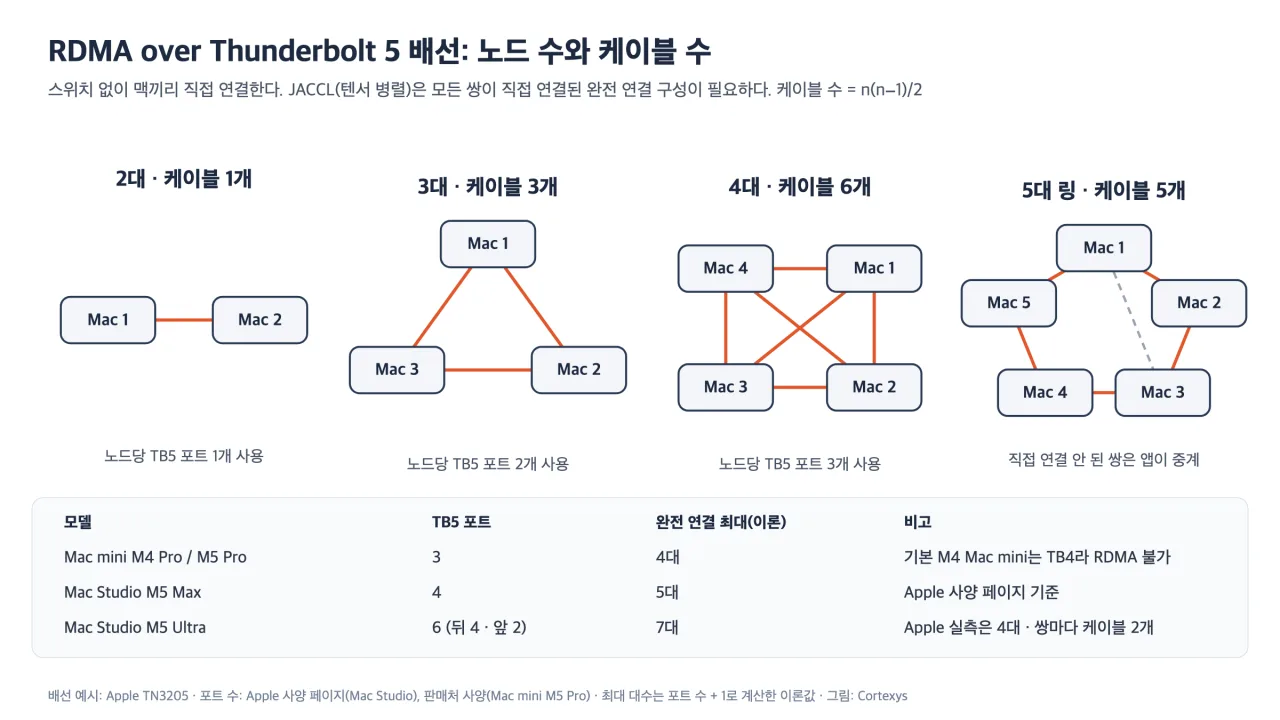
Thunderbolt 스위치가 없으므로 맥끼리 케이블로 직접 연결합니다. JACCL 백엔드는 모든 쌍이 직접 연결된 완전 연결 구성만 지원하고, RDMA는 데이터를 중계하지 못합니다. 그래서 노드 수의 상한은 맥 한 대의 TB5 포트 수가 정합니다.
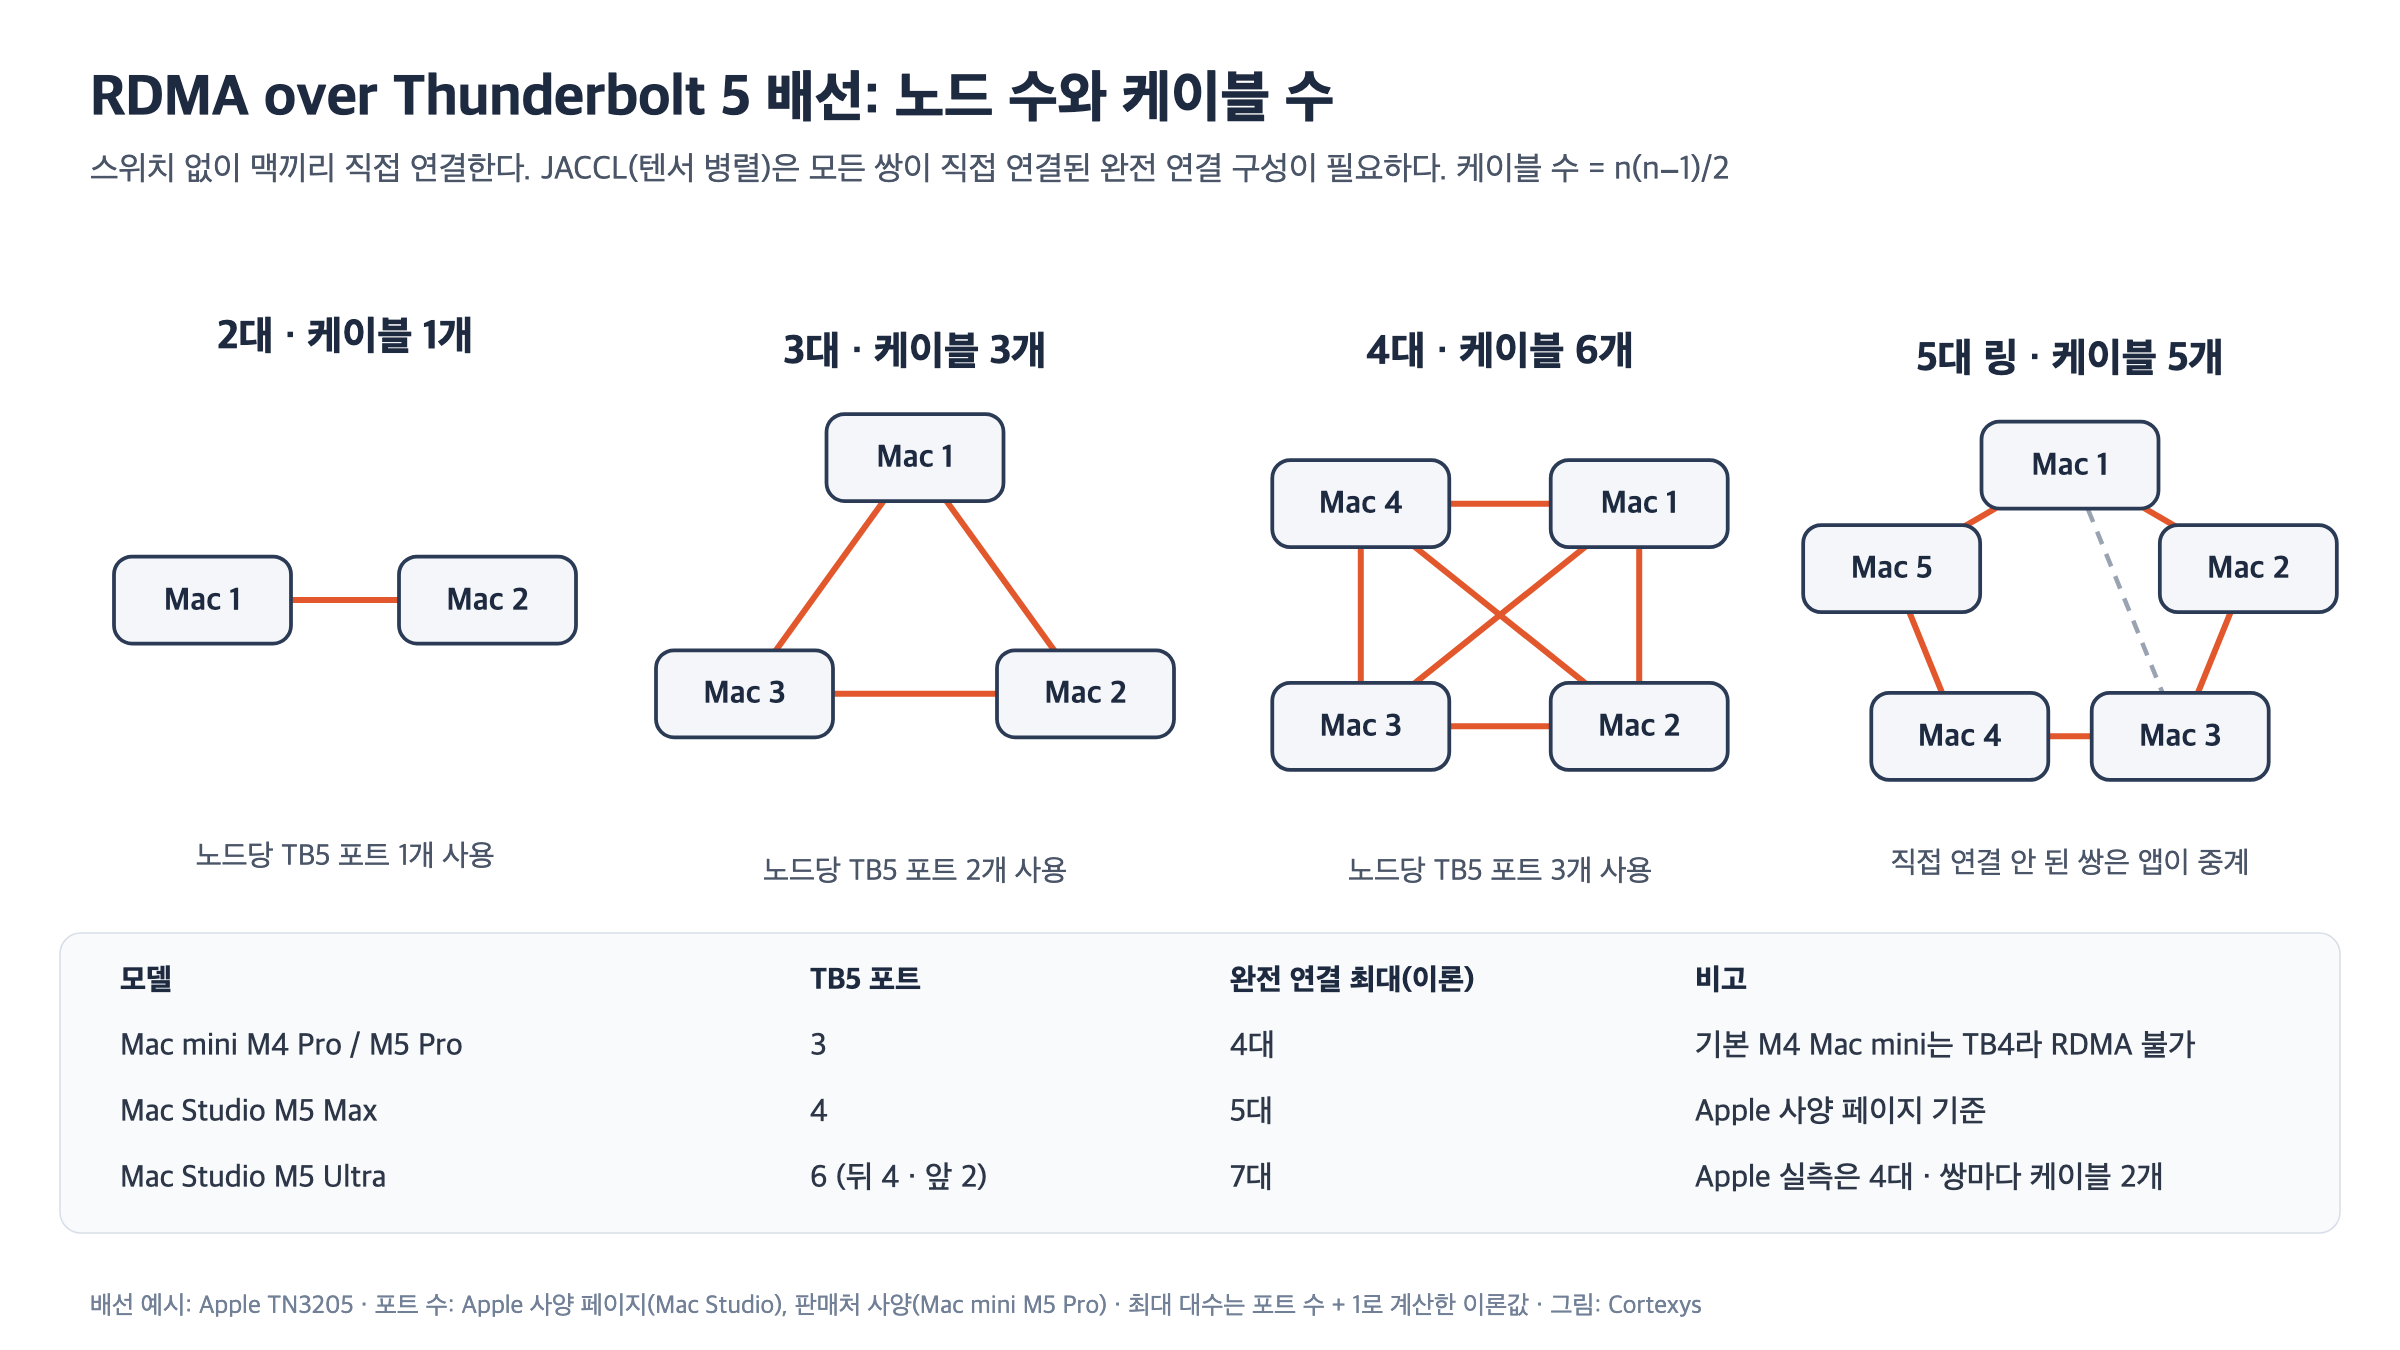
2026년 9월 22일 출시된 M5 Ultra Mac Studio는 TB5 포트가 6개(뒤 4개, 앞 2개)이고 메모리는 최대 512GB, 대역폭은 1.2TB/s입니다. 512GB 구성은 10월 말 출고 예정입니다. 맥미니 M5 Pro는 TB5 포트 3개라 완전 연결은 4대가 이론상 최대입니다. 기본 M4 맥미니처럼 Thunderbolt 4만 있는 맥은 RDMA 대상이 아닙니다.
분할 방식에 따른 속도 차이
모델을 두 대에 나누는 방법은 두 가지입니다. 파이프라인 병렬은 앞쪽 층을 1번 맥, 뒤쪽 층을 2번 맥에 둡니다. 토큰 하나가 두 맥을 차례로 지나므로 한 시점에 한 대만 계산하고 생성 속도는 단일 노드와 같습니다. 텐서 병렬은 모든 층을 두 대가 절반씩 동시에 계산하고 층마다 결과를 합칩니다. 생성 속도가 오르는 대신 토큰마다 층 수만큼 작은 통신이 생기므로 통신 지연이 속도를 정합니다. RDMA가 필요한 이유가 여기에 있습니다.
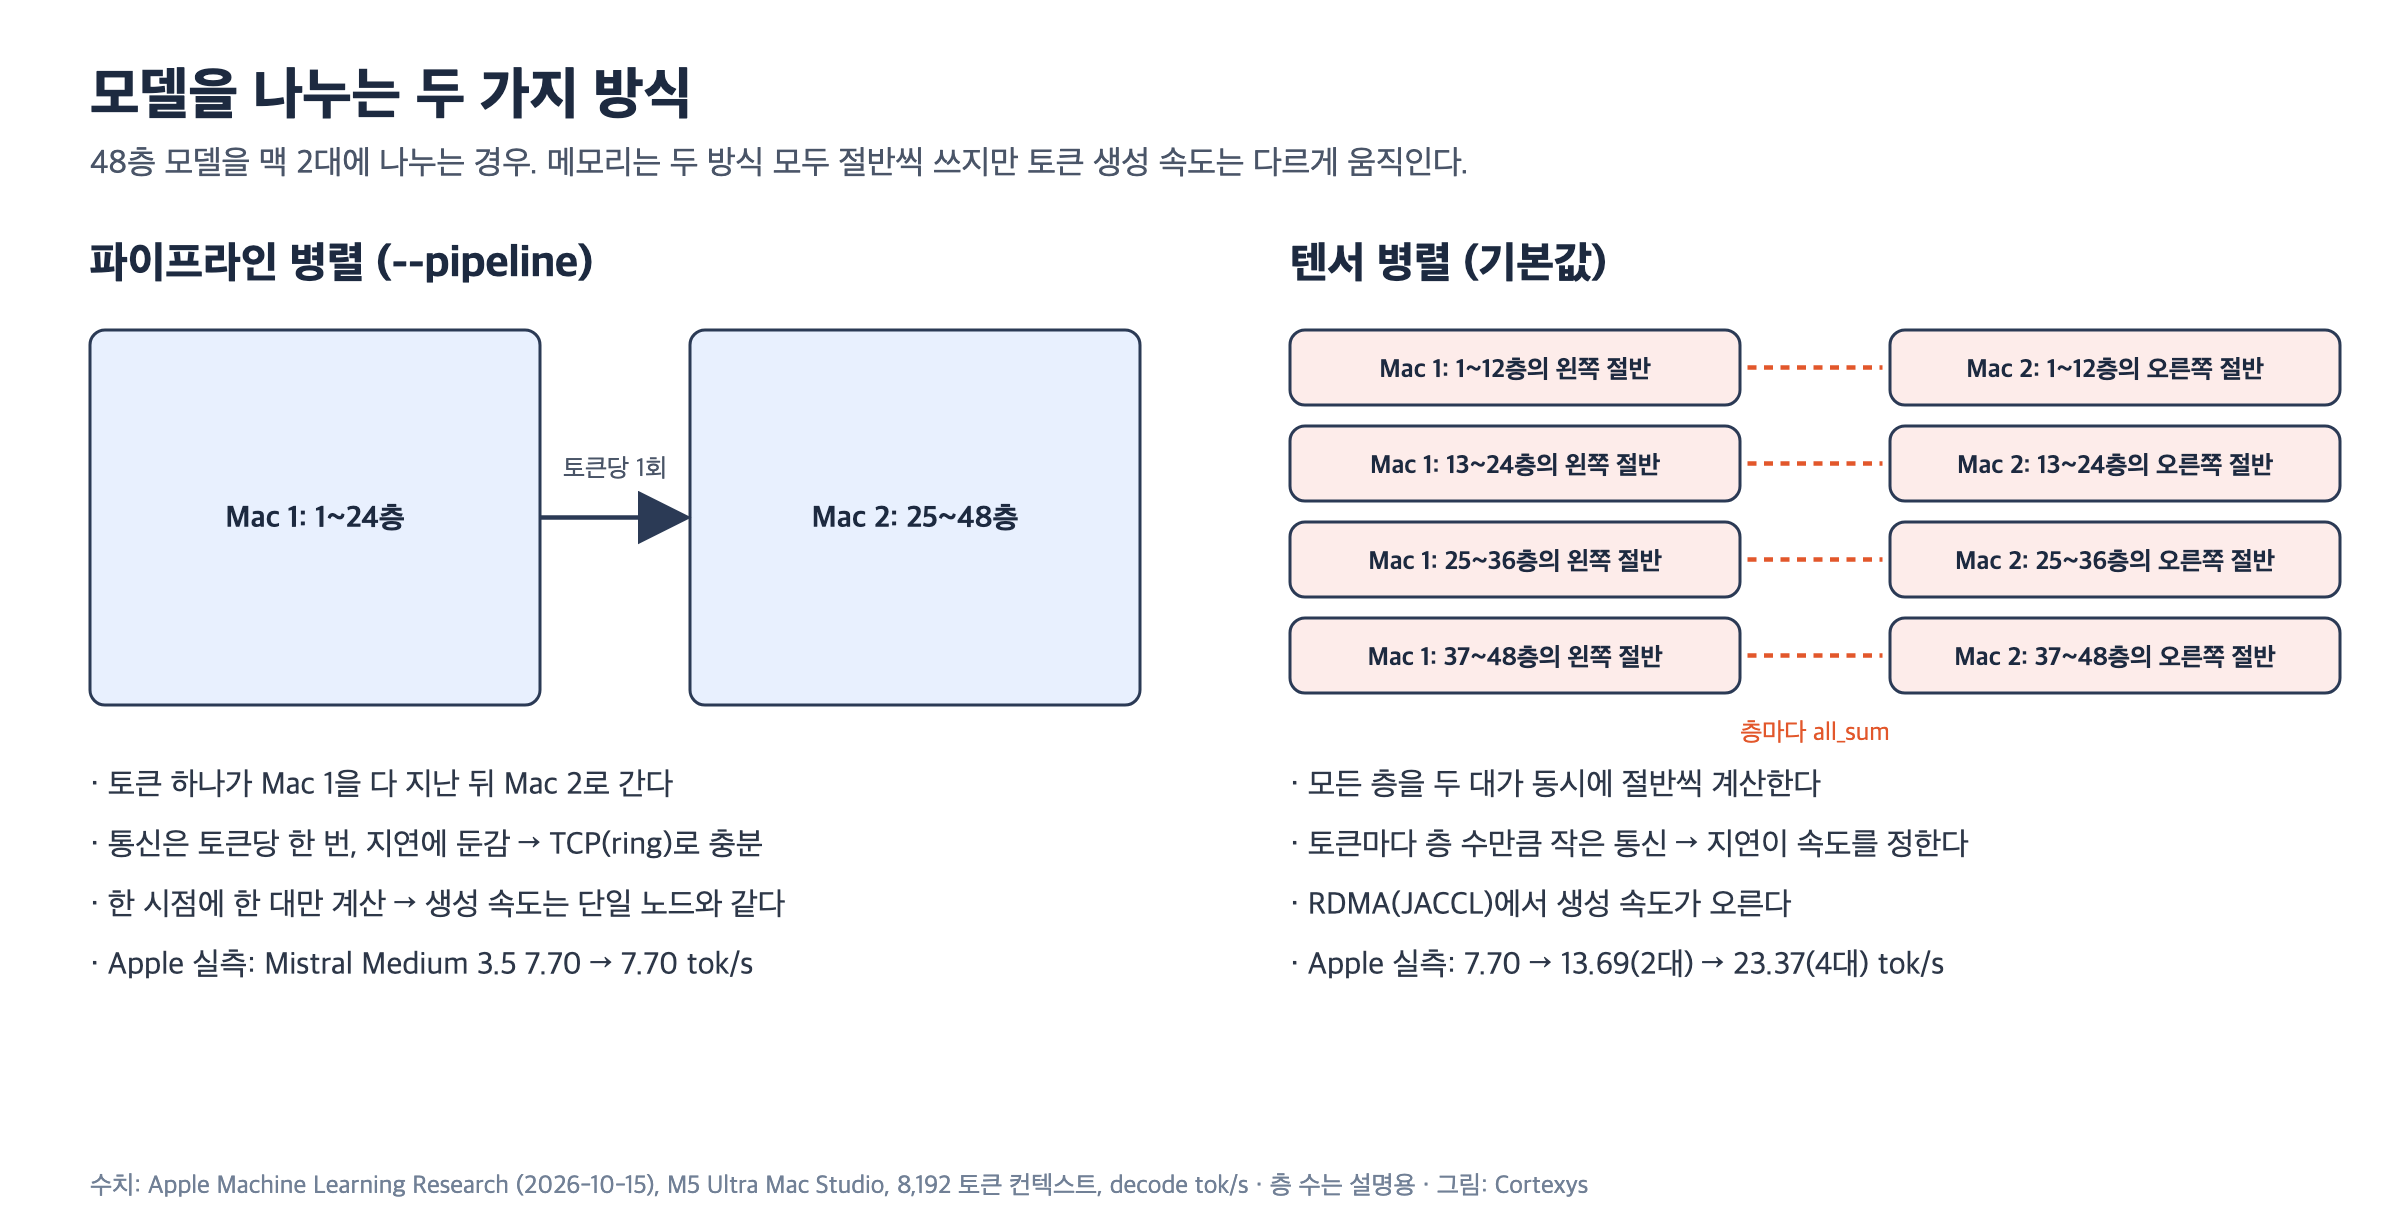
Apple이 공개한 M5 Ultra 측정값(8,192 토큰 컨텍스트, 배치 1)이 이 차이를 보여 줍니다.
| 모델 | 1대 | 2대 파이프라인 | 2대 텐서 | 4대 텐서 | 첫 토큰까지(1대 → 4대) |
|---|---|---|---|---|---|
| Qwen 3.8 27B (BF16) | 19.69 | 19.44 | 33.27 | 50.89 | 4.1초 → 1.7초 |
| Mistral Medium 3.5 128B (FP8) | 7.70 | 7.70 | 13.69 | 23.37 | 24.6초 → 7.5초 |
| Muse Spark Open 816B (NVFP4) | 메모리 초과 | 15.74 | 24.99 | 36.73 | 2대 8.4초 → 4대 4.8초 |
4대 텐서 병렬의 생성 속도는 단일 노드 대비 Mistral Medium 3.5가 3.0배, Qwen 3.8이 2.6배입니다. Apple은 밀집 모델이 MoE 모델보다 여러 대에서 잘 확장된다고 설명합니다. Muse Spark Open은 NVFP4 가중치만 약 493GB라 512GB 한 대에 올라가지 않으므로 클러스터가 유일한 선택지입니다. 4대 구성은 쌍마다 케이블 2개를 연결했고, 65,536 토큰 컨텍스트에서 첫 토큰까지 시간이 케이블 1개일 때 50.5초, 2개일 때 40.6초였습니다.
M3 Ultra 4대로 측정한 Jeff Geerling의 2025년 12월 실험에서는 exo로 Qwen3 235B를 초당 약 32토큰, Kimi K2 Thinking(1T)을 약 30토큰으로 생성했습니다. 같은 실험에서 llama.cpp RPC 방식은 확장 효율이 낮아 노드를 늘리면 느려지는 경우도 있었습니다.
한 대로 먼저 확인한 실행 경로
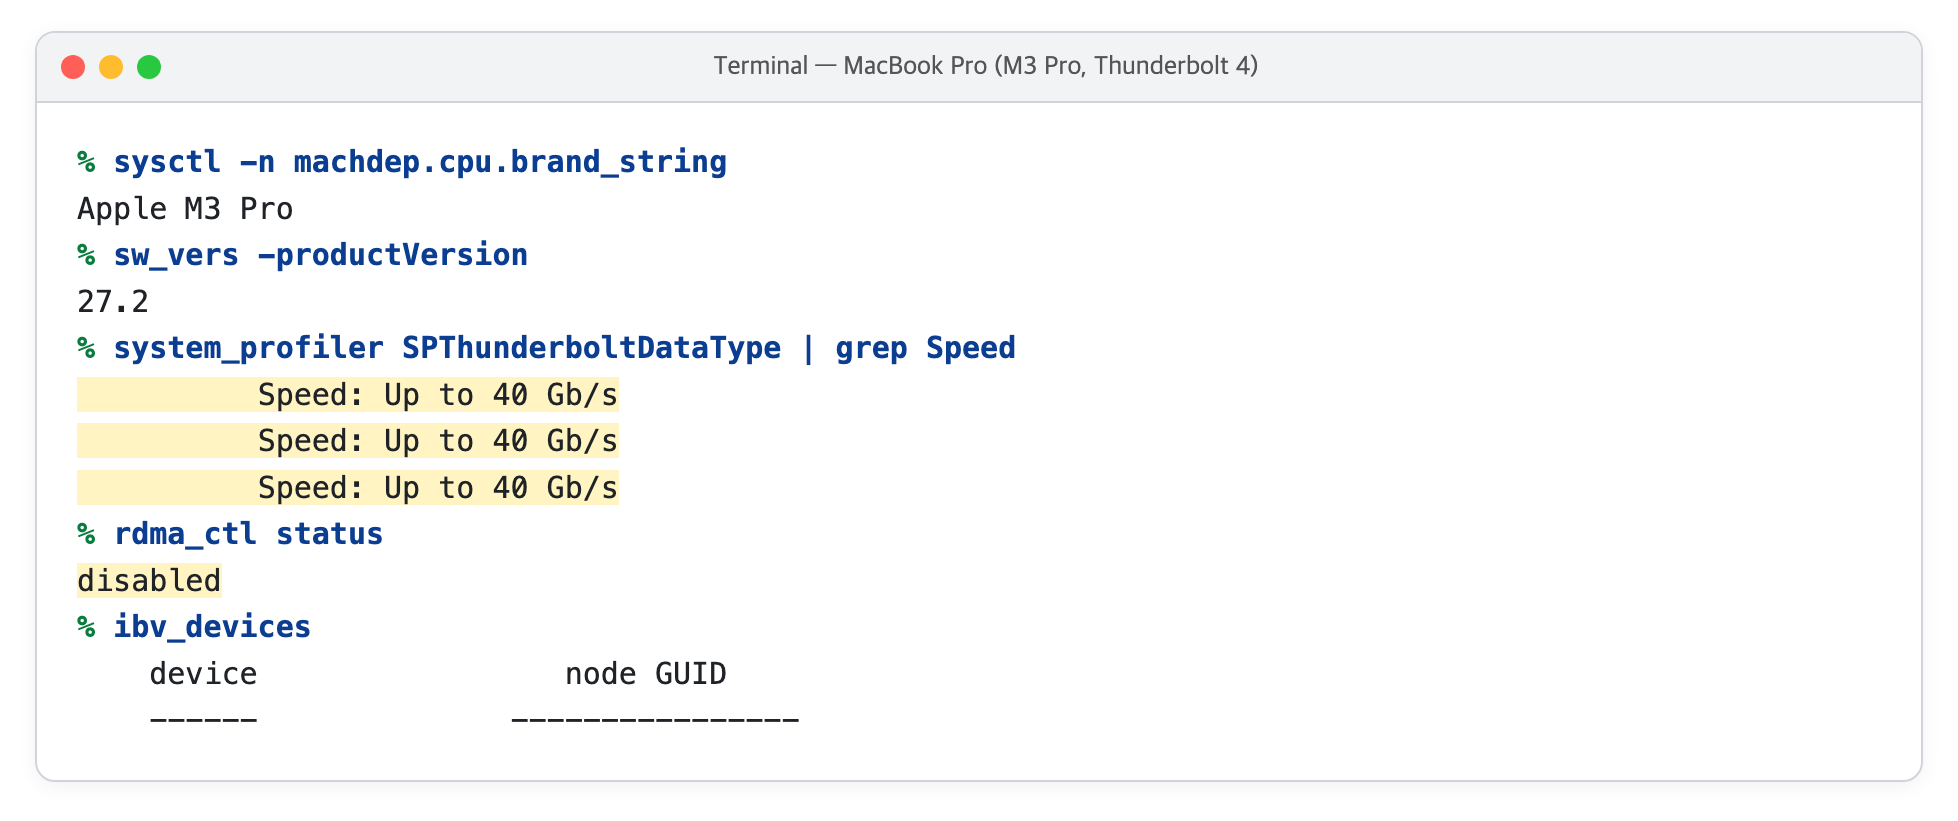
코텍시스가 보유한 장비는 Thunderbolt 4 맥이라 RDMA 클러스터를 직접 구성하지 못했습니다. 대신 MacBook Pro(M3 Pro, 18GB) 한 대에서 MLX 0.32.4로 랭크 2개를 띄워 명령과 호스트 파일이 그대로 동작하는지 확인했습니다. 아래 성능 수치는 실행 경로 확인용이고, 클러스터 성능은 앞 절의 Apple 측정값을 기준으로 봐야 합니다.
먼저 RDMA 지원 여부를 확인합니다. TB4 맥은 포트 속도가 40Gb/s로 표시되고 RDMA 장치가 생기지 않습니다. TB5 맥이라면 복구 모드에서 rdma_ctl enable을 실행한 뒤 ibv_devices에 rdma_en2 같은 장치가 보여야 합니다.
다음으로 같은 모델(Qwen3.5 4B, 4비트)을 단일 실행, 랭크 2개 파이프라인, 랭크 2개 텐서로 측정했습니다. 두 랭크가 같은 GPU를 나눠 쓰므로 속도 향상은 기대할 수 없고, 랭크당 메모리와 통신 부담만 관찰 대상입니다.
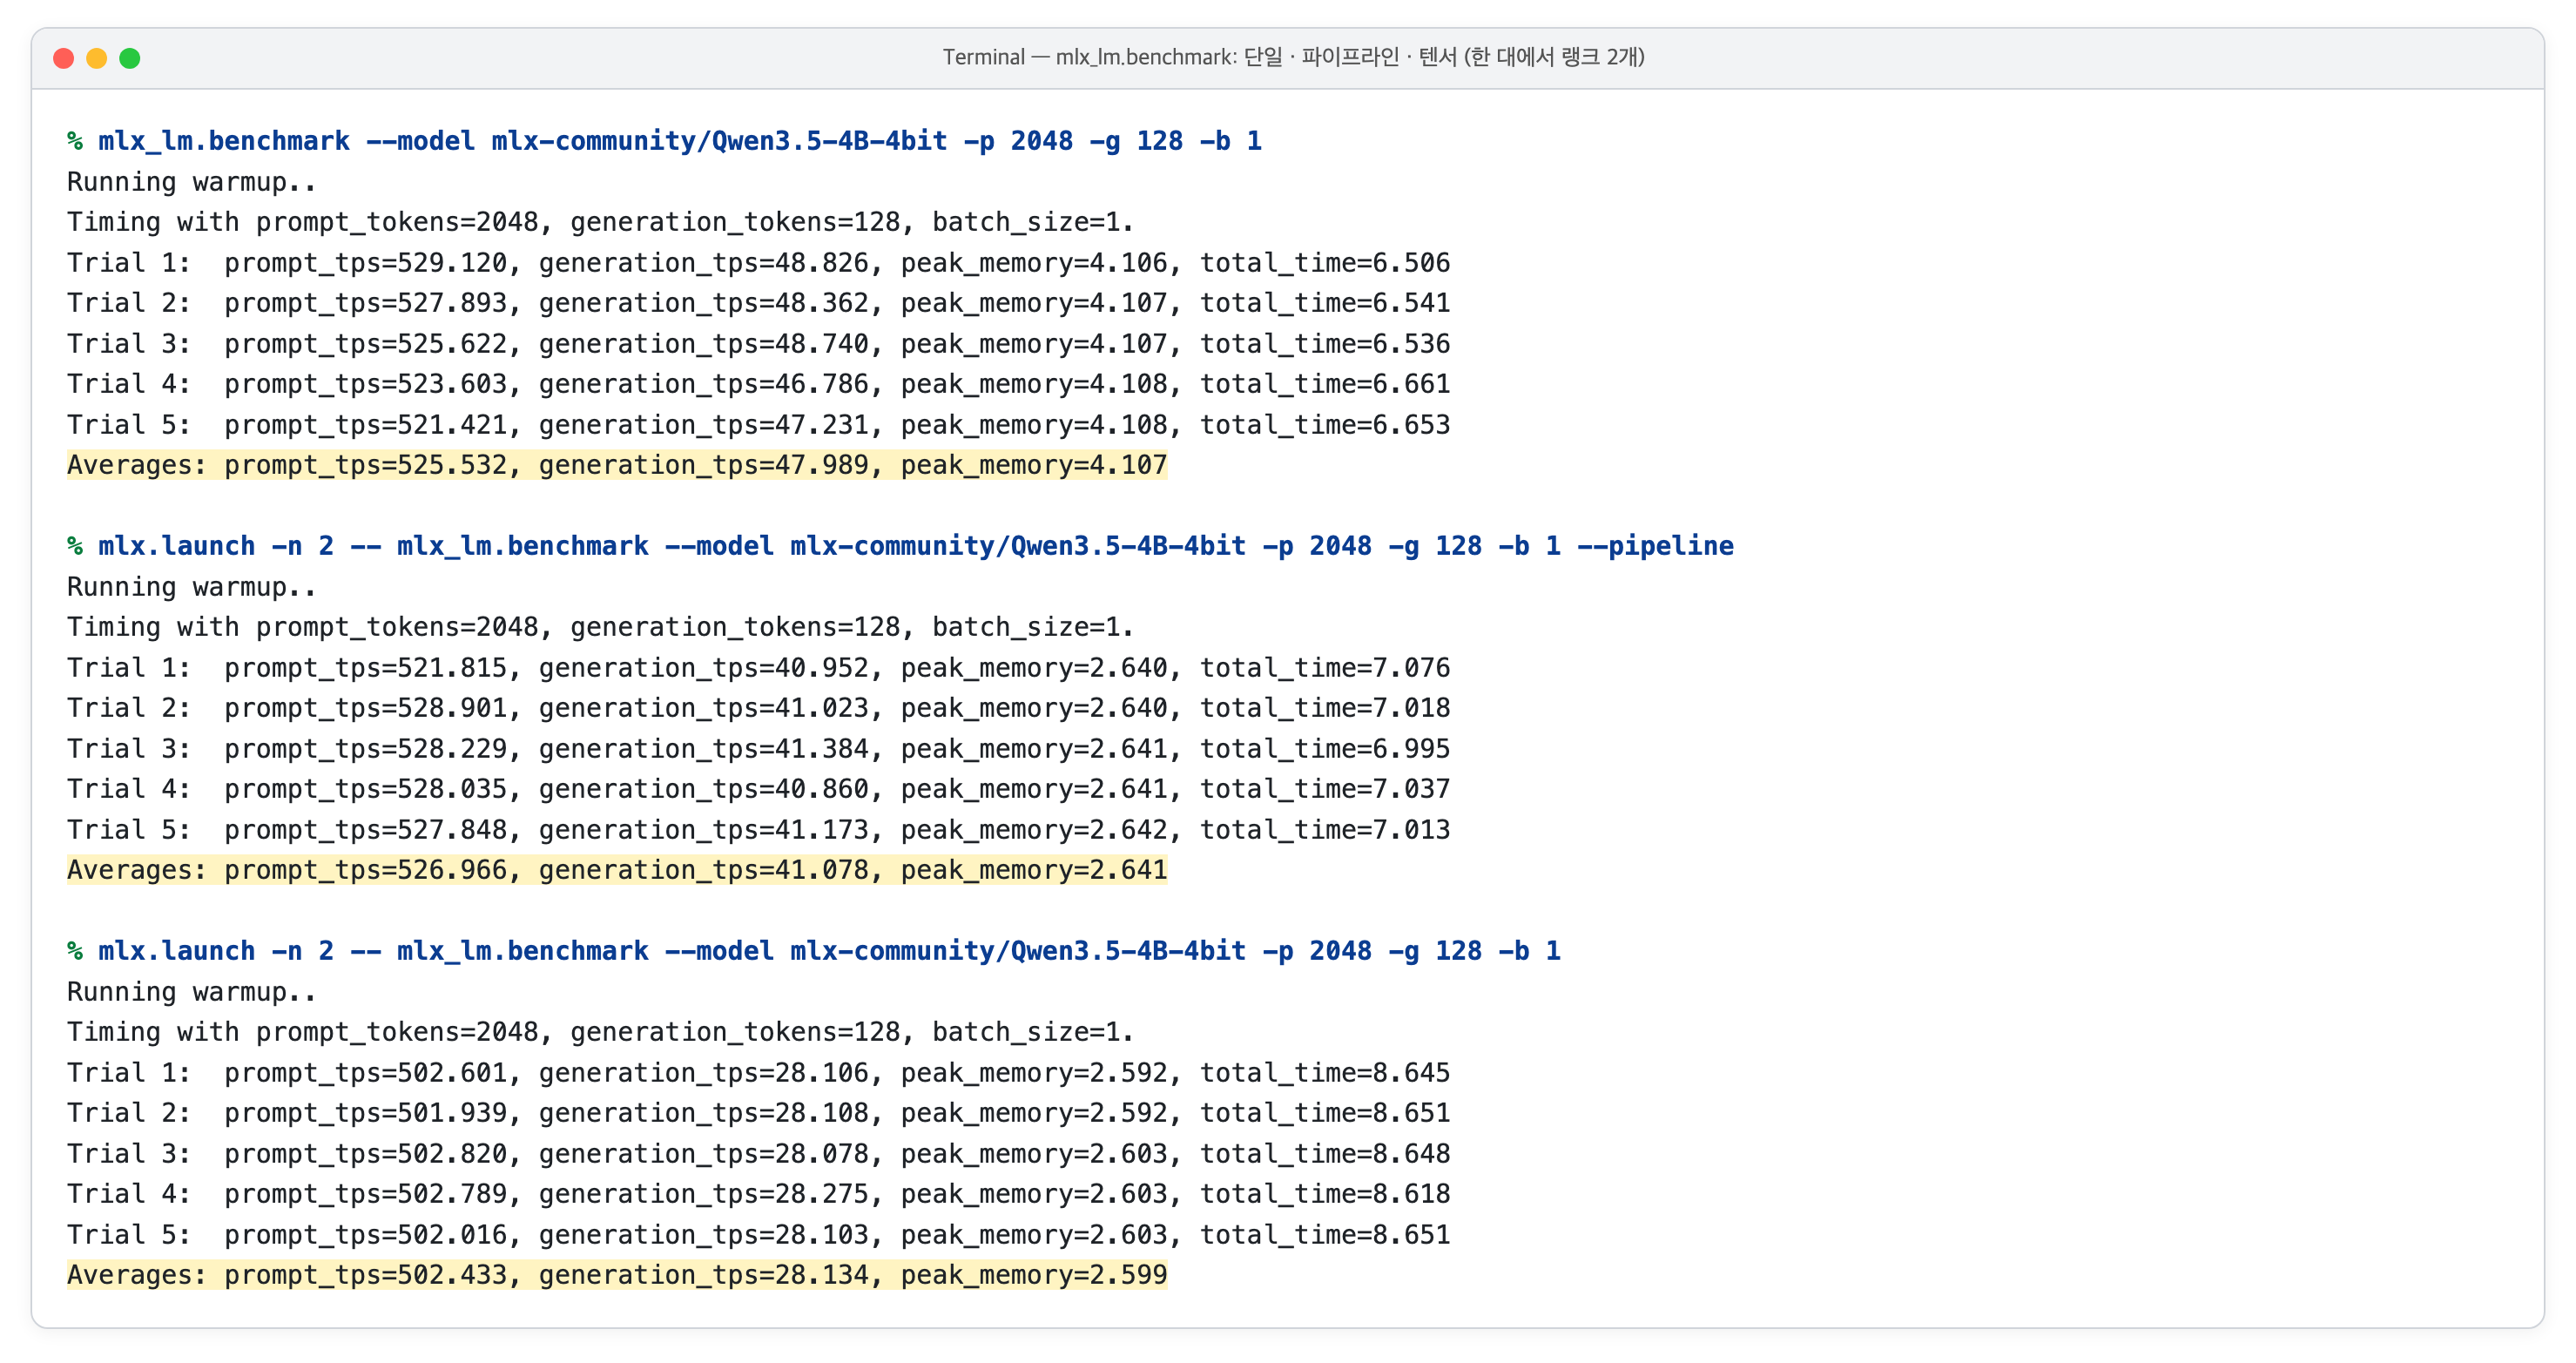
| 실행 방식 (프롬프트 2,048 · 생성 128토큰) | 프롬프트 처리 tok/s | 생성 tok/s | 랭크당 최대 메모리 |
|---|---|---|---|
| 단일 실행 | 525.5 | 48.0 | 4.11GB |
랭크 2개 파이프라인 (--pipeline) | 527.0 | 41.1 | 2.64GB |
| 랭크 2개 텐서 (ring, TCP) | 502.4 | 28.1 | 2.60GB |
두 방식 모두 랭크당 메모리가 약 64% 수준으로 줄었습니다. 텐서 병렬은 TCP 통신에서 생성 속도가 41% 떨어졌습니다. 텐서 병렬을 RDMA 없이 실행하면 통신 지연이 생성 속도를 낮춘다는 앞 절의 설명과 같은 방향입니다. 실습 중 확인한 사항은 세 가지입니다. MLX 0.32.4의 mlx.launch는 -- python 스크립트.py처럼 인터프리터를 적어야 하고, mlx.distributed_config의 저장 옵션은 문서의 --output과 달리 --output-hostfile입니다. 파이프라인 병렬은 모델 구현이 지원해야 해서 Qwen3 0.6B는 오류로 종료됐고, mlx-lm 0.32.2에서 파이프라인을 지원하는 아키텍처는 8개였습니다.
실제 구성 순서
TB5 맥 2대 이상이 있다면 다음 순서로 진행합니다. 실습 키트의 preflight.sh가 1번과 2번 상태를 한 번에 출력합니다.
- 모든 노드의 macOS 빌드 번호를 맞춥니다. exo 문서는 베타 빌드 번호까지 같아야 RDMA 포트가 서로를 찾는다고 적고 있습니다.
- 시스템 설정에서 Thunderbolt Bridge를 비활성화하고, 잠자기 끔과 정전 후 자동 시동을 켭니다. Thunderbolt는 Wake-on-LAN을 지원하지 않아 잠든 노드에 접속할 수 없습니다.
- 노드마다 복구 모드로 들어가
rdma_ctl enable을 실행하고 재부팅합니다. 원격이나 sudo로는 켤 수 없습니다. - n(n−1)/2개의 TB5 케이블로 완전 연결한 뒤
ibv_devinfo에서 모든 포트가 PORT_ACTIVE인지 확인합니다. - rank 0에서 모든 노드로 비밀번호 없는 SSH를 설정하고
mlx.distributed_config --over thunderbolt --backend jaccl로 호스트 파일을 만듭니다. mlx.launch --backend jaccl --hostfile jaccl-4.json -- python all_sum_bench.py로 통신을 확인한 다음mlx_lm.benchmark나mlx_lm.server를 같은 방식으로 실행합니다.mlx_lm.server는 OpenAI 호환 API를 제공합니다.
GUI와 자동 탐색이 필요하면 MLX 분산을 내부에서 쓰는 exo를 설치하는 방법도 있습니다. exo가 밝힌 2대 1.8배, 4대 3.2배 속도 향상은 측정 방법이 공개되지 않은 수치입니다.
이 방식의 한계
| 한계 | 근거 | 영향 |
|---|---|---|
| TB5 맥만 RDMA 지원 | Apple TN3205, 코텍시스 실측(TB4에서 장치 없음) | 기본 M4 맥미니, M3 세대 이하 맥북 등 TB4 맥은 TCP(ring)만 사용 |
| 완전 연결만 지원, 스위치 없음 | MLX 문서, TN3205 | 맥미니 M5 Pro 4대, M5 Ultra 7대가 이론상 상한. 5대 이상 링 배선은 애플리케이션 중계 필요 |
| 원격 활성화 불가 | TN3205, MLX 문서 | 노드 추가·교체 때마다 현장에서 복구 모드 작업 |
| 파이프라인은 생성 속도 불변 | Apple 측정 7.70 → 7.70 tok/s | TB4·이더넷 클러스터는 큰 모델을 올리는 용도에 그침 |
| 확장이 선형 이하 | Apple 측정 4대 2.6~3.0배 | 4대 비용으로 4배 속도를 기대할 수 없음 |
| 배치 서빙용 설계 아님 | Apple 측정이 모두 배치 1 | 여러 사용자 동시 처리는 GPU 서버가 유리 |
| 안정성 | Geerling: 장애가 잦아 Ansible로 재부팅 자동화 | 운영 시 재시작 절차와 감시 필요 |
| 실험 기능 의존 | MLX 문서: MLX_METAL_FAST_SYNCH GPU 교착 위험 | Apple 벤치마크 설정을 그대로 운영에 쓰면 위험 |
이 밖에 커뮤니티 보고로는 M3 Ultra Mac Studio의 이더넷 옆 TB5 포트를 RDMA에 쓸 수 없다는 내용(exo 문서, Geerling)이 있고, M5 Ultra에도 해당하는지는 확인되지 않았습니다. 직접 개발한다면 RDMA Verbs가 송수신만 지원하고 연결(queue pair)이 최대 10개라는 TN3205의 제약도 확인해야 합니다. MLX 0.32.4 소스에는 링 배선용 jaccl-ring 백엔드가 있지만 문서에는 아직 없습니다.
실습 키트
mac-cluster-kit.zip에 단계별 안내(README), 노드 점검 스크립트 preflight.sh, 전원·브리지 설정 스크립트 cluster-settings.sh(sudo 필요), 통신 측정 스크립트 all_sum_bench.py, ring·JACCL 2대·4대 호스트 파일 템플릿을 담았습니다. JACCL 4대 템플릿은 TN3205의 배선 예시와 같은 장치 이름으로 작성했습니다. 함께 볼 자료는 Apple TN3205, MLX 분산 문서, WWDC26 세션 233입니다.
우리나라 기업이 확인할 것
- 목표 모델의 가중치 크기를 먼저 계산합니다. 512GB 한 대에 올라가는 모델이라면 클러스터보다 M5 Ultra 한 대가 단순하고, 클러스터는 Muse Spark Open처럼 한 대를 넘는 모델이나 생성 속도를 2~3배 올려야 할 때 검토합니다.
- 사용자 수를 확인합니다. Apple 측정은 모두 배치 1이고 클러스터는 소수 사용자의 대화형 사용에 맞습니다. 사내 수십 명이 동시에 쓰는 서비스라면 GPU 서버나 클라우드와 처리량을 비교해야 합니다.
- 운영 인력을 확인합니다. 노드마다 복구 모드 작업, macOS 빌드 일치, 장애 시 재부팅이 필요하므로 데이터를 외부로 보낼 수 없는 내부 업무에서 담당자가 정해진 경우에 맞습니다.
출처: Apple Machine Learning Research, Local and Distributed Large LLM Inference with MLX and RDMA on Mac Studio · Apple TN3205 · MLX Distributed Communication · Apple Newsroom, 새로운 Mac mini와 Mac Studio · Mac Studio 사양 · Jeff Geerling, 1.5 TB of VRAM on Mac Studio · exo
코텍시스 창업자로 AX 컨설팅과 기업 AI 교육, AI 에이전트 개발을 직접 수행합니다.
코텍시스 AI 인사이트 최신 논문 리뷰
토큰당 KV 캐시 크기로 계산하는 온프레미스 동시 처리량
vLLM 논문이 보인 것처럼 LLM 서빙의 동시 처리량은 GPU 메모리에서 가중치를 빼고 남은 공간을 토큰당 KV 캐시 크기로 나눈 값이 정합니다. Qwen3-8B와 Qwen3-32B의 config.json으로 계산하면 80GiB GPU 1장에서 8,192토큰 세션 상한이 57개와 9개로, 가중치 크기 차이 4배보다 큰 6배 이상의 차이가 납니다.
초안 모델로 생성 속도를 높이는 추측 디코딩
Google Research의 추측 디코딩은 작은 초안 모델이 제안한 토큰을 큰 모델이 한 번에 검증하고 확률적 수락 규칙으로 출력 분포를 그대로 유지해, T5-XXL의 생성 속도를 재학습 없이 2배에서 3배 높였습니다. M3 Pro 맥북의 Gemma 4 12B 단일 사용자 실측에서는 초안을 켜면 같은 출력을 유지한 채 생성 속도가 15.3 tok/s에서 33.4 tok/s로 2.18배 올랐습니다.
AWQ 양자화: 활성값을 보고 가중치를 지키는 4비트 양자화
MIT 연구진의 AWQ는 활성값 분포를 기준으로 중요한 가중치 1%만 보호해도 저비트 양자화 오류가 크게 줄어든다는 관찰에서 출발해 재학습 없는 4비트 양자화를 구현했고 전용 커널 TinyChat으로 FP16 대비 3배 이상의 추론 속도를 달성했습니다. 온프레미스 sLLM을 소수의 GPU로 서빙해야 하는 기업에게 정확도 손실 없이 메모리와 비용을 동시에 줄이는 사실상의 표준 기법입니다.