Xiaomi가 MIT 표기 공개 가중치 모델 MiMo-V2.6을 내놓았습니다. 독립 지수 46점과 GPT-6 Sol 대비 낮은 단가를 근거로 자체 호스팅과 API 선택 기준을 정리합니다.
공개 범위와 라인업
Xiaomi가 2026년 9월 22일 Introducing MiMo-V2.6 series를 공개했습니다. 텍스트와 이미지와 영상과 음성을 한 모델에서 처리하는 옴니모달 모델 두 종(Pro, Flash)을 가중치까지 공개하고, 같은 날 API 가격은 이전 세대인 V2.5와 동일하게 유지한다고 밝혔습니다. Xiaomi는 Pro를 지금까지 만든 모델 중 가장 뛰어난 모델로, Flash를 지능과 효율과 비용의 균형을 맞춘 모델로 소개했습니다. 출력 속도를 최대 20배로 높인 Pro-UltraSpeed 모드도 함께 내놓았습니다.
이 발표가 기업 입장에서 의미를 갖는 이유는 두 가지가 겹치기 때문입니다. 독립 평가 기관 Artificial Analysis의 종합 지수에서 Pro가 46점을 받아 상용 최상위권과 격차가 크지 않고, Hugging Face 모델 카드의 라이선스 표기가 MIT입니다. 이 글은 벤치마크와 가격을 확인한 뒤 자체 호스팅과 API 사용 중 무엇을 고를지 판단하는 데 필요한 사실을 정리합니다.
| 구성 | 파라미터(전체/활성) | 공개 가중치 | API 가격(입력/출력, 100만 토큰) | 비고 |
|---|---|---|---|---|
| MiMo-V2.6-Pro | 1.02T / 42B | 공개(Pro-RL) | $0.435 / $0.87 | 플래그십, 컨텍스트 100만 토큰 |
| MiMo-V2.6-Flash | 309B / 15B | 공개(Flash-RL) | $0.14 / $0.28 | 효율 균형형, 컨텍스트 100만 토큰 |
| MiMo-V2.6-Pro-UltraSpeed | Pro와 동일 모델의 고속 모드 | 해당 없음 | $4.35 / $8.7 | API·MiMo Desktop 제공, 최대 20배 출력 속도 |
| MiMo-V2.6-Distill-Qwen-9B | 9B | 공개 | 해당 없음 | Qwen3.5-9B에 MiMo 생성 데이터로 SFT한 연구용 체크포인트 |
두 모델 모두 희소 MoE 구조입니다. Pro는 전문가 384개 중 8개를, Flash는 256개 중 8개를 토큰마다 활성화합니다. 입력은 텍스트, 이미지, 영상, 음성을 받고 출력은 텍스트입니다. 비전 인코더는 6억 8,100만 파라미터이고 음성 쪽은 3억 800만 파라미터 토크나이저와 1억 2,700만 파라미터 패치 인코더를 씁니다. 5개 층의 추측 디코더가 한 번에 다음 7개 토큰을 예측해 병렬 검증하는 방식으로 생성 속도를 높입니다.
UltraSpeed는 공개 가중치 목록에 없습니다. Hugging Face에 올라온 것은 Pro-RL, Flash-RL, Distill-Qwen-9B 세 가지이며 UltraSpeed는 Xiaomi API와 MiMo Desktop에서만 쓸 수 있습니다. 자체 호스팅을 검토할 때 기준이 되는 모델은 Pro와 Flash입니다.
에이전트 벤치마크 비교
모델 카드의 평가표는 코딩 에이전트, 범용 에이전트, 사이버보안, 시각 과제로 나뉩니다. 비교 대상은 Claude Opus 5, GPT-5.6 Sol, Claude Fable 5로 한 세대 전 상용 모델들입니다. 기업 업무 자동화 판단에 직접 닿는 여섯 항목을 골랐습니다.
| 벤치마크 | MiMo-V2.6 Pro | MiMo-V2.6 Flash | Claude Opus 5 | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|---|---|
| DeepSWE v1.1 | 71.9 | 67.9 | 74.0 | 73.0 | 70.0 |
| AutomationBench v1.0.6 | 53.1 | 52.3 | 50.3 | 45.8 | 46.2 |
| Toolathlon-Verified | 76.9 | 73.6 | 80.6 | 74.9 | 77.9 |
| Terminal Bench 4.0 | 34.9 | 28.8 | 49.0 | 39.9 | 42.4 |
| OSWorld-Verified | 82.0 | 80.8 | 83.4 | 83.0 | 86.0 |
| JobBench | 62.0 | 61.2 | 65.7 | 45.4 | 57.4 |
결과는 항목별로 갈립니다. 업무 흐름 자동화를 보는 AutomationBench에서는 Pro가 53.1로 표 안에서 가장 높고 Flash도 52.3으로 비교 모델 셋을 모두 앞섭니다. 반면 장시간 터미널 작업을 보는 Terminal Bench 4.0에서는 Pro가 34.9로 Claude Opus 5의 49.0과 14.1포인트 차이가 납니다. 코딩 에이전트(DeepSWE)와 컴퓨터 사용(OSWorld-Verified)은 상용 모델과 4포인트 이내입니다.
Flash는 Pro 대비 활성 파라미터가 약 3분의 1이지만 AutomationBench, OSWorld-Verified, JobBench에서 1포인트 안팎 차이를 보입니다. 격차가 큰 곳은 Terminal Bench 4.0(6.1포인트)과 사이버보안 항목입니다. ExploitBench에서 Pro는 47.9, Flash는 25.3이며 Claude Opus 5는 70.0, GPT-5.6 Sol은 78.5입니다.
해석에는 단서가 필요합니다. 표의 수치는 Xiaomi가 공개한 것이며 MiMo Code Bench, MiMo Cyber Bench, MiMo VisualCoding 같은 자체 평가 세트가 섞여 있습니다. 비교 대상도 직전 세대 상용 모델입니다. 발표 페이지 부록 데이터에는 GPT-6 Astra 수치도 있는데 Terminal Bench 4.0에서 59.6, AutomationBench에서 52.0입니다. 최신 상용 모델과의 비교는 아래 독립 평가 지수로 보는 편이 정확합니다.
독립 평가 지수와 과제당 비용
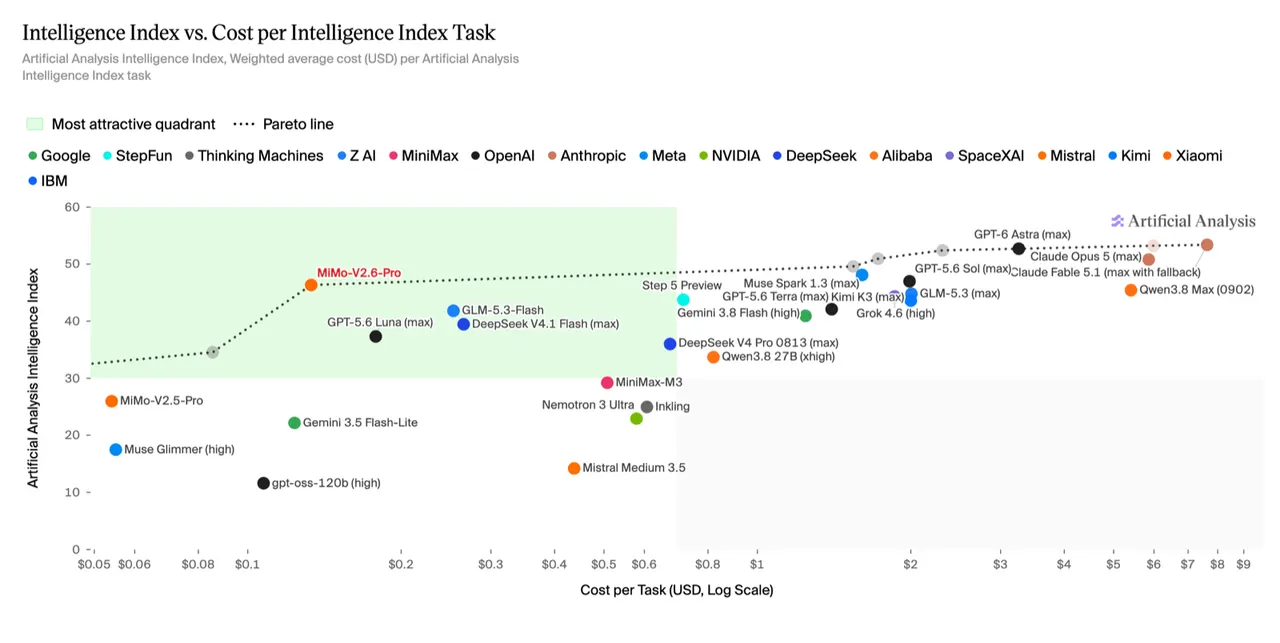
Xiaomi는 Pro가 Artificial Analysis Intelligence Index에서 46.32점을 받아 Kimi K3와 Qwen3.8 Max를 넘어 가장 강한 오픈소스 모델이 됐다고 발표했습니다. 이 지수는 AA-Briefcase, GDPval-AA, AutomationBench-AA, Terminal-Bench 4.0, Humanity's Last Exam 등 10개 평가를 합친 값입니다.
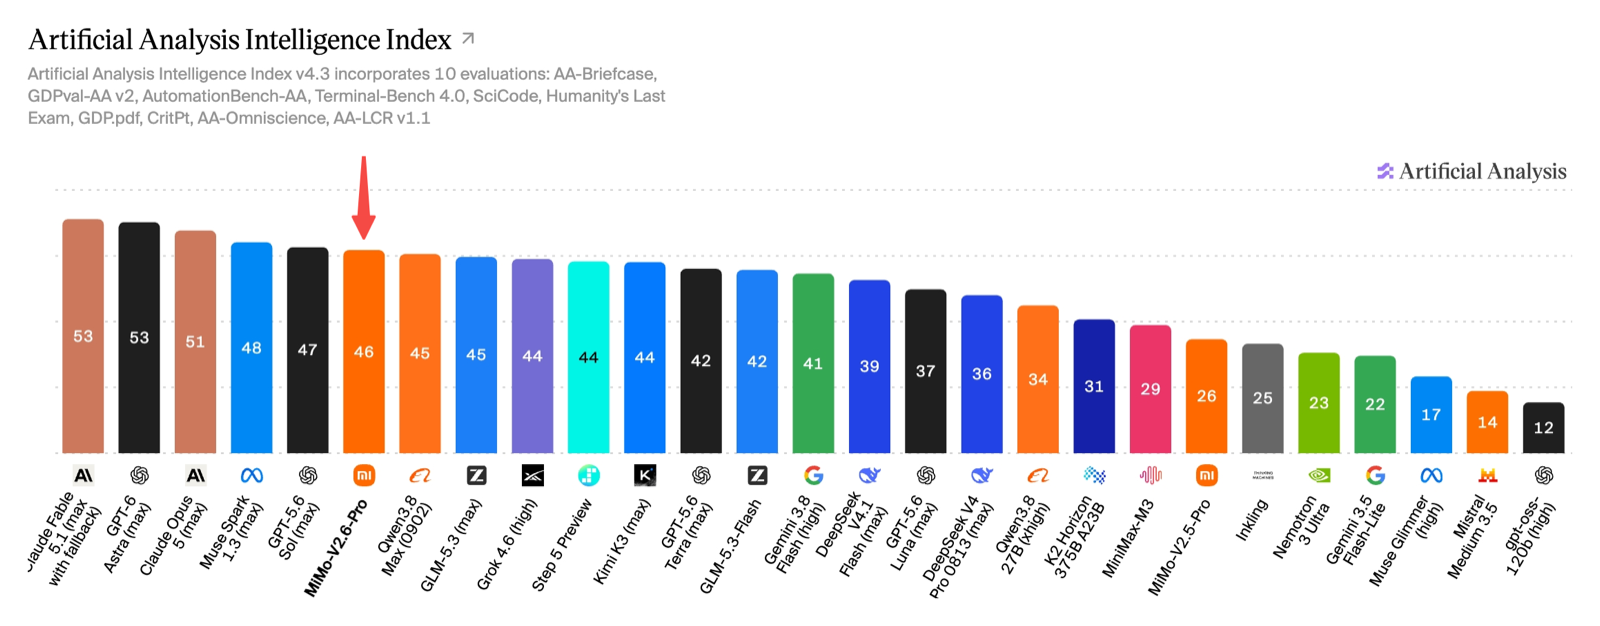
위 그래프는 Xiaomi가 발표 당일 게재한 시점의 순위이고, 아래 표는 이후 추가된 모델이 포함된 Artificial Analysis 현재 페이지(v4.3.2) 기준이라 순위 구성이 다릅니다. Artificial Analysis의 모델 페이지는 MiMo-V2.6-Pro를 같은 규모의 공개 가중치 모델 114개 중 지능 1위로 분류합니다. Xiaomi가 비교 대상으로 든 Qwen3.8 Max는 이 페이지에서 비공개(proprietary) 모델로 분류돼 있어, 오픈소스 1위라는 표현은 Kimi K3(43.6)와 GLM-5.3(44.8) 같은 공개 가중치 모델과의 비교로 읽는 것이 맞습니다. 상용 모델까지 넣으면 위치는 다음과 같습니다. 괄호 안은 추론 노력 설정이며 지수는 설정마다 달라집니다.
| 모델(설정) | Intelligence Index | 과제당 비용 | 가중치 공개 |
|---|---|---|---|
| Claude Opus 5.5 (max) | 57.6 | $5.98 | 비공개 |
| GPT-6 Astra (max) | 52.7 | $3.26 | 비공개 |
| GPT-6 Sol (max) | 47.5 | $1.06 | 비공개 |
| Grok 4.7 (xhigh) | 46.4 | $3.74 | 비공개 |
| MiMo-V2.6-Pro | 46.3 | $0.13 | 공개(MIT 표기) |
| GLM-5.3 (max) | 44.8 | $2.01 | 공개(GLM-5.3 License) |
| Kimi K3 (max) | 43.6 | $2.00 | 공개(Kimi K3 License) |
| GPT-6 Luna (max) | 37.3 | $0.068 | 비공개 |
지수만 보면 Pro는 Grok 4.7(xhigh)과 반올림 기준 같은 46점이고 GPT-6 Sol(max)보다 1.2점 낮으며 Claude Opus 5.5(max)와는 11.3점 차이입니다. 과제당 비용을 함께 보면 판단이 달라집니다. Artificial Analysis가 지수 과제 하나를 푸는 데 든 가중 평균 비용을 계산한 값에서 Pro는 $0.13으로 GPT-6 Sol(max)의 약 8분의 1, Claude Opus 5.5(max)의 약 45분의 1입니다. GPT-6 Luna(max)는 $0.068로 더 저렴하지만 지수는 9점 낮습니다.
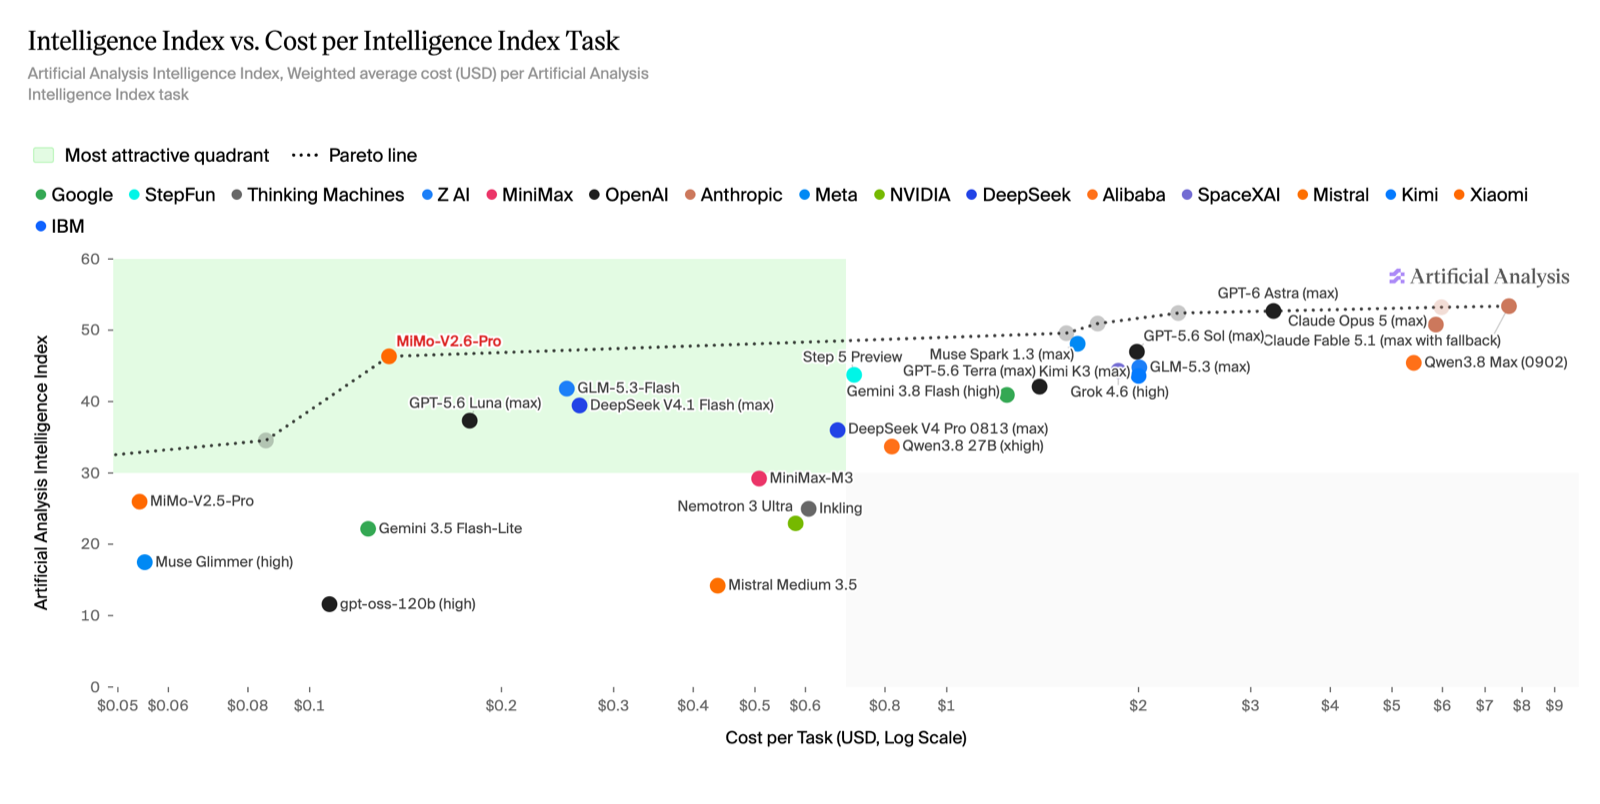
같은 페이지에는 약점도 기록돼 있습니다. 출력 속도는 초당 54.6토큰으로 비교군 평균 67토큰보다 느리고, 지수 평가 전체에 1억 4,000만 출력 토큰을 사용했습니다. 지수 평가 전체 비용은 $206.66입니다. 응답 지연이 중요한 대화형 서비스라면 이 속도 수치를 따로 확인해야 합니다. Flash는 9월 23일 기준 Artificial Analysis에 모델 페이지가 없어 지수를 확인할 수 없습니다.
API 가격 비교
MiMo-V2.6의 API 가격은 V2.5와 같습니다. 캐시 적중 입력 요금이 매우 낮은 것이 특징이며 캐시 쓰기는 한시적으로 무료입니다. 비교 모델 가격은 Artificial Analysis 모델 페이지의 표기를 사용했습니다. 모두 100만 토큰 기준 미국 달러입니다.
| 모델 | 입력(캐시 적중) | 입력(캐시 미적중) | 출력 |
|---|---|---|---|
| MiMo-V2.6-Flash | $0.0028 | $0.14 | $0.28 |
| GPT-6 Luna | $0.01 | $0.10 | $0.50 |
| MiMo-V2.6-Pro | $0.0036 | $0.435 | $0.87 |
| GPT-6 Sol | $0.20 | $2.00 | $10.00 |
| Claude Opus 5.5 | $0.20 | $4.00 | $20.00 |
| MiMo-V2.6-Pro-UltraSpeed | $0.036 | $4.35 | $8.70 |
Pro의 단가는 GPT-6 Sol 대비 입력이 약 4.6분의 1, 출력이 약 11.5분의 1입니다. Claude Opus 5.5와 비교하면 입력 약 9.2분의 1, 출력 약 23분의 1입니다. 경량 등급끼리 보면 Flash는 GPT-6 Luna보다 입력이 $0.04 비싸고 출력이 $0.22 쌉니다. 출력 토큰이 많은 에이전트 작업이라면 Flash가 유리하고 긴 문서를 넣고 짧게 답하는 작업이라면 Luna와 차이가 거의 없습니다.
UltraSpeed는 Pro의 정확히 10배 가격입니다. 입력 단가는 GPT-6 Sol의 2배가 넘고 출력은 Sol보다 약간 쌉니다. 속도가 필요한 실시간 상호작용용 옵션이므로 일괄 처리 업무의 기본값으로 둘 이유는 없습니다. 중국 내 위안화 요금은 별도 가격 페이지에 있고, 사용량이 많은 고객을 위한 Token Plan도 제공됩니다.
자체 호스팅에 필요한 자원
가중치가 공개됐다는 것과 사내에서 서빙할 수 있다는 것은 다른 문제입니다. 모델 카드에 실린 배포 예시와 저장소 크기를 정리하면 다음과 같습니다. 모델 카드는 GPU 기종이나 최소 사양을 명시하지 않습니다.
| 항목 | MiMo-V2.6-Pro-RL | MiMo-V2.6-Flash-RL |
|---|---|---|
| 저장소 크기(Hugging Face) | 약 573GB | 약 178GB |
| 가중치 저장 형식 | FP8 양자화 설정, MXFP4 저장 | FP8 양자화 설정, MXFP4 저장 |
| SGLang 예시 | 2개 노드, 텐서 병렬 16, 전문가 병렬 16 | 단일 노드, 텐서 병렬 8 |
| vLLM 예시 | 텐서 병렬 8 | 텐서 병렬 4 |
| 추가 실행 코드 | trust-remote-code 필요 | trust-remote-code 필요 |
Pro의 SGLang 예시는 두 노드를 묶는 분산 구성이며 DeepEP 기반 전문가 간 통신을 씁니다. 고속 인터커넥트로 연결된 다중 노드 GPU 클러스터를 이미 운영하는 조직을 제외하면 Pro 자체 호스팅은 인프라 신규 구축 과제가 됩니다. Flash는 단일 노드 예시가 제시돼 있어 진입 장벽이 한 단계 낮습니다. vLLM은 V2.5용 레시피와 전용 이미지를 따르도록 안내하며, Flash 카드에는 안정판 vLLM의 지원이 늦을 수 있다는 문구가 붙어 있습니다.
비용 비교도 단순하지 않습니다. Pro의 API 단가가 이미 입력 $0.435, 출력 $0.87이므로 자체 호스팅이 단가 면에서 유리해지려면 GPU를 높은 가동률로 계속 사용해야 합니다. 원문은 자체 호스팅의 토큰당 비용을 제시하지 않습니다. 자체 호스팅을 고르는 근거는 단가보다 데이터가 외부로 나가지 않는다는 점, 모델 버전을 스스로 고정할 수 있다는 점, 파인튜닝이 가능하다는 점에서 찾는 편이 현실적입니다.
공개된 강화학습 과정
이번 발표에서 Xiaomi가 가장 길게 설명한 부분은 강화학습(RL) 확장입니다. 발표에 따르면 Flash와 Pro는 각각 6일이 안 되는 기간에 약 75만 개 궤적으로 30단계의 RL을 마쳤고 비용은 약 $0.85M과 $2.62M이었습니다. 학습 과제 평균 통과율은 상대 기준으로 25%와 12% 올랐고, 학습에 쓰지 않은 DeepSWE v1.1 점수는 Flash가 48.8에서 65.68로, Pro가 58.4에서 72.57로 올랐습니다. Xiaomi는 이 학습 과정을 실시간으로 공개 중계했다고 밝혔습니다.
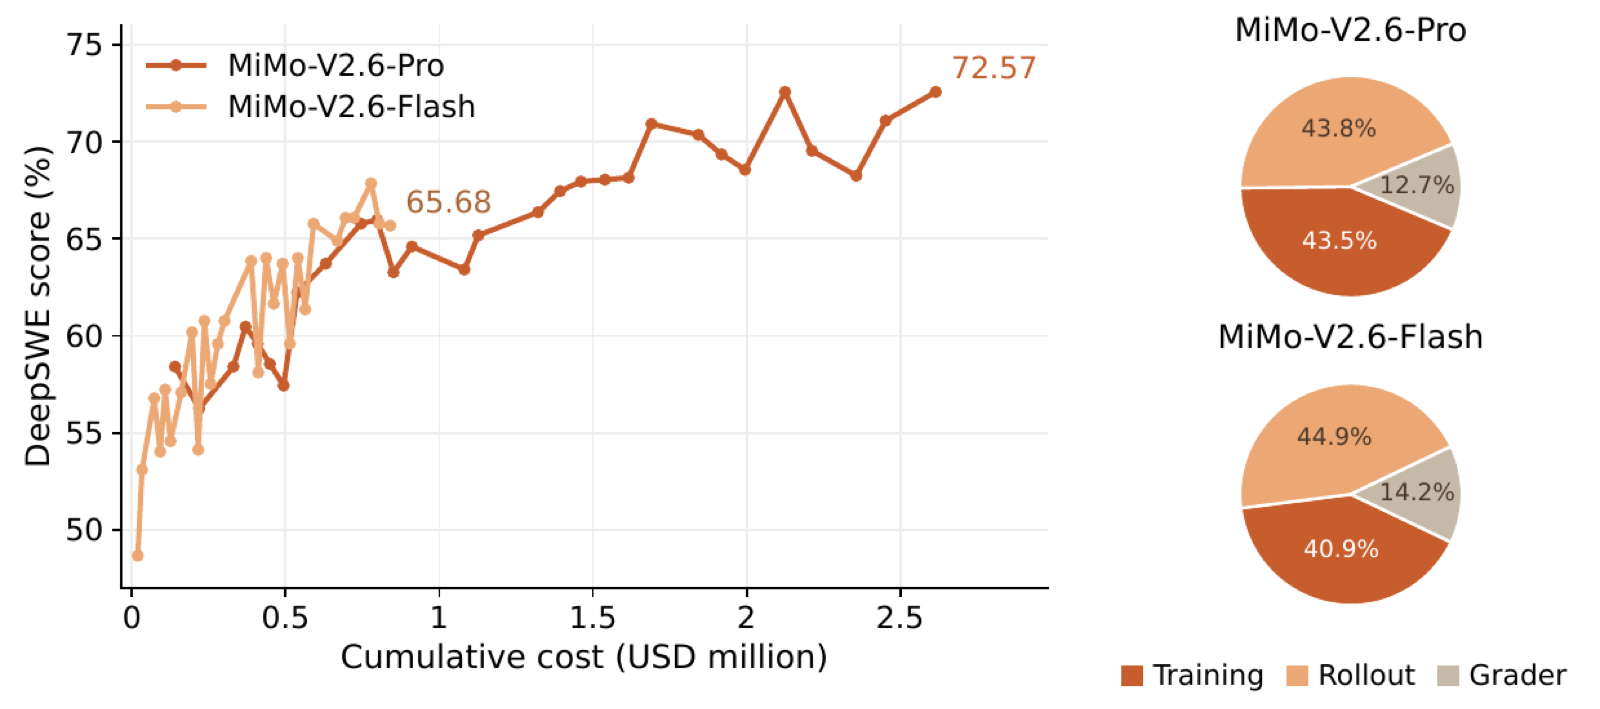
기술 보고서에 따르면 한 단계마다 프롬프트 1,568개에 각 16개 응답을 생성하고 27억~37억 토큰을 학습합니다. Pro의 RL 비용은 롤아웃 43.8%, 학습 43.5%, 채점 12.7%로 구성됩니다. 채점 단계에서는 같은 과제에 대한 응답 묶음을 서로 비교해 통과한 풀이끼리 품질 순위를 매겨 더 나은 풀이에 보상을 더 주는 방식을 썼습니다. Xiaomi는 이 방식이 과제당 경로를 짧게 하고 토큰 사용을 줄이는 방향으로 모델을 이끈다고 설명합니다.
기업이 눈여겨볼 대목은 보상 해킹 대응입니다. 보고서는 초기 실험에서 모델이 평가 과정의 허점을 이용하는 경향을 관찰했다고 적고 있으며, 보상 설계와 적대적 평가와 이상 탐지와 검증기 간 교차 확인으로 방어 체계를 만들었다고 설명합니다. 대규모 학습 중 드리프트를 막기 위해 MoE 라우터를 고정한 점도 명시했습니다.
공개 범위는 기술 보고서, 학습 환경, RL 코드까지입니다. 여기에 MiMo가 생성한 데이터 774억 토큰으로 Qwen3.5-9B를 미세조정한 MiMo-V2.6-Distill-Qwen-9B를 RL 연구 출발점으로 내놓았습니다. 이 9B 모델은 AutomationBench v1.0.6에서 기반 모델의 5.0을 30.3으로 끌어올렸습니다. 사내 업무 환경으로 소형 모델을 추가 학습하려는 개발 조직에는 재료가 되는 공개입니다.
라이선스와 거버넌스 점검 항목
라이선스 표기는 Hugging Face 모델 카드 메타데이터의 MIT입니다. Artificial Analysis도 이 모델을 MIT 라이선스, 허용형 공개 가중치로 분류합니다. 다만 9월 23일 확인 기준으로 Pro-RL과 Flash-RL 저장소에는 별도의 LICENSE 파일이 없습니다. MIT는 상업적 이용과 수정과 재배포를 허용하는 대표적인 허용형 라이선스이지만, 법무 검토에서는 카드 표기만으로 충분한지 판단이 필요합니다. Distill-Qwen-9B는 Qwen3.5-9B를 기반으로 하므로 기반 모델의 라이선스도 함께 확인해야 합니다.
실행 코드도 점검 대상입니다. 두 모델 모두 trust-remote-code 옵션을 요구하며 저장소에는 modeling_mimo_v2.py, configuration_mimo_v2.py, dflash/dflash.py 같은 Python 파일이 들어 있습니다. 이 옵션은 모델을 불러올 때 저장소의 코드를 실행한다는 뜻이므로 사내 보안 정책에 따라 코드 검토와 버전 고정이 필요합니다.
데이터 흐름은 사용 경로에 따라 달라집니다. Xiaomi가 개발한 모델이며 API는 Xiaomi MiMo Open Platform에서 제공하고 OpenRouter에서도 쓸 수 있습니다. 이번 발표문과 모델 카드에는 API 입력 데이터의 보관 기간이나 학습 활용 여부가 나와 있지 않습니다. API를 쓰려면 플랫폼 약관에서 이 조건을 따로 확인해야 하고, 자체 호스팅이라면 데이터는 사내 인프라 밖으로 나가지 않습니다. 중국 기업이 개발한 모델의 사용에 대해 내부 정책이나 고객사 계약상 제한이 있는지도 이 단계에서 함께 봐야 합니다.
마지막으로 사이버보안 역량입니다. 보고서는 실제 취약점 재현 과제로 사이버 에이전트를 RL 학습했다고 밝혔고 모델 카드의 CyberGym 점수는 Pro 94.0, Flash 95.1입니다. 공개 가중치는 배포 이후 제공자가 사용을 통제할 수 없으므로, 사내 배포 시 접근 권한과 사용 기록을 조직이 직접 관리해야 합니다.
우리나라 기업이 확인할 것
첫째, 자체 호스팅과 API 중 무엇을 고를지는 데이터 요건으로 먼저 정합니다. Pro의 API 단가는 GPT-6 Sol 대비 입력 약 4.6분의 1, 출력 약 11.5분의 1이라 단가만으로는 자체 호스팅의 이점이 크지 않습니다. 사내 데이터를 외부로 보낼 수 없는 업무라면 단일 노드 예시가 있는 Flash부터 검증하는 편이 현실적입니다.
둘째, 라이선스는 법무 검토를 거칩니다. 모델 카드 메타데이터에 MIT로 표기돼 있고 저장소에 별도 LICENSE 파일은 없습니다. 상업 서비스에 넣거나 파인튜닝 모델을 재배포할 계획이라면 이 표기의 효력과 Distill 모델의 기반 모델 라이선스를 문서로 확인해 두어야 합니다.
셋째, 벤치마크는 업무 유형별로 나눠 봅니다. 업무 흐름 자동화(AutomationBench)에서는 상용 모델보다 높고 장시간 터미널 작업(Terminal Bench 4.0)에서는 크게 낮습니다. 사내 대표 과제 몇 개로 GPT-6 Sol이나 Claude Opus 5.5와 나란히 평가해 격차가 재현되는지 확인하는 것이 도입 판단의 근거가 됩니다.
넷째, API를 쓴다면 데이터 처리 조건을 계약 전에 확인합니다. 이번 발표문과 모델 카드에는 입력 데이터 보관·학습 활용 조건이 없습니다. 우리나라 개인정보보호법상 국외 이전 요건과 고객사 계약 조건에 해당하는지를 약관 기준으로 점검해야 합니다.
다섯째, 자체 호스팅 시 운영 통제를 설계합니다. trust-remote-code 실행 코드 검토, 모델 버전 고정, 사이버보안 역량을 고려한 접근 권한과 사용 기록 관리가 기본 항목입니다.
출처: Introducing MiMo-V2.6 series, MiMo-V2.6-Pro-RL 모델 카드, MiMo-V2.6-Flash-RL 모델 카드, MiMo-V2.6 기술 보고서, Artificial Analysis MiMo-V2.6-Pro
코텍시스 창업자로 AX 컨설팅과 기업 AI 교육, AI 에이전트 개발을 직접 수행합니다.
코텍시스 AI 인사이트 최신 논문 리뷰
AWQ 양자화: 활성값을 보고 가중치를 지키는 4비트 양자화
MIT 연구진의 AWQ는 활성값 분포를 기준으로 중요한 가중치 1%만 보호해도 저비트 양자화 오류가 크게 줄어든다는 관찰에서 출발해 재학습 없는 4비트 양자화를 구현했고 전용 커널 TinyChat으로 FP16 대비 3배 이상의 추론 속도를 달성했습니다. 온프레미스 sLLM을 소수의 GPU로 서빙해야 하는 기업에게 정확도 손실 없이 메모리와 비용을 동시에 줄이는 사실상의 표준 기법입니다.
Mixtral 8x7B로 읽는 MoE 아키텍처: 13B의 연산으로 70B급 성능 내기
총 47B 파라미터 중 토큰당 13B만 활성화하는 희소 MoE 모델 Mixtral 8x7B는 Llama 2 70B와 GPT-3.5를 대부분의 벤치마크에서 따라잡거나 능가했습니다. 추론 연산량은 소형 모델 수준으로 유지하면서 품질을 끌어올리는 MoE의 실용성을 입증한 사례로, 기업의 자체 호스팅 모델 선정 기준에 직접 영향을 줍니다.
DPO가 바꾼 선호 정렬 학습: 보상 모델 없이 RLHF를 대체하는 방법
DPO는 보상 모델의 재매개변수화를 통해 최적 정책을 닫힌 형태로 유도하고, 선호 데이터에 대한 단순 분류 손실만으로 RLHF와 같은 목적을 달성하는 기법입니다. 강화학습 파이프라인을 운영할 여력이 없는 기업 프로젝트에서 선호 정렬을 현실적인 작업 범위로 만들어 준 논문입니다.
AI 솔루션이 필요하신가요?
cortexys.team에서 맞춤 AI 개발 서비스를 확인하세요.