AI 에이전트가 기기 밖으로 보내는 프롬프트와 도구 호출과 검색 질의를 지키는 Airlock을 소개합니다. 만든 이유와 동작 방식 그리고 측정 설계를 정리했습니다.
AI 에이전트에게 개인 문서를 맡길 때 기기를 떠나는 것은 프롬프트만이 아닙니다. 에이전트는 계획 단계마다 읽은 문서를 모델에 다시 보내고 도구 호출 인자를 보내며 검색 API로 질의를 보냅니다. Airlock은 이 출구를 한곳에서 지키는 AI 에이전트용 이그레스 방화벽입니다.
이 글은 Airlock 시리즈의 첫 편으로 만든 이유와 동작 방식과 측정 설계를 다룹니다. 측정 결과는 2편에 정리했습니다. 이 글은 Nebius × NVIDIA Global AI Hackathon 출품작의 일부로 작성했습니다.
에이전트가 정보를 내보내는 경로
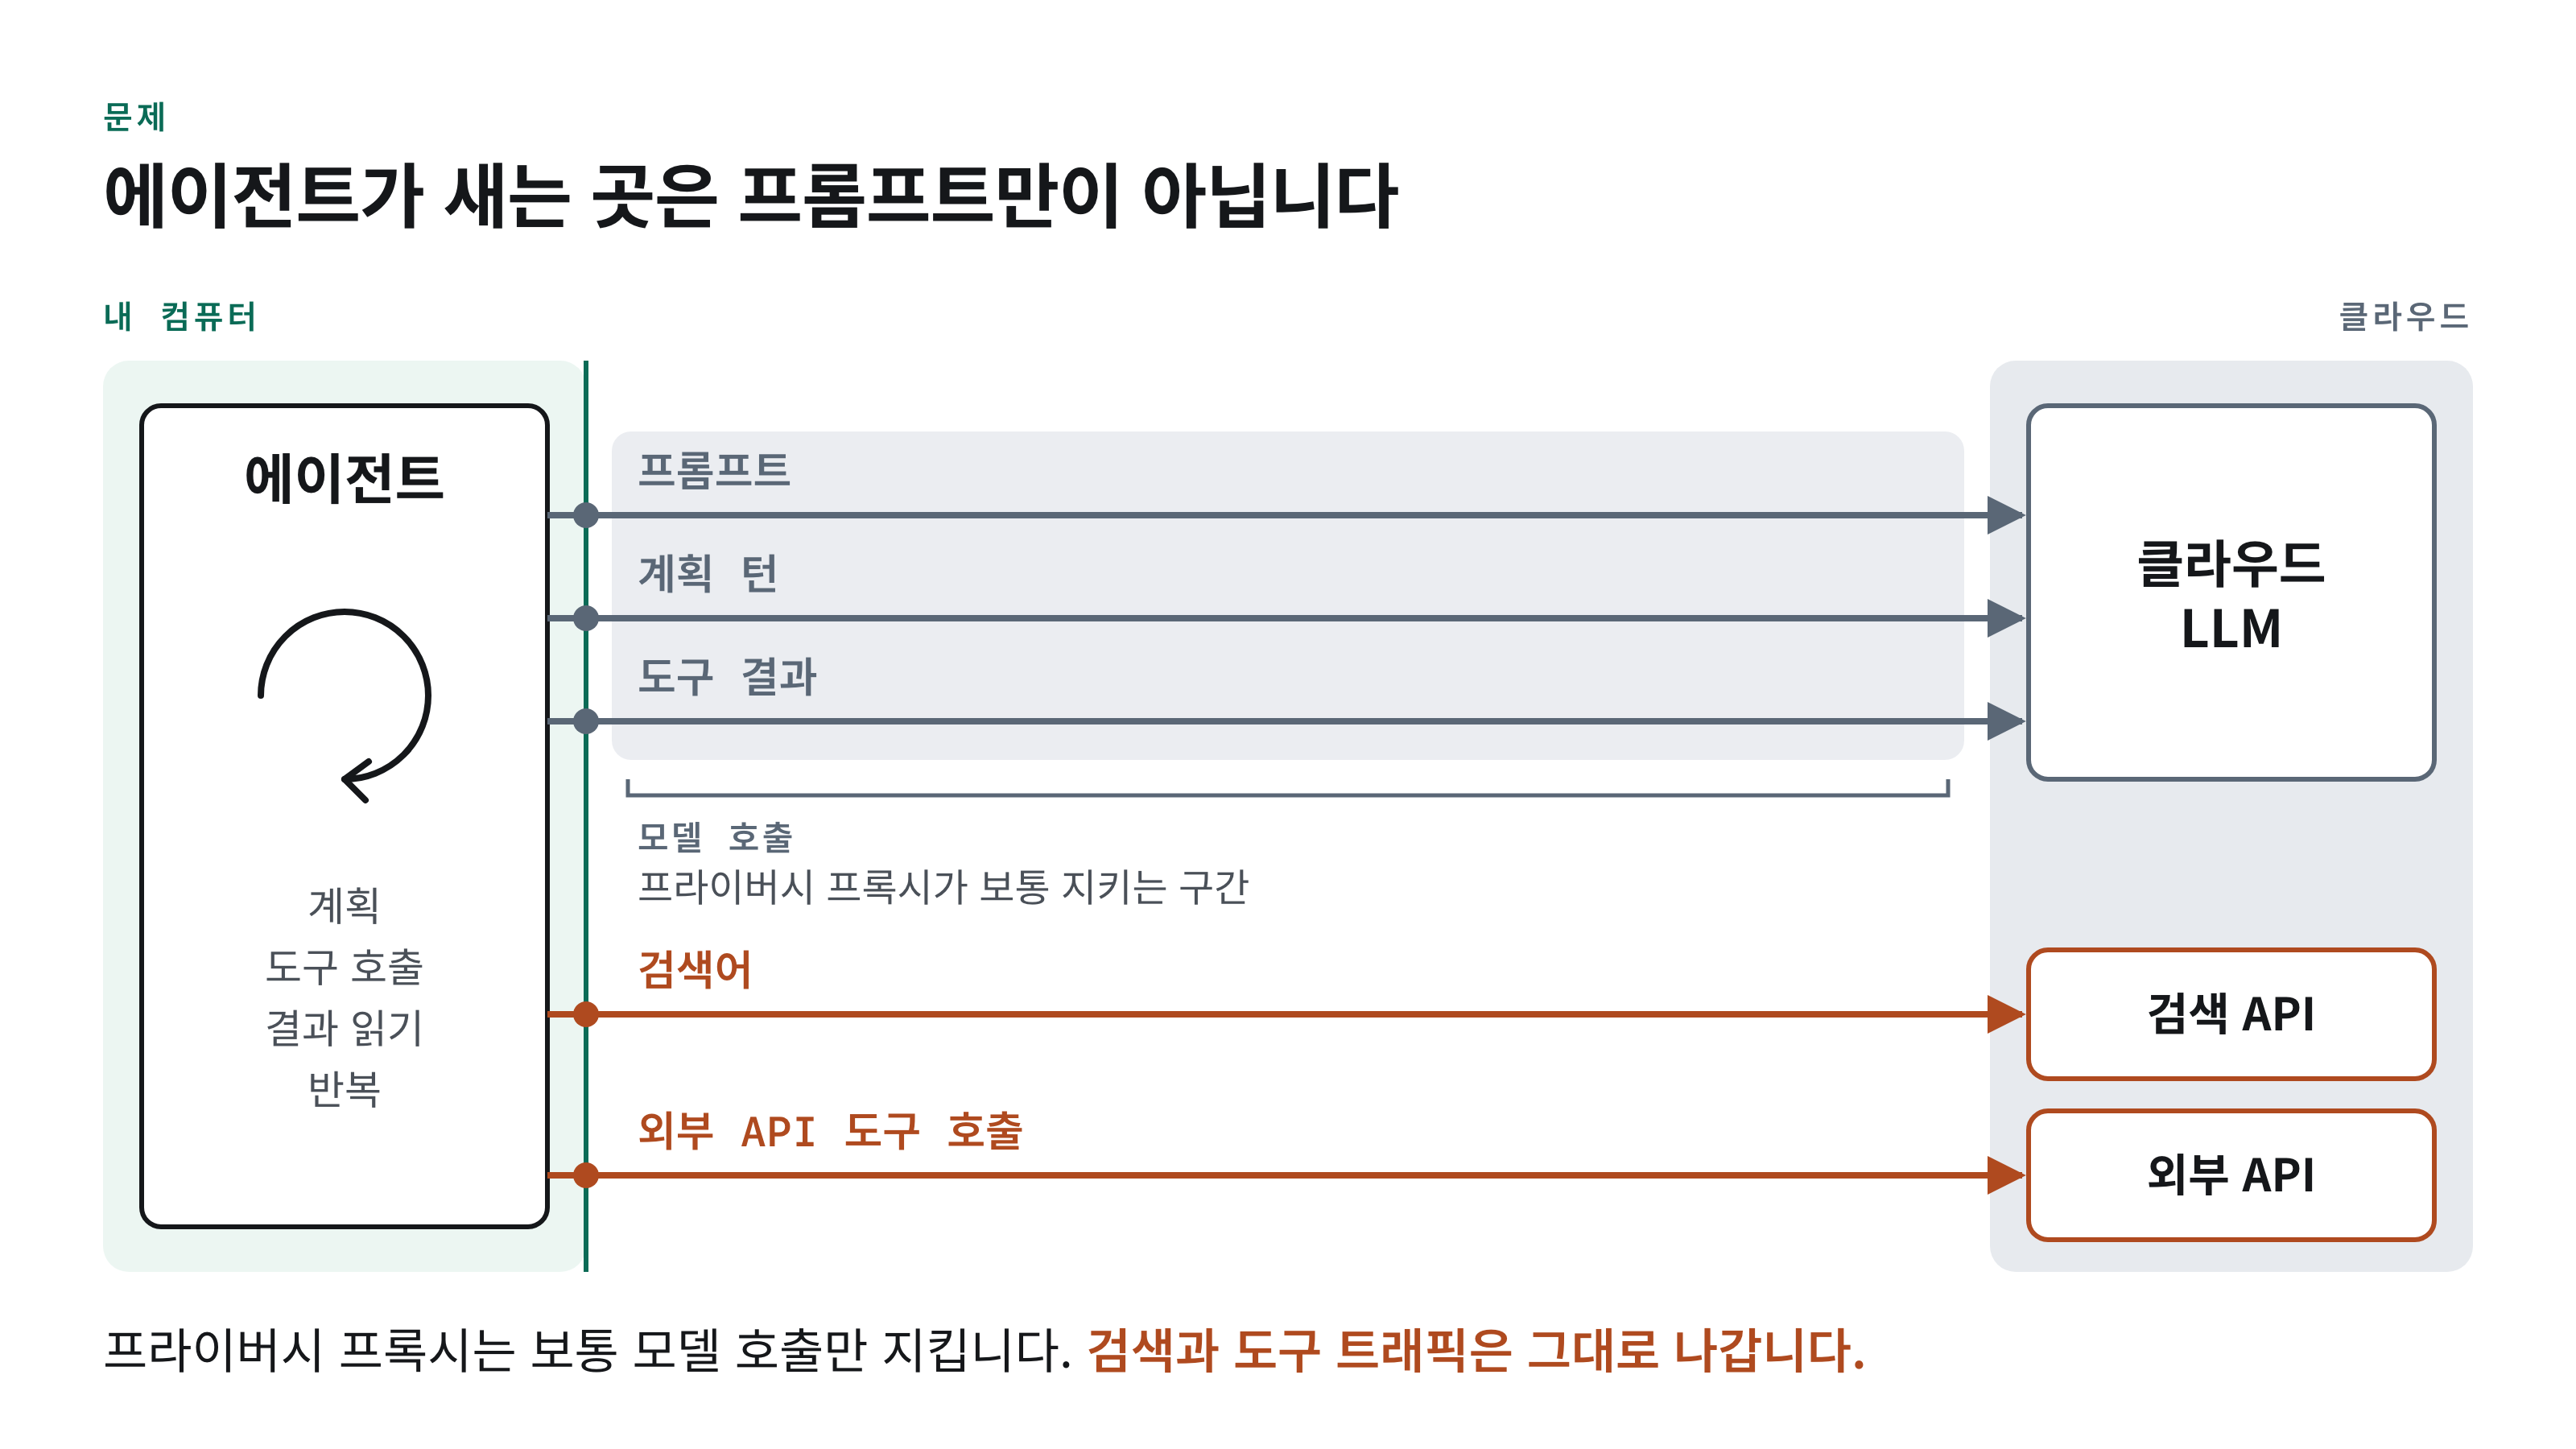
클라우드 AI를 꺼리는 가장 큰 이유는 유출입니다. 로컬 모델만 쓰면 유출은 피하지만 프론티어 모델보다 성능이 크게 떨어집니다.
에이전트는 통로를 더 늘립니다. 문서 내용은 계획 턴마다 클라우드 모델로 다시 가고 도구 호출 인자도 이력에 실려 반복 전송됩니다. 검색 질의는 모델 제공자와 다른 곳으로 갑니다. 대부분의 프라이버시 도구는 사용자와 모델 사이의 요청만 검사하고 검색 엔진과 도구 호출은 검사하지 않습니다.
짧은 질의도 안전하지 않습니다. <ORG_1> layoff list team lead how to respond에는 이름이 없지만 어떤 회사의 누군가가 정리해고 명단에 올랐다는 사실은 검색 제공자에게 전해집니다.
기존 도구로 부족한 부분
프롬프트를 가리고 답변을 복원하는 로컬 프록시는 새롭지 않습니다.
- PasteGuard는 GLiNER 기반 OpenAI 호환 프록시로 스트리밍 답변까지 복원합니다.
- Kiji Privacy Proxy는 양자화한 DistilBERT로 같은 일을 합니다.
- LiteLLM의 Presidio 가드레일은 게이트웨이에서 Presidio를 호출합니다.
- PAPILLON(NAACL 2025)은 로컬 모델이 API 모델에 보낼 질의를 재작성하는 구조를 제안하고 누출률도 측정했습니다.
작은 로컬 모델과 큰 클라우드 모델의 분업 구조도 선행 연구에 이미 있습니다.
기존 도구가 다루지 않는 부분은 에이전트의 다른 전송 경로입니다. MosaicLeaks(Gurung et al., 2026)는 딥리서치 에이전트의 검색 질의만 보고도 사내 문서 내용을 추론할 수 있음을 보였습니다. 제안된 해법은 에이전트 재학습이라 기존 에이전트에 그대로 적용할 수 없습니다. AWS Bedrock Guardrails 문서는 도구 호출 인자와 도구 결과를 검사하지 않는다고 밝힙니다. 앞의 프록시들도 README에서 도구 호출이나 검색 질의 검사를 언급하지 않습니다. 코드까지 확인하지는 않은 문서 기준의 판단입니다.
실제로 기기를 떠난 바이트를 기준으로 누출률을 반복 측정해 공개한 제품도 찾지 못했습니다. 학술 연구는 누출률을 이미 측정하므로 Airlock이 처음이라고 말할 수는 없습니다. Airlock이 더하려는 것은 제품 수준에서 공개 하네스로 베이스라인과 같은 조건에서 반복한 측정입니다.
Airlock이 지키려는 것
목표는 의도적으로 좁습니다. 클라우드는 문제를 알아도 됩니다. 그 문제가 누구의 것인지는 몰라야 합니다.
신원은 이름과 회사명과 전화번호와 비밀값 그리고 하나씩은 무해해도 겹치면 한 사람을 가리키는 준식별자입니다. 상황은 진단명과 해고 조건과 금액처럼 모델이 도우려면 읽어야 하는 내용입니다. 상황까지 가리면 답변이 쓸모없어지므로 Airlock은 신원을 지우거나 일반화하고 상황은 남깁니다. 기본 수준에서 금액과 검사 수치와 진단명은 그대로 두고 "마흔다섯"은 "40대"로 바꿉니다.
사용법은 OpenAI 호환 앱의 base_url을 http://127.0.0.1:8787/v1로 바꾸는 것뿐입니다.
동작 방식
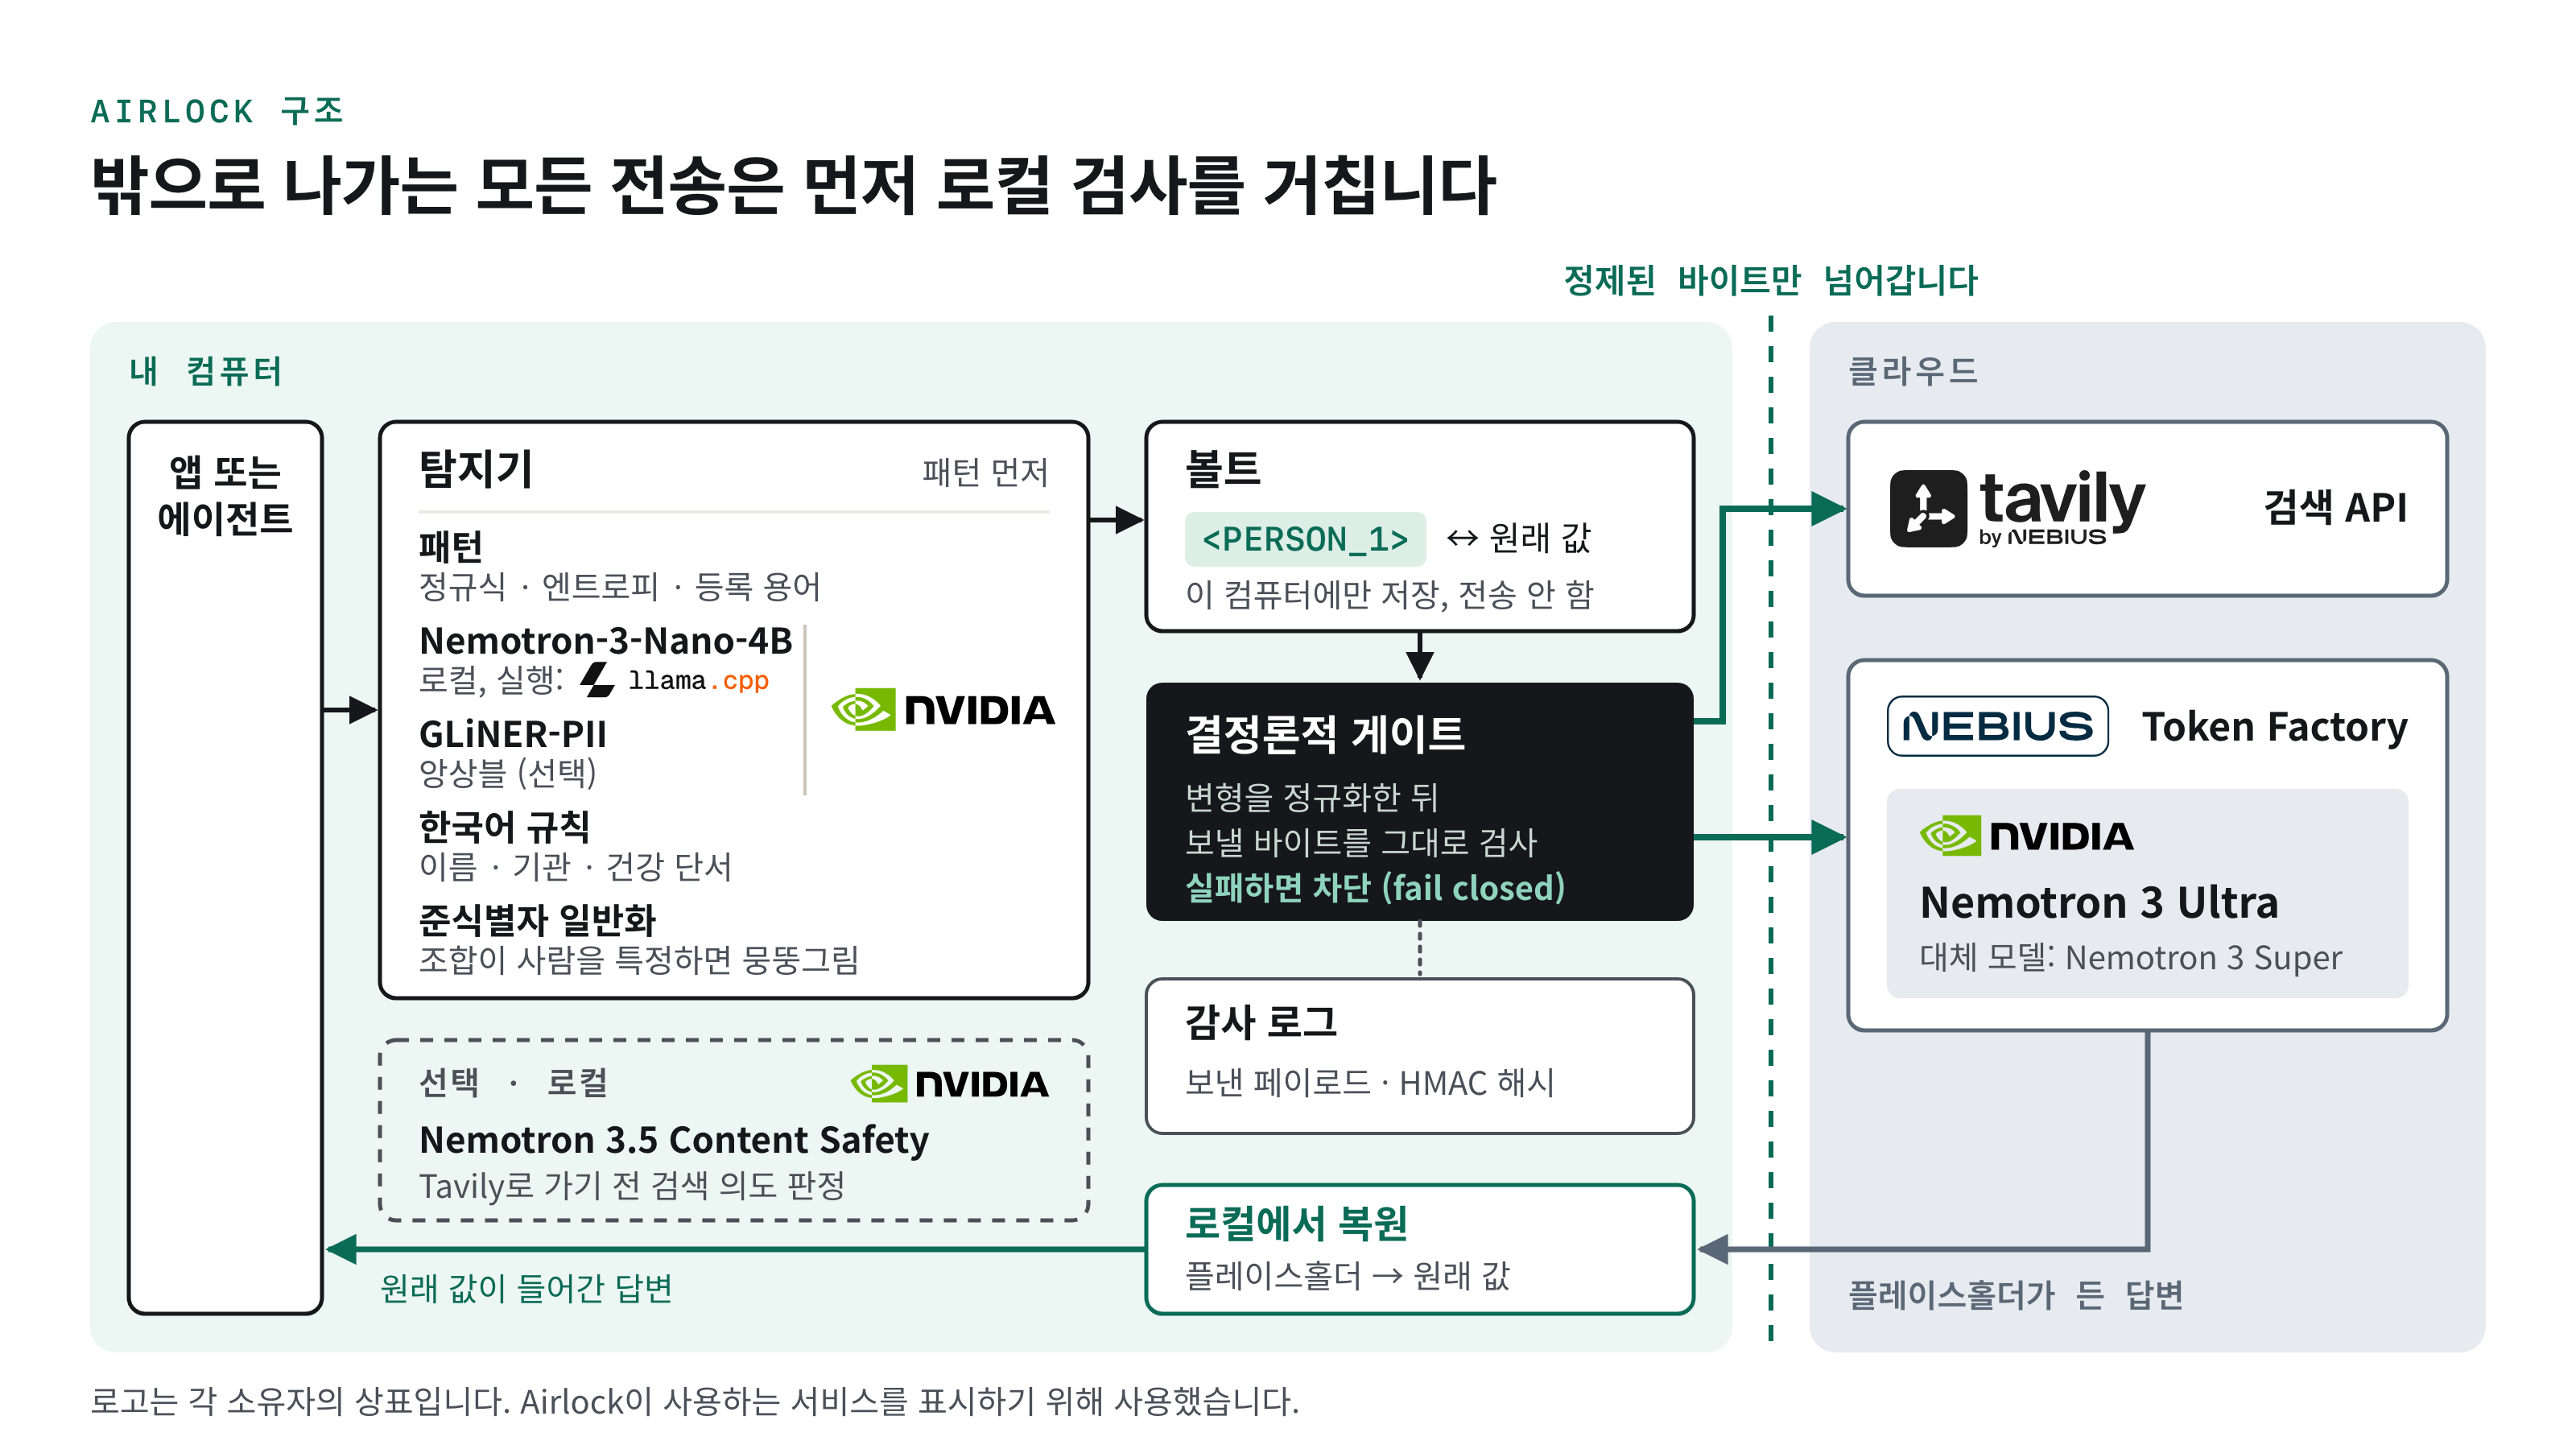
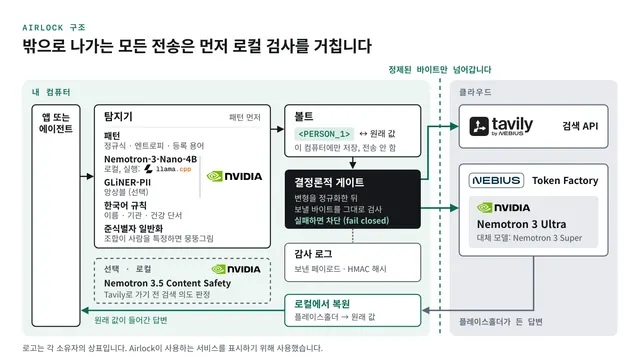
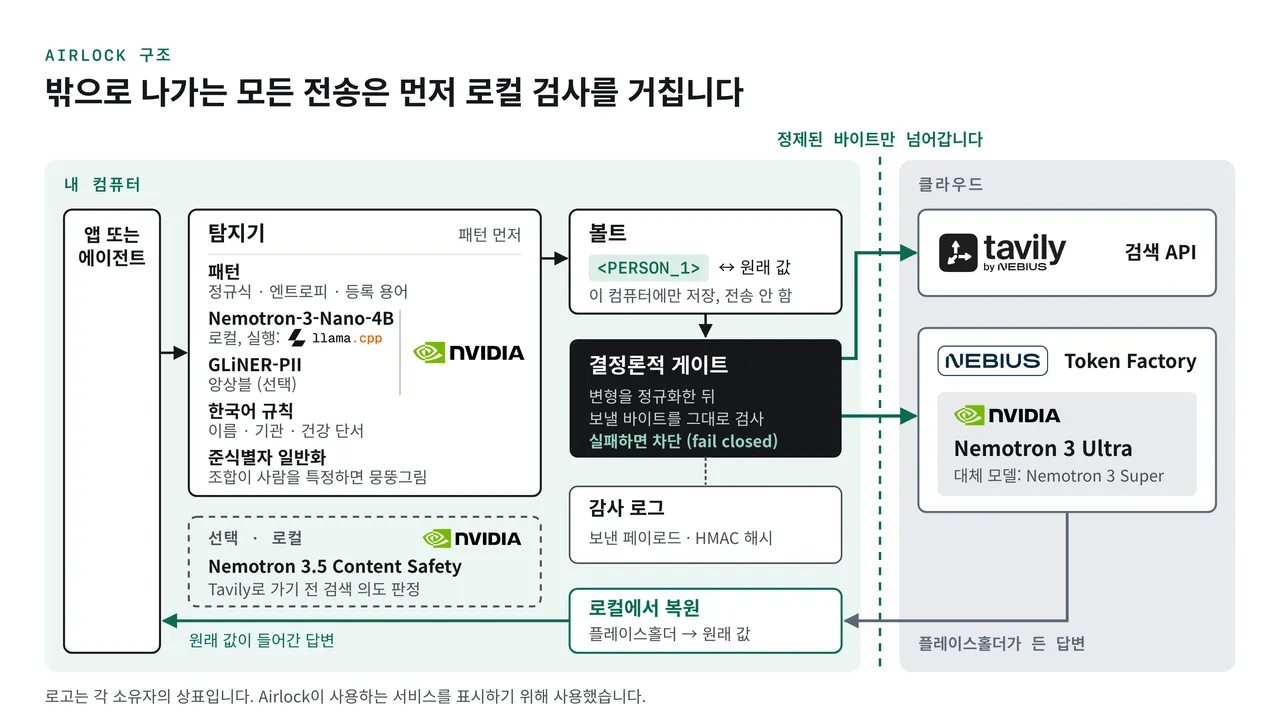
요청 하나는 기기 안에서 다섯 단계를 거친 뒤에야 나갑니다.
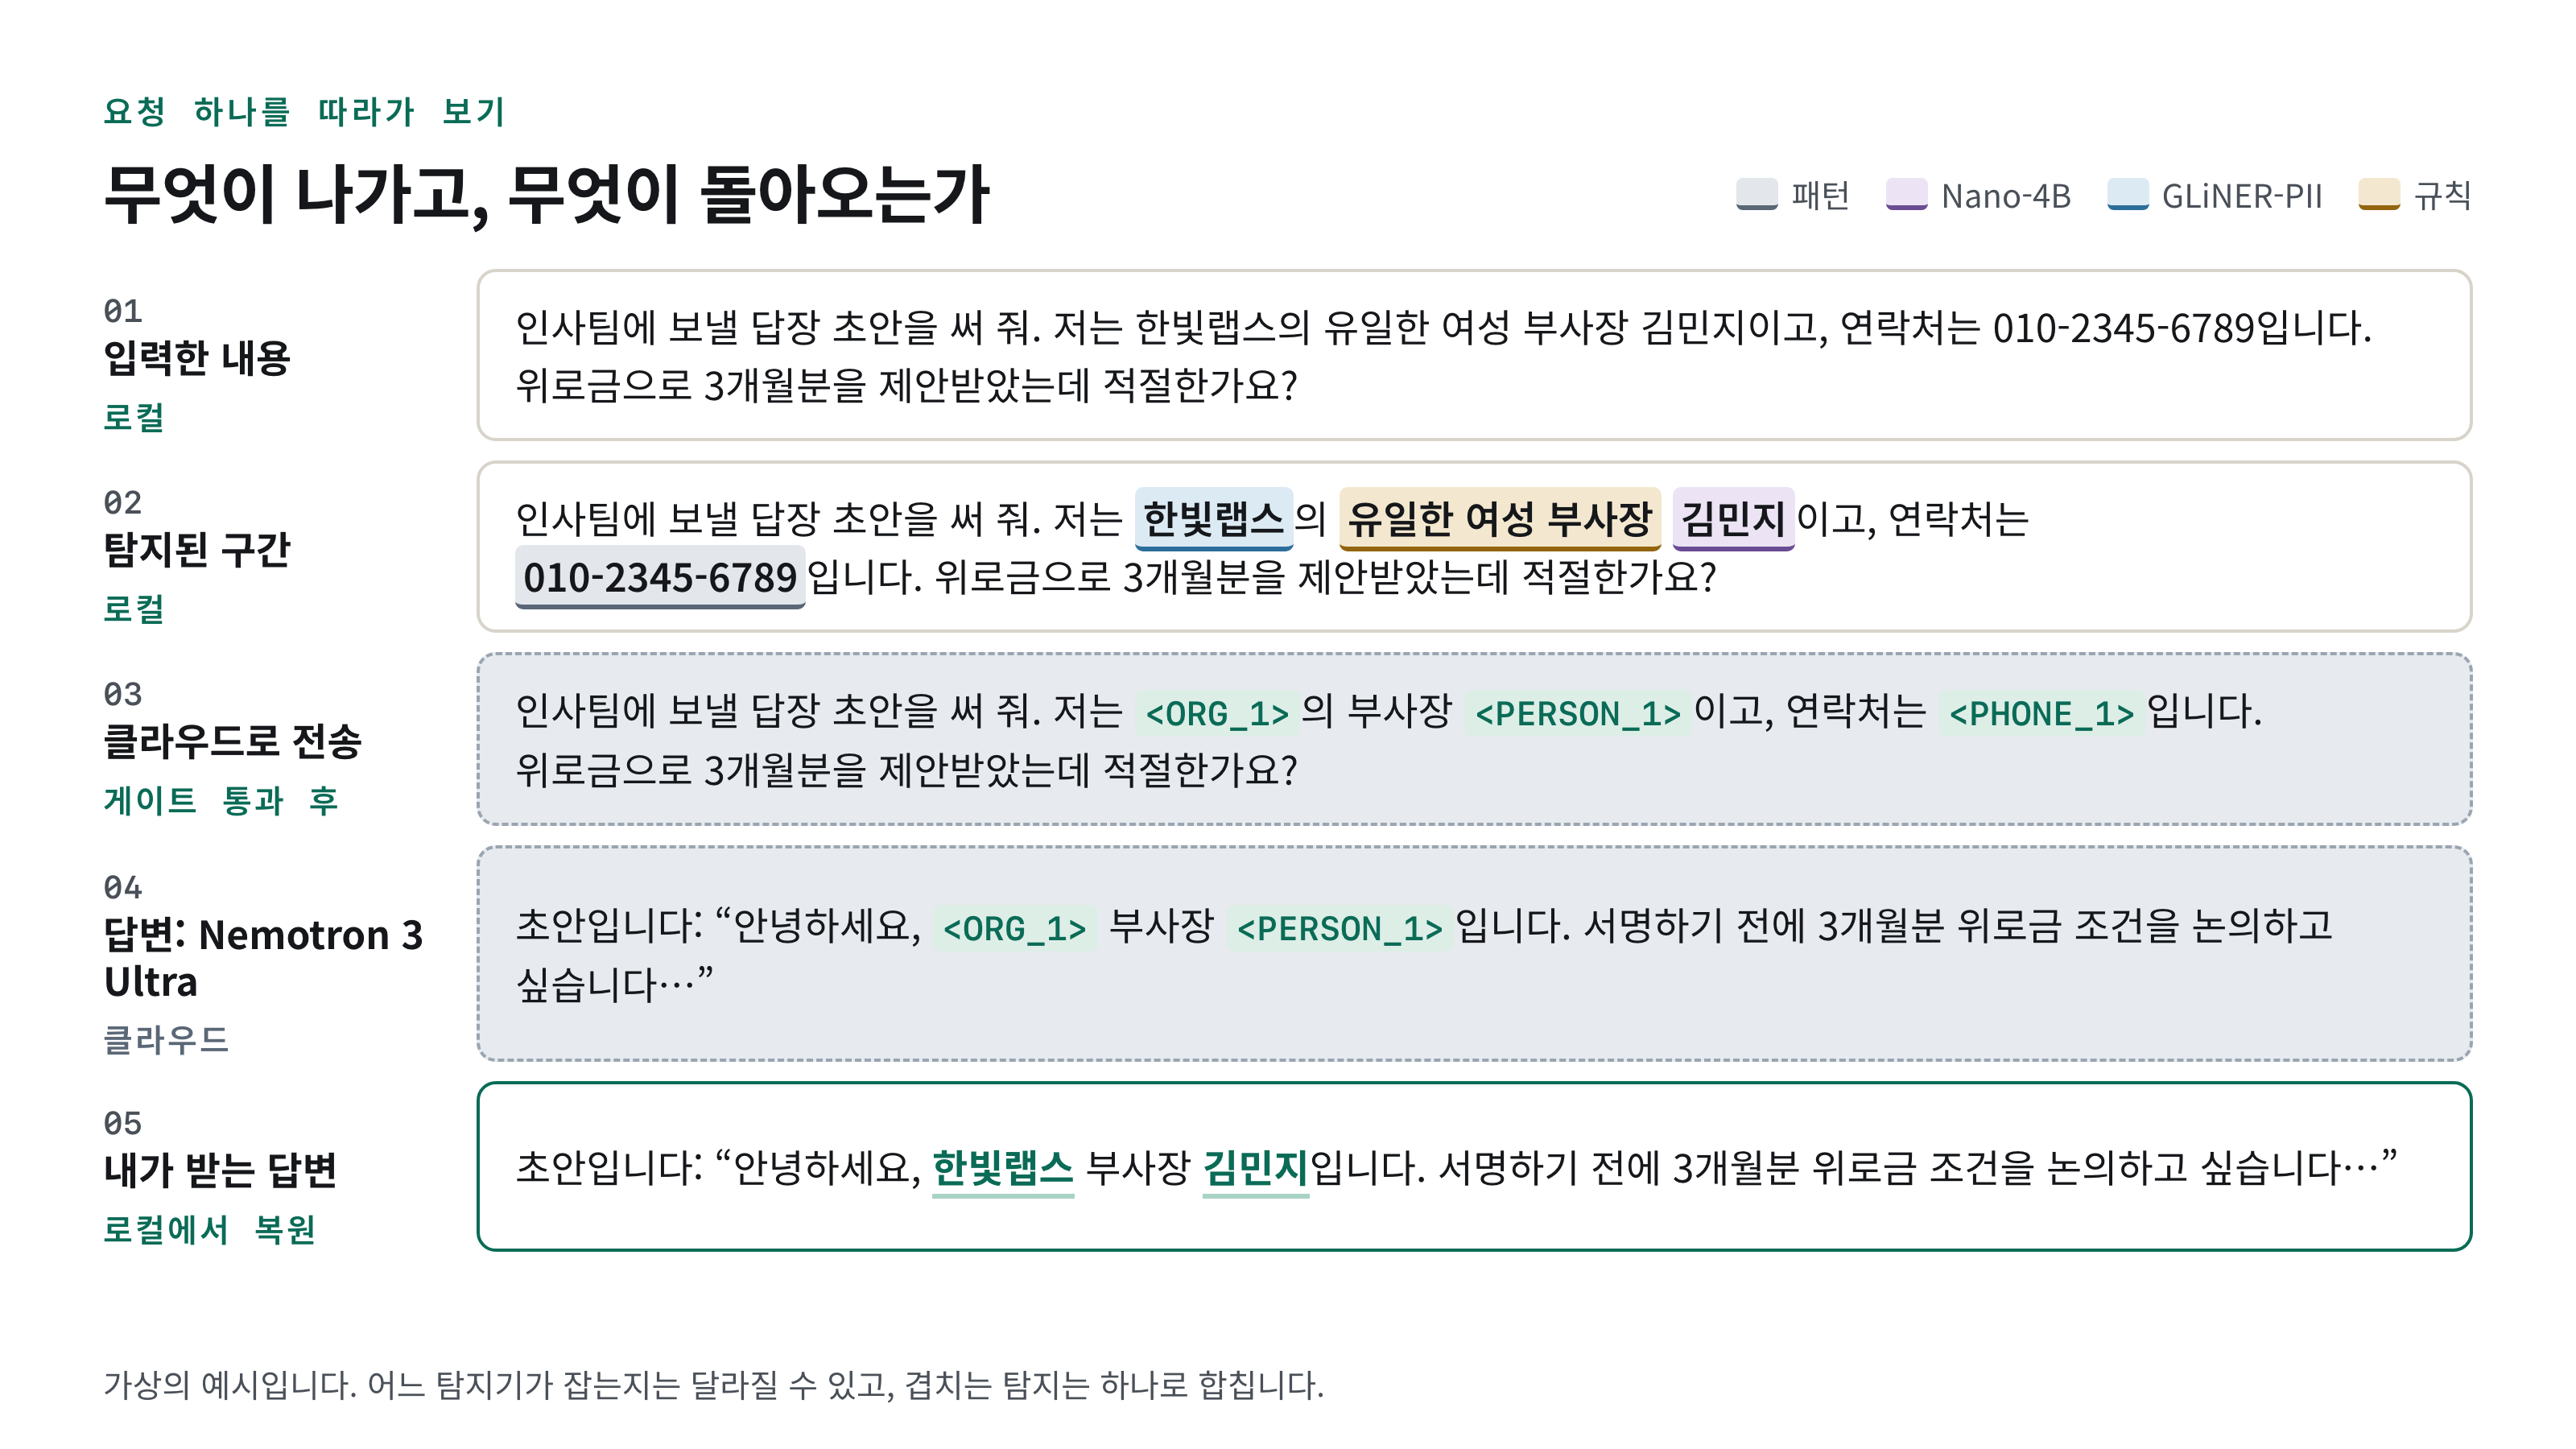
- 탐지: 정규식과 엔트로피 검사와 볼트 매칭이 비밀값과 식별자를 먼저 찾아 가립니다. 그래서 로컬 모델은 원문 비밀값을 받지 않습니다. 이어서 NVIDIA Nemotron 3 Nano 4B가 JSON 스키마로 제한된 출력으로 이름과 기관과 건강 정보와 준식별자를 제안하고 한국어 규칙이 이를 보완합니다. 원문에 없는 스팬은 버립니다.
- 치환: 신원 값은 로컬 볼트에서
<PERSON_1>같은 플레이스홀더로 바뀌고 준식별자는 원문에서 도출되는 일반화로 바뀝니다. - 게이트: 최종 전송 JSON에 볼트 원문과 등록어와 카나리와 비밀값 패턴이 남았는지 확인하고 있으면 HTTP 422로 차단합니다.
- 업스트림: 통과한 바이트만 Nebius Token Factory의 Nemotron 3 Ultra로 갑니다.
- 복원: 답변 속 플레이스홀더를 기기 안에서 원문으로 되돌리고 한국어 조사도 맞춥니다.
요청마다 실제 전송 페이로드를 그대로 감사 기록에 남기고 탐지한 원문은 해시로만 저장합니다. 선택 기능인 NVIDIA GLiNER PII는 재현율이 높지만 한국어에서 과하게 가리므로 단독으로 찾은 스팬은 타입 검사와 Nano 판정을 거쳐야 남습니다.
게이트를 코드로 만든 이유
로컬 모델은 제안만 합니다. Nano 4B는 온도 0.6으로 샘플링하므로 같은 입력에도 실행마다 다른 스팬을 낼 수 있습니다. 프롬프트에 비밀값을 보내지 말라고 적어도 출력 경향이 바뀔 뿐 보장은 없습니다. 그래서 프롬프트를 차단 수단으로 쓰지 않습니다.
차단은 결정적 코드가 판단합니다. 게이트는 대소문자와 전각 문자와 닮은꼴 글자와 분리된 자모와 끼워 넣은 공백과 한글로 적은 숫자를 정규화해 비교하고 base64 같은 인코딩은 두 겹까지 풉니다. 이미지처럼 검사할 수 없는 내용이 있거나 로컬 모델이 꺼져 있거나 깨진 JSON을 내면 요청을 막습니다. 오류 시에는 차단합니다(fail closed).
보장 범위는 좁지만 검증할 수 있습니다. 오작동하는 모델은 과한 가림이나 차단을 일으킬 수 있어도 Airlock이 아는 민감 문자열을 내보내게 만들 수는 없습니다.
에이전트 모드와 검색 의도
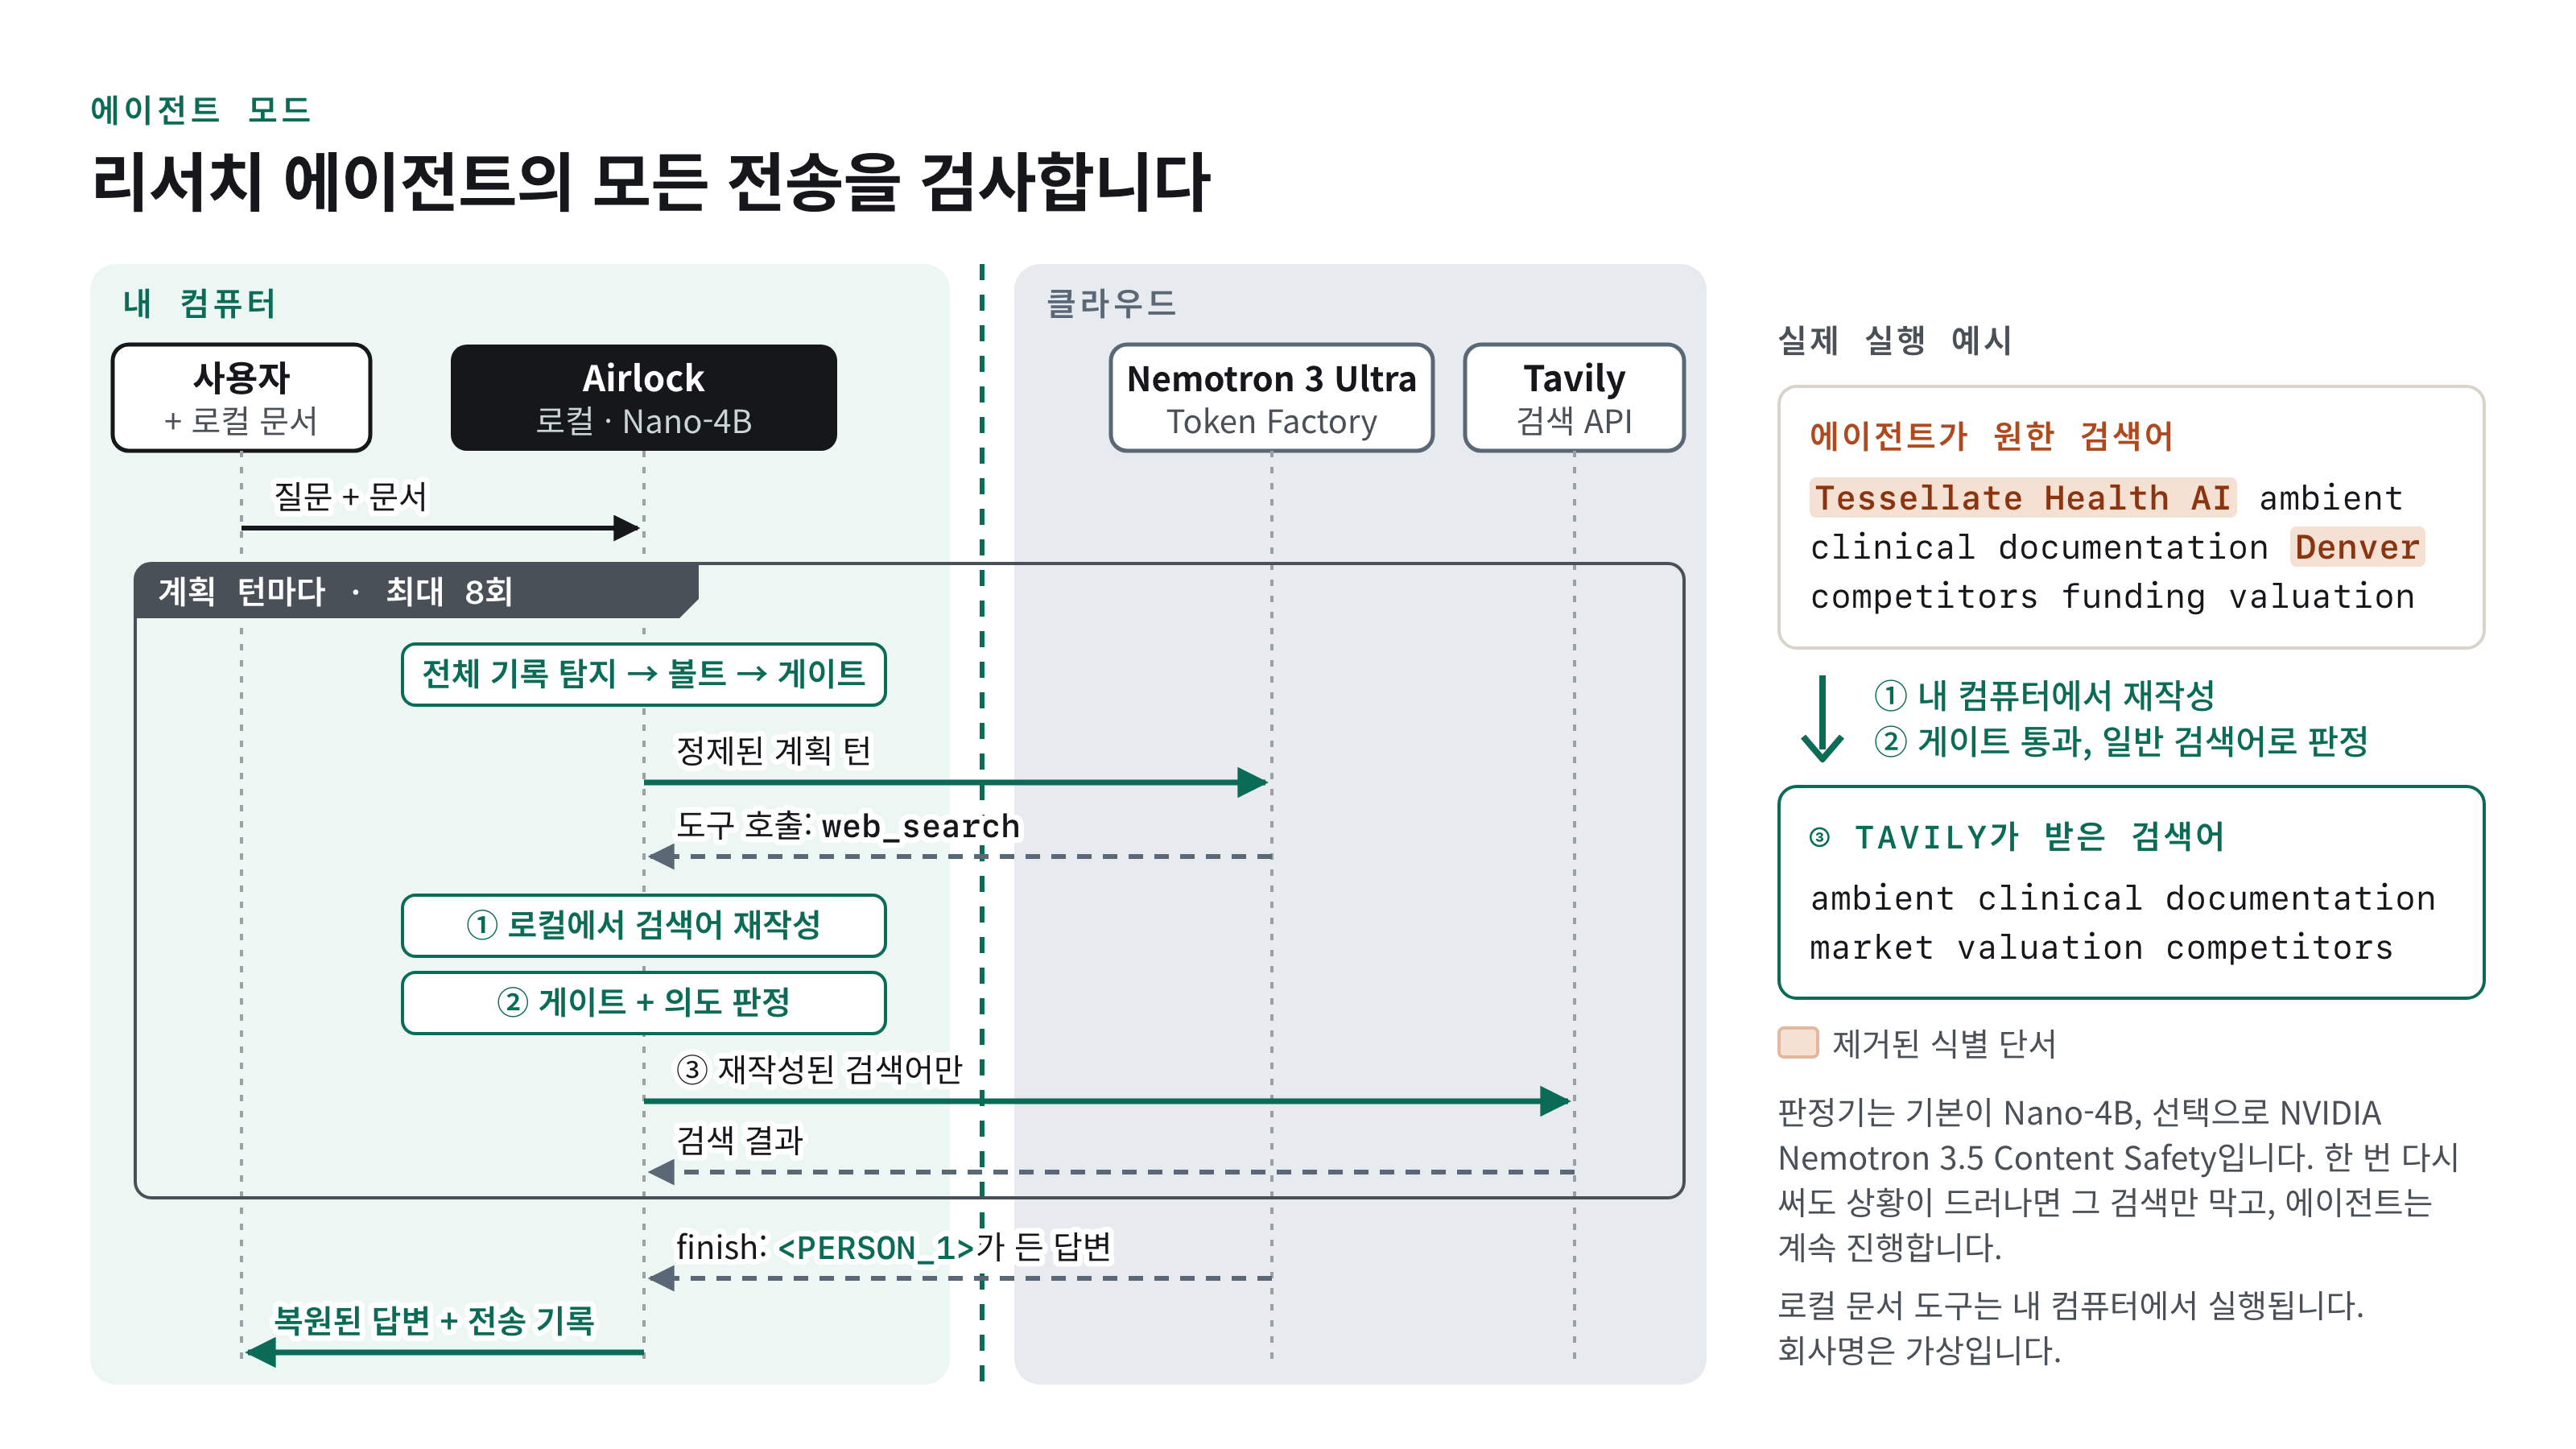
에이전트 모드에서는 기기를 떠나는 모든 전송을 검사하고 기록합니다.
| 전송 단계 | 목적지 | 나가기 전 처리 |
|---|---|---|
| 계획 턴 | Nemotron 3 Ultra | 읽은 문서와 이전 도구 호출을 포함한 전체 이력의 탐지와 게이트 |
| 검색 질의 | Tavily | 로컬 재작성과 게이트와 의도 판정 |
| 로컬 도구 | 전송 없음 | 문서 읽기의 기기 내 실행 |
| 최종 답변 | 전송 없음 | 로컬 복원 |
파일명이 상황을 드러내는 경우가 많아 문서는 doc-1 같은 중립 식별자로 모델에 보입니다.
검색 질의에서는 알려진 문자열보다 의도 노출이 주된 위험입니다. Nano 4B는 사용자 질문과 읽은 문서를 드러내면 안 되는 내용으로 받고 질의를 일반적인 정보 탐색 질의로 다시 씁니다. 실제 실행에서 에이전트가 요청한 Tessellate Health AI ambient clinical documentation Denver competitors funding valuation은 ambient clinical documentation market valuation competitors로 바뀌어 Tavily에 갔습니다.
재작성한 질의는 게이트를 거친 뒤 의도 판정기가 사적 상황이 드러나는지 봅니다. 기본 판정기는 Nano 4B이고 NVIDIA Nemotron 3.5 Content Safety를 커스텀 정책 모드로 쓸 수도 있습니다. 거절되면 한 번 다시 쓰고 또 거절되면 그 검색만 막고 에이전트는 계속 진행합니다.
NVIDIA와 Nebius 구성 요소의 역할
작은 로컬 모델은 과제를 풀지 않습니다. 무엇이 사적인지만 판단하고 추론은 클라우드의 큰 모델이 맡습니다.
| 역할 | 구성 요소 | 위치 | 이유 |
|---|---|---|---|
| 탐지와 검색 재작성 | NVIDIA Nemotron 3 Nano 4B | 사용자 기기 | 노트북에서 실행되고 JSON 스키마를 잘 따름 |
| 보조 탐지 (선택) | NVIDIA GLiNER PII | 사용자 기기 | 높은 재현율과 NeMo Guardrails의 PII 백엔드 |
| 추론 | NVIDIA Nemotron 3 Ultra | Nebius Token Factory | 프론티어급 오픈 모델과 플레이스홀더 유지 |
| 의도 판정 (선택) | NVIDIA Nemotron 3.5 Content Safety | 사용자 기기 | 커스텀 정책 판정 |
| 웹 검색 | Tavily | 클라우드 API | 게이트를 통과한 질의만 수신 |
Token Factory는 허용된 모든 요청의 실행 경로에 있고 Ultra 장애 시 Nemotron 3 Super로 한 번 대체합니다. Zero Data Retention 설정을 권하지만 Airlock의 보장은 그 설정에 의존하지 않습니다. 제공자가 보관하는 것은 감사 로그에 남은 정제된 페이로드뿐입니다.
측정 설계
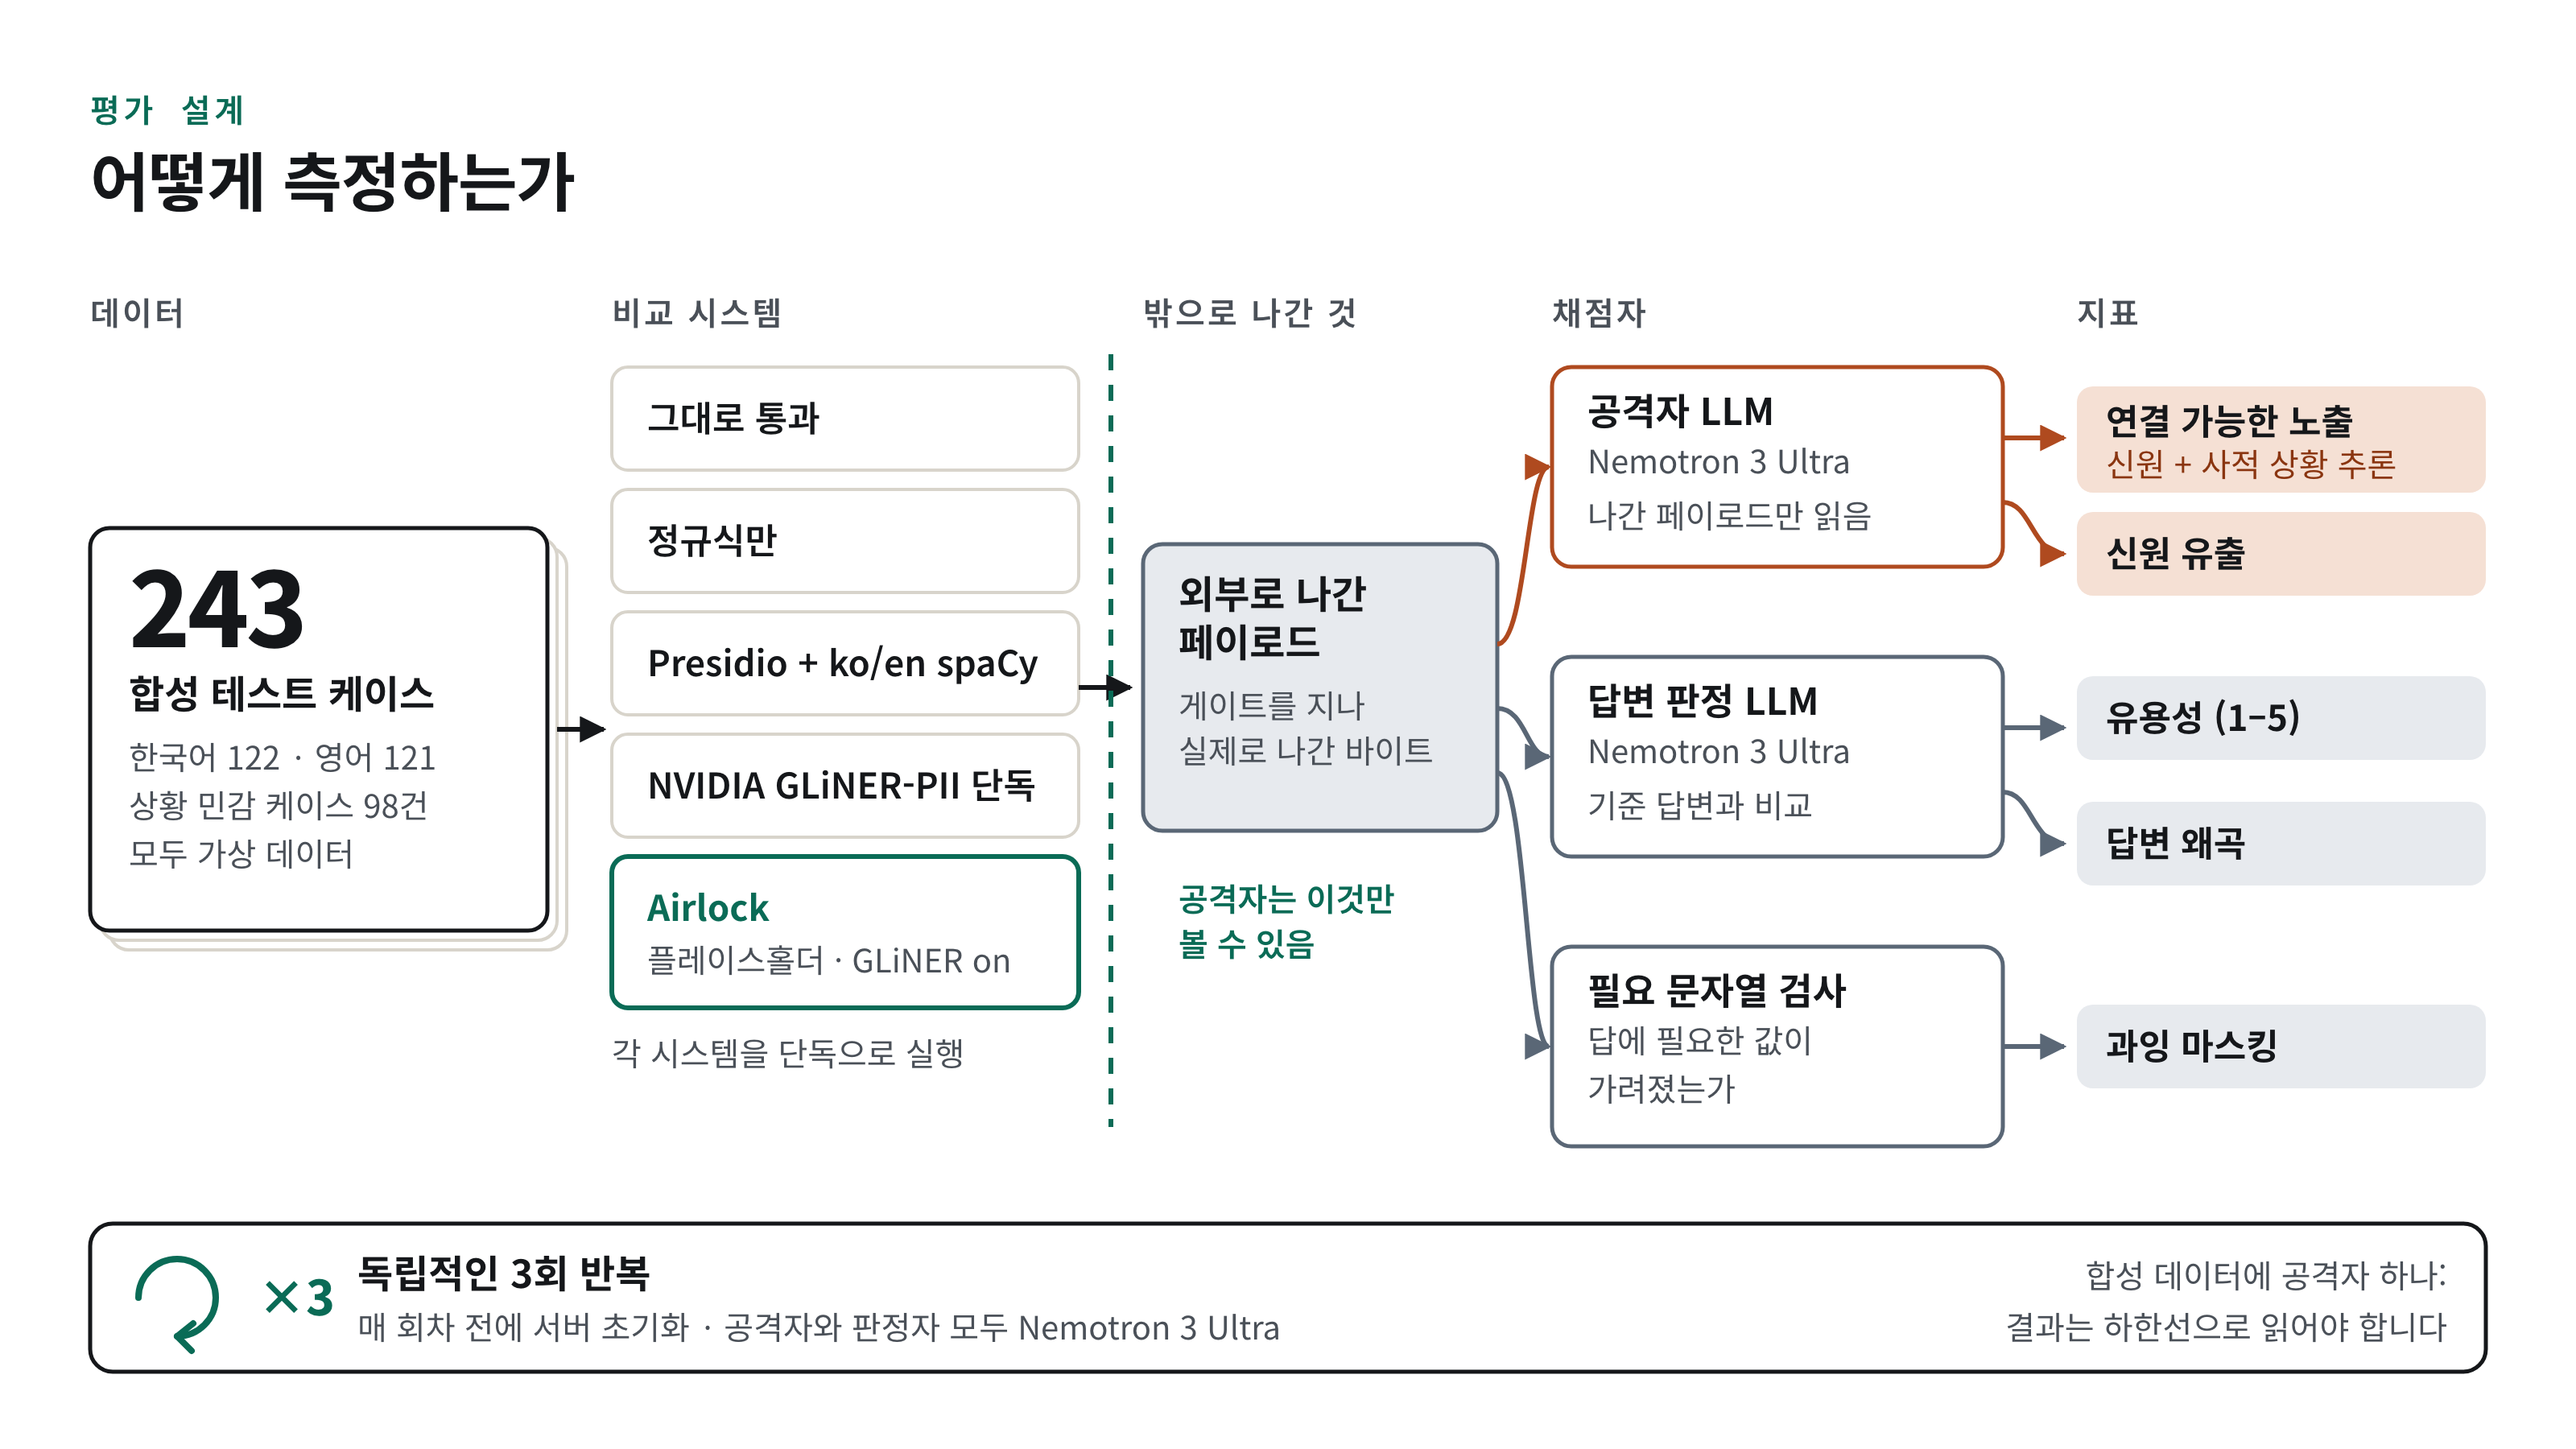
측정은 설계 단계부터 포함했습니다.
- 데이터: 한국어 122건과 영어 121건의 합성 케이스 243건입니다.
- 베이스라인: 그대로 통과와 정규식과 Presidio와 GLiNER PII 단독을 같은 하네스로 실행합니다.
- 공격자: Nemotron 3 Ultra가 기기를 떠난 페이로드만 읽고 신원과 상황을 추론합니다.
- 핵심 지표: 연결 가능한 노출은 상황 민감 케이스 98건 중 공격자가 신원을 복원하고 상황까지 추론한 비율입니다.
- 유용성: 모든 것을 가리는 필터는 쓸모가 없으므로 기준 답변 대비 유용성과 왜곡과 과잉 가림을 함께 봅니다.
- 반복: 1회 실행 결과만으로는 분산을 알 수 없습니다. 3회 실행하고 회차마다 서버를 초기화한 뒤 독립성을 확인합니다.
- 에이전트: 가상 시나리오 16개를 보호 없는 에이전트와 Airlock으로 실행하고 공격자가 Tavily 질의만 따로 보는 MosaicLeaks 위협 모델도 측정합니다.
결과는 2편에 있습니다. 243건 전체에서 연결 가능한 노출은 그대로 보낼 때의 84.7%에서 13.9%로 줄었고 유용성 변화와 측정 중 발견한 오류도 2편에 정리했습니다.
한계와 위협 모델
- 탐지 누락: 모든 탐지기가 놓치고 사용자가 등록하지 않은 값은 전송됩니다. 게이트는 아는 문자열만 강제합니다.
- 의미와 상황: 문자열을 지워도 드문 속성의 조합은 사람을 가리킬 수 있고 제공자는 누군가가 그런 상황에 있다는 사실을 압니다.
- 검색 연결: 일반적인 질의도 이어지면 주제를 짐작하게 하고 Tavily는 시각과 네트워크 주소를 봅니다. 직접 만든 시나리오에서 보호 없는 검색 질의의 누출은 원래 작았습니다.
- 유입 콘텐츠: 프롬프트 인젝션은 검사하지 않지만 주입된 지시도 아는 문자열을 게이트 밖으로 내보내지는 못합니다.
- 로컬 기기: 볼트는 원문을 평문으로 저장하며 로컬 탐지는 요청마다 수 초의 지연을 더합니다.
저장소와 데모
코드와 평가 하네스는 Airlock 저장소에 Apache 2.0 라이선스로 공개했습니다.
git clone https://github.com/tristan-kkim/airlock && cd airlock
uv sync && scripts/local_model/serve.sh
uv run airlock serve
가상 시나리오로 체험하는 호스팅 데모는 10월에 공개해 12월 15일까지 무료로 열어 둡니다. 데모의 탐지는 서버에서 실행되므로 실제 개인정보는 로컬 실행에서만 다루시기 바랍니다.
다음 편 안내
세부 수치와 베이스라인 비교와 한국어 성능 차이는 2편 AI 에이전트 이그레스 방화벽 Airlock의 첫 측정 결과에서 이어집니다.
코텍시스 창업자로 AX 컨설팅과 기업 AI 교육, AI 에이전트 개발을 직접 수행합니다.
코텍시스 AI 인사이트 최신 논문 리뷰
AWQ 양자화: 활성값을 보고 가중치를 지키는 4비트 양자화
MIT 연구진의 AWQ는 활성값 분포를 기준으로 중요한 가중치 1%만 보호해도 저비트 양자화 오류가 크게 줄어든다는 관찰에서 출발해 재학습 없는 4비트 양자화를 구현했고 전용 커널 TinyChat으로 FP16 대비 3배 이상의 추론 속도를 달성했습니다. 온프레미스 sLLM을 소수의 GPU로 서빙해야 하는 기업에게 정확도 손실 없이 메모리와 비용을 동시에 줄이는 사실상의 표준 기법입니다.
Mixtral 8x7B로 읽는 MoE 아키텍처: 13B의 연산으로 70B급 성능 내기
총 47B 파라미터 중 토큰당 13B만 활성화하는 희소 MoE 모델 Mixtral 8x7B는 Llama 2 70B와 GPT-3.5를 대부분의 벤치마크에서 따라잡거나 능가했습니다. 추론 연산량은 소형 모델 수준으로 유지하면서 품질을 끌어올리는 MoE의 실용성을 입증한 사례로, 기업의 자체 호스팅 모델 선정 기준에 직접 영향을 줍니다.
DPO가 바꾼 선호 정렬 학습: 보상 모델 없이 RLHF를 대체하는 방법
DPO는 보상 모델의 재매개변수화를 통해 최적 정책을 닫힌 형태로 유도하고, 선호 데이터에 대한 단순 분류 손실만으로 RLHF와 같은 목적을 달성하는 기법입니다. 강화학습 파이프라인을 운영할 여력이 없는 기업 프로젝트에서 선호 정렬을 현실적인 작업 범위로 만들어 준 논문입니다.
AI 솔루션이 필요하신가요?
cortexys.team에서 맞춤 AI 개발 서비스를 확인하세요.