Yellow.ai의 D-RAC는 문서를 PDF로 바꿔 멀티모달 LLM으로 한 번 변환하고 청크는 ID로만 묶어 청크 단계 비용을 77.8~85.6% 줄였습니다. 변환 비용과 충실도, 비PDF 형식은 측정되지 않아 도입 전 자체 검증이 필요합니다.
논문 개요와 문제 설정
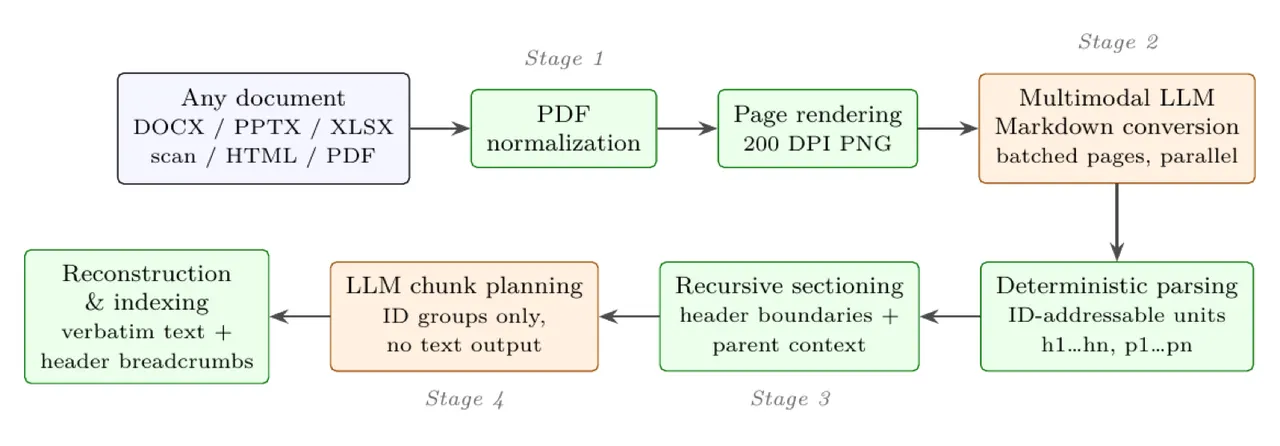
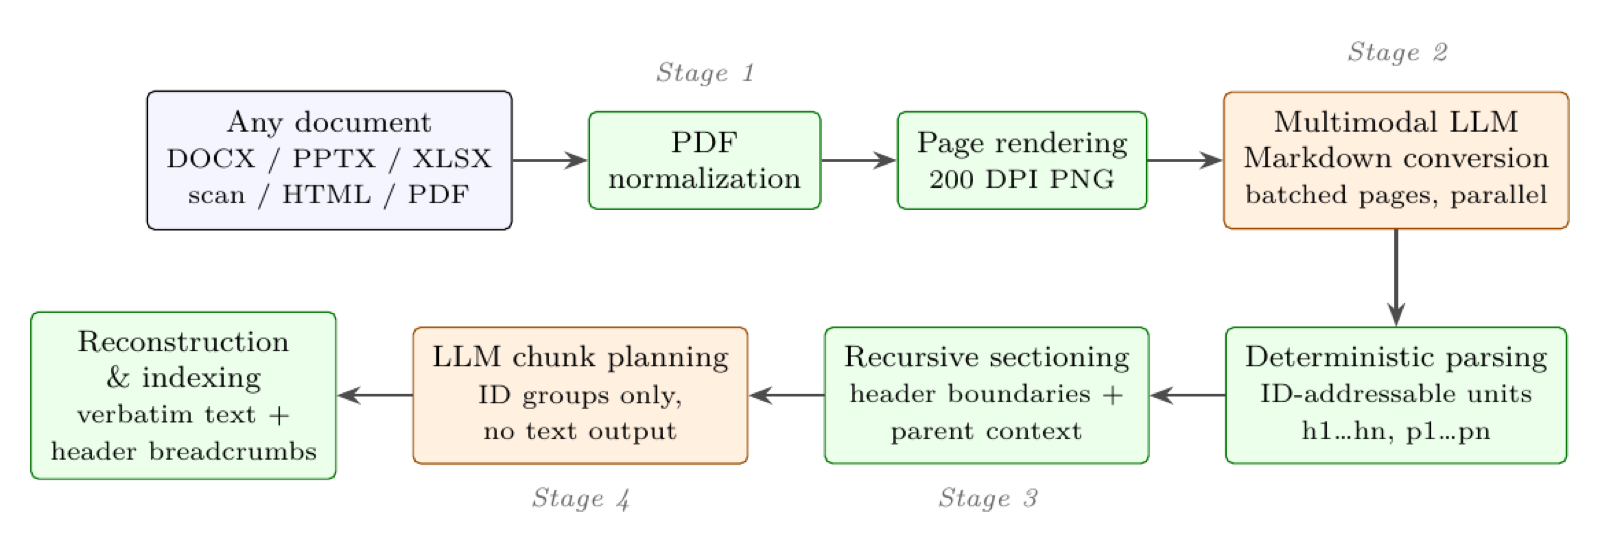
Yellow.ai가 2026년 9월 21일 Document Retrieval-Aware Chunking (D-RAC): Universal Retrieval-Aware Ingestion of Enterprise Documents via PDF Normalization and Multimodal Markdown Conversion을 공개했습니다. 사내 문서를 RAG(검색 증강 생성)에 넣는 수집 단계를 다룬 논문입니다. 워드, 파워포인트, 엑셀, 스캔 이미지를 모두 PDF로 바꾼 뒤 페이지 이미지를 멀티모달 LLM에 한 번만 읽혀 검색용 마크다운을 만들고, 청크 나누기는 텍스트를 다시 쓰지 않고 요소 ID만 묶는 방식입니다.
이 논문은 같은 팀이 앞서 낸 W-RAC(Web Retrieval-Aware Chunking)의 확장입니다. W-RAC는 웹 페이지를 결정적 방식으로 파싱해 ID가 붙은 단위로 나누고, LLM은 텍스트를 생성하는 대신 어떤 ID끼리 한 청크로 묶을지만 계획하게 했습니다. 저자들은 W-RAC가 청크 관련 출력 토큰을 84.6%, 전체 LLM 비용을 51.7% 줄였다고 소개합니다. 문제는 W-RAC가 HTML처럼 구조를 복원할 수 있는 입력을 전제한다는 점입니다.
기업 지식 저장소의 주류는 PDF입니다. 논문은 PDF를 의미 구조를 담지 않는 표현 형식으로 규정합니다. 텍스트를 추출하면 읽는 순서 대신 좌표 순서로 조각이 나오고, 다단 레이아웃은 뒤섞이며, 표는 공백으로 구분된 토큰 더미가 되고, 제목은 글꼴 정보로만 구분됩니다. 논문이 던지는 질문은 하나입니다. 렌더링된 페이지 이미지를 멀티모달 LLM이 한 번 읽는 것만으로 W-RAC를 그대로 적용할 수 있을 만큼 구조를 복원할 수 있는가입니다.
기존 수집 방식의 한계
논문은 기존 방식을 네 갈래로 정리합니다.
| 방식 | 대표 도구 | 논문이 지적한 한계 |
|---|---|---|
| 규칙 기반 추출 | PyMuPDF, pdfminer, pdfplumber | 다단 레이아웃의 읽기 순서 붕괴, 머리글·바닥글 혼입, 표가 위치가 모호한 조각으로 분해됨 |
| 레이아웃 분석·OCR | LayoutLM, LayoutLMv2, Docling | 별도 모델 배포 필요, 보험 안내서 같은 마케팅형 문서에 약함, 표를 여전히 격자로 출력 |
| 에이전틱 청킹 | 추출 텍스트 위에 LLM 적용 | 추출 손상 복구와 전문 재작성을 동시에 수행해 출력 토큰·지연·환각 위험이 최대 |
| 비전 기반 청킹 | 페이지 이미지를 읽는 대형 비전 모델 | 이해와 청크 생성을 모두 맡겨 에이전틱 청킹의 출력 비용이 그대로 남음 |
비용 측면의 핵심은 출력 토큰입니다. 저자들은 선행 연구에서 출력 토큰이 표준 가격 기준 입력 토큰보다 약 4배 비싸 비용을 좌우한다고 분석했습니다. 에이전틱 청킹은 문서 전체를 다시 써서 출력하므로 이 비싼 항목을 최대로 소비합니다. D-RAC의 설계는 멀티모달 모델을 형식 변환에 정확히 한 번 쓰고, 이후 청크 계획은 ID 수준에서 처리해 텍스트 생성 비용을 한 번만 내는 것입니다.
D-RAC 파이프라인 4단계
1단계 PDF 정규화와 페이지 렌더링
PDF 이외의 입력은 표준 도구로 PDF로 바꿉니다. 오피스 문서는 헤드리스 LibreOffice, HTML은 PDF 인쇄, 스캔은 이미지를 PDF로 감싸는 방식입니다. 이 단계에는 LLM이 없습니다. 이어서 각 페이지를 200 DPI PNG로 렌더링하고, 가로나 세로가 1,568픽셀을 넘으면 줄입니다. 일반적인 비전 인코더 입력 한도에 맞추면서 작은 글씨와 표 내용을 읽을 수 있게 한 설정입니다. 렌더링은 문서당 1~7초가 걸렸습니다.
2단계 멀티모달 마크다운 변환
페이지를 5장씩 묶어 멀티모달 LLM에 보내고, 최대 5개 묶음을 병렬로 처리합니다. 평가에 쓴 모델은 AWS Bedrock의 Gemma-3 27B와 Gemma-3 12B입니다. 변환 프롬프트는 부록에 전문이 실려 있으며 규칙은 다음과 같습니다.
| 규칙 | 내용 |
|---|---|
| 원문 보존 | 모든 텍스트를 요약하거나 생략하지 않고 옮김 |
| 표의 문장화 | 마크다운 표 문법 금지, 표의 각 행을 열 제목을 포함한 한 문장으로 작성 |
| 병합 금지 | 서로 다른 행을 "또는"으로 합친 문장 금지 |
| 이미지 제외 | 로고·차트·아이콘을 설명하지 않고 완전히 생략 |
| 계층 보존 | 제목 수준을 #, ##, ###으로 출력 |
| 페이지 표시 | 각 페이지 앞에 페이지 번호 주석 삽입 |
변환 뒤에는 결정적 후처리가 코드 펜스와 남은 이미지 참조를 지우고, 프롬프트를 빠져나온 표 문법은 규칙 기반으로 행 단위 문장으로 바꿉니다. 한 묶음이 실패하면 문서 전체를 중단하지 않고 해당 페이지 범위에 오류 표시를 남깁니다.
3단계 결정적 파싱과 섹션 분할
변환된 마크다운을 W-RAC와 똑같이 제목(h1, h2 등)과 본문 블록(p1, p2 등)으로 나누고 각각 ID를 붙입니다. 요소가 LLM 호출 한 번의 예산인 60개를 넘으면 제목 경계에서 재귀적으로 자릅니다. 가장 상위 제목 수준부터 시도하고 필요할 때만 하위 수준으로 내려가며, 제목이 없는 구간은 고정 크기로 자릅니다. 각 섹션에는 상위 제목의 연결 정보를 붙여, 본문을 다시 보내지 않고 수십 개 입력 토큰만으로 문서 안의 위치를 알려 줍니다.
4단계 ID 기반 청크 계획과 재구성
계획 LLM은 요소 ID, 잘린 미리보기 텍스트, 계층 정보만 받고 ID 배열의 목록을 돌려줍니다. 지침은 청크 하나에 본문 블록 3~8개를 한 주제로 묶고, 모든 본문 ID를 정확히 한 번씩 포함하라는 것입니다. 빠진 ID는 프로그램이 검사해 섹션 제목과 함께 예비 청크로 모읍니다. 최종 청크는 ID를 변환된 원문 텍스트에 다시 연결해 로컬에서 조립하고, 앞에 상위 제목 전체와 "Plan Overview > Eligibility > Age Limits" 같은 경로 표시를 붙여 임베딩합니다.
표를 행 단위 문장으로 바꾸는 이유
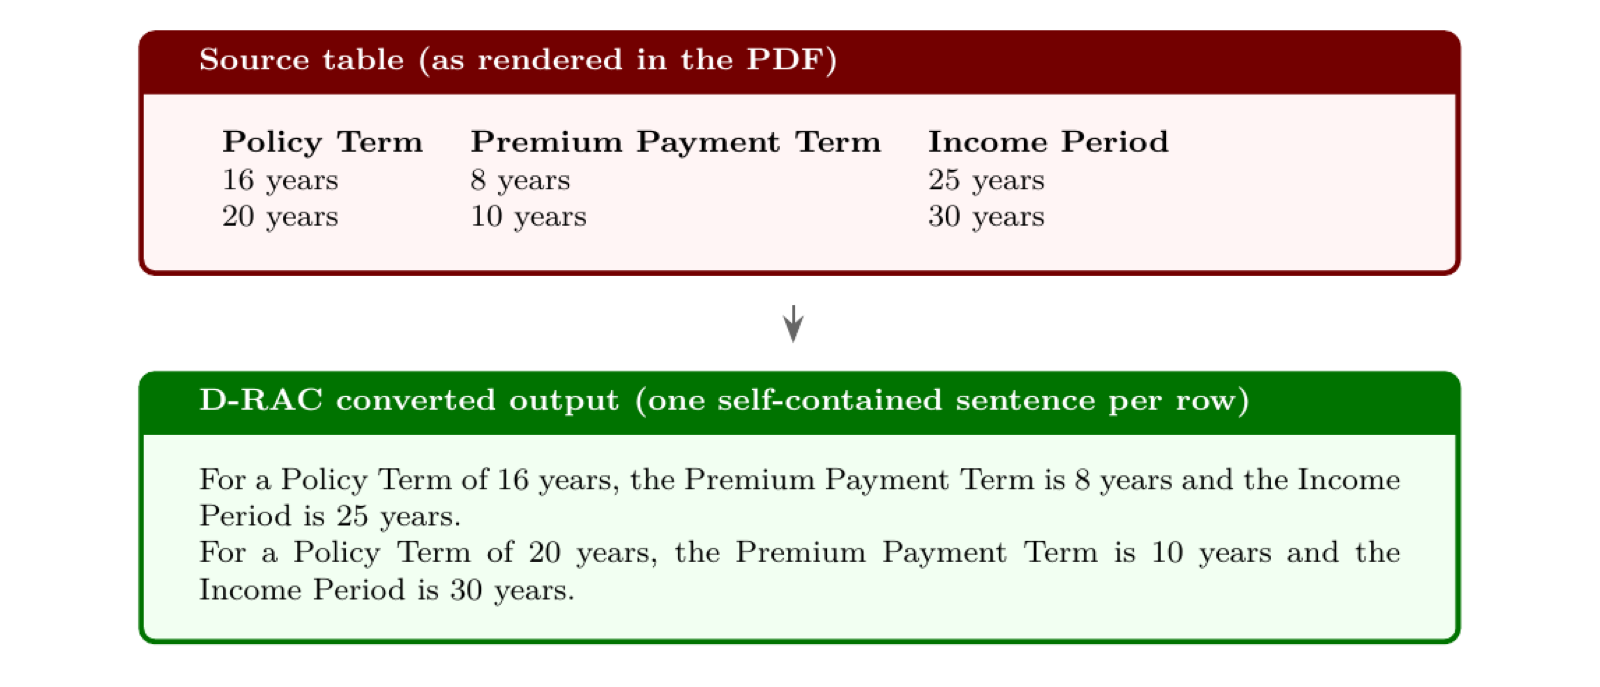
밀집 벡터 검색에서 표 셀은 제대로 검색되지 않습니다. 셀 값의 의미는 행 제목과 열 제목에 달려 있는데, 이 제목들이 다른 청크나 먼 토큰 위치에 떨어지기 때문입니다. D-RAC는 변환 시점에 각 행을 "보험 기간이 16년이면 납입 기간은 8년이고 연금 수령 기간은 25년이다"(논문 예시를 옮긴 것)와 같은 선언문으로 바꿔 표의 사실 하나하나가 독립적으로 검색되게 합니다.
병합 금지 규칙은 정밀도를 지키는 장치입니다. 두 행을 "16년 또는 20년"처럼 합치면 한 가지 조건을 묻는 질의에 여러 조건을 섞은 문장이 검색되고, 답변 모델이 잘못된 근거를 인용할 수 있습니다. 논문은 이를 조용히 정밀도를 떨어뜨리는 요인으로 설명합니다. 변환된 마크다운과 요소 ID는 저장해 두므로, 청크 크기나 테넌트별 정책을 바꿀 때는 원본 PDF를 다시 변환하지 않고 몇 초 걸리는 ID 계획만 다시 실행하면 됩니다.
평가 코퍼스와 측정 방법
평가는 저자들이 W-RAC와 함께 공개한 합성 데이터셋 RAG-Multi-Corpus의 PDF 부분집합으로 했습니다. 다섯 개 가상 기업의 제품 안내서, FAQ, 정책·절차 문서, 부품 카탈로그, 서비스 가이드로 구성됩니다.
| 가상 기업 | 분야 | PDF 수 | 페이지 수 |
|---|---|---|---|
| Aventro Motors | 자동차 | 50 | 133 |
| Cendara University | 교육 | 40 | 221 |
| CloudWay-24 | 클라우드 서비스 | 37 | 103 |
| Velvera Technologies | 기업 기술 | 38 | 123 |
| ZX Bank | 은행·금융 | 71 | 215 |
| 합계 | 236 | 795 |
입력이 모두 원래 PDF였으므로 이 실험에서 1단계 정규화는 아무 변환도 하지 않았습니다. 규모 확장 검증에는 별도의 503페이지 금융 투자설명서를 썼습니다. 모든 실험은 AWS Bedrock에서 temperature 0.1로 실행했습니다.
검색 평가는 762개 질의로 했습니다. CloudWay-24에는 주석이 달린 질의가 없어 네 개 기업만 포함됩니다. 질의는 절차(175개), 비교(134개), 서술(133개), 분석(118개), 예·아니오(106개), 개방형(72개), 시간(24개)의 일곱 유형입니다. 비교 대상은 세 가지입니다. PyMuPDF 추출 텍스트를 1,000자 단위로 200자씩 겹쳐 자른 고정 크기 방식, 벤치마크에 함께 배포된 에이전틱 청킹 결과, 그리고 D-RAC입니다. 세 방식 모두 Titan Text Embeddings V2(1,024차원)로 임베딩하고 기업별 색인에서 코사인 유사도 상위 K개를 검색했습니다. 검색된 청크가 정답 근거 문장의 내용어 60% 이상을 포함하면 관련 있다고 판정했습니다.
측정 결과
변환 처리량과 오류
Gemma-3 27B로 236개 문서 795페이지를 변환하는 데 누적 3,758초(62.6분)가 걸렸고, 청크 계획을 포함한 실제 경과 시간은 71.7분이었습니다. 변환 오류는 0건이었습니다. 페이지당 변환 시간은 기업별로 3.9~5.5초 범위였고, 저자들은 짧은 문서에서는 내용 복잡도보다 API 호출 지연이 시간을 좌우한다고 해석했습니다. 503페이지 투자설명서는 27B 모델로 21.6분, 12B 모델로 13.4분에 변환되었고 페이지당 시간은 작은 문서와 비슷했습니다.
청크 계획은 전체 코퍼스에 542초가 걸려 변환 시간의 14% 수준이었습니다. 5,584개 요소에서 1,748개 청크가 나왔고 평균 길이는 705자였습니다. 모든 본문 요소가 정확히 한 청크에 들어갔고 청크 오류는 0건이었습니다. 503페이지 문서의 5,060개 요소는 95번의 병렬 섹션 호출로 68.7초 만에 계획되었습니다.
검색 품질
| 지표 | 고정 크기(규칙 기반 추출) | 에이전틱 청킹 | D-RAC |
|---|---|---|---|
| Recall@6 | 0.717 | 0.795 | 0.798 |
| Recall@3 | 0.666 | 0.726 | 0.743 |
| Precision@6 | 0.203 | 0.197 | 0.199 |
| Precision@3 | 0.316 | 0.316 | 0.321 |
| MRR | 0.602 | 0.682 | 0.690 |
| NDCG@6 | 0.764 | 0.793 | 0.801 |
| NDCG@3 | 0.677 | 0.716 | 0.726 |
고정 크기 방식 대비 D-RAC의 Recall@6은 0.717에서 0.798로, MRR은 0.602에서 0.690으로 올랐습니다. 저자들은 기존 PDF 수집의 병목이 추출 과정의 구조 파괴에 있다는 근거로 이 결과를 제시합니다. 에이전틱 청킹과의 차이는 모든 지표에서 0.02 이내입니다. 유형별로는 시간 질의의 Recall@6이 고정 크기 0.73에서 D-RAC 0.85로 가장 크게 올랐고, 비교 질의는 0.72에서 0.79, 분석 질의는 0.56에서 0.61이었습니다. 예·아니오 질의는 에이전틱 청킹이 0.86으로 D-RAC 0.82보다 높았습니다. 네 기업 사이 D-RAC의 Recall@6 편차는 0.022였습니다.
청크 단계 토큰과 비용
비용 비교의 대상은 청크 단계입니다. 에이전틱 청킹의 입력은 변환된 문서 전체와 지시문, 출력은 모델이 새로 써야 하는 청크 텍스트 전체로 계산했습니다. D-RAC는 실제로 보낸 계획 프롬프트와 받은 ID 배열을 재구성해 셌습니다. 토큰 수는 4자당 1토큰으로 환산했습니다. 출력 토큰은 270,454개에서 11,714개로 95.7% 줄었고, 입력 토큰은 미리보기를 200~400자로 자른 덕분에 325,855개에서 264,954개로 약간 줄었습니다.
| 모델 | 방식 | 입력 비용 | 출력 비용 | 합계 | 절감률 |
|---|---|---|---|---|---|
| GPT-4.1 | 에이전틱 청킹 | $0.652 | $2.164 | $2.815 | 기준 |
| GPT-4.1 | D-RAC | $0.530 | $0.094 | $0.624 | 77.8% |
| Gemini 2.5 Pro | 에이전틱 청킹 | $0.407 | $2.705 | $3.112 | 기준 |
| Gemini 2.5 Pro | D-RAC | $0.331 | $0.117 | $0.448 | 85.6% |
가격은 100만 토큰당 입력·출력 기준 GPT-4.1 2달러·8달러, Gemini 2.5 Pro 1.25달러·10달러를 적용했습니다. 출력 단가가 입력의 몇 배인지에 따라 절감률이 달라지며, 출력이 비싼 모델일수록 D-RAC의 이점이 커집니다. 저자들은 이를 100만 페이지 코퍼스로 외삽해 재색인 1회당 청크 비용이 GPT-4.1 기준 약 3,540달러에서 약 785달러로 준다고 추정했습니다. 청크 시간은 W-RAC 실험에서 같은 236개 파일에 측정한 에이전틱 청킹 2,167.5초와 이번 D-RAC 계획 541.8초를 비교해 75.0% 감소로 제시했습니다.
수치를 읽을 때 주의할 점
비용 비교에 변환 단계가 빠져 있음
77.8~85.6% 절감은 청크 단계만의 비교입니다. D-RAC의 2단계인 Gemma-3 멀티모달 변환은 전체 경과 시간 71.7분 가운데 62.6분을 차지하지만, 논문은 이 단계의 비용을 계산하지 않았습니다. 따라서 규칙 기반 추출 파이프라인과 D-RAC 전체의 비용 비교는 논문에 없습니다. 또한 에이전틱 청킹의 비용은 벤치마크 산출물에서 토큰 수를 계산해 공개 가격을 곱한 값이고, 75% 시간 단축도 다른 논문의 실험 기록과 비교한 수치입니다. 확실하게 말할 수 있는 이점은 재청크 비용입니다. 변환을 한 번 해 두면 검색 전략을 바꿀 때마다 드는 비용은 ID 계획뿐입니다.
오류 0건이 뜻하는 것
795페이지 오류 0건은 변환 묶음과 청크 계획이 실패 없이 끝났다는 뜻입니다. 변환된 마크다운이 원문과 일치하는지 측정한 지표(문자 오류율, 원문 충실도 평가 등)는 논문에 없습니다. 논문이 말하는 "환각 여지 없음"은 ID만 출력하는 4단계에 해당합니다. 2단계에서 모델이 숫자를 잘못 읽거나 표 행을 문장으로 바꾸다 값을 섞으면 그 오류는 이후 단계에서 검증 없이 그대로 색인됩니다. 이미지 제외 규칙도 같은 맥락입니다. 차트와 도식에만 있는 정보는 색인에서 빠집니다.
측정되지 않은 비PDF 형식
평가 입력은 전부 원래 PDF였고 1단계는 실제로 아무 일도 하지 않았습니다. DOCX, PPTX, XLSX, 스캔 문서를 넣었을 때의 결과는 논문에 없습니다. RAG-Multi-Corpus 저장소에는 같은 기업 문서의 DOCX·PPTX판도 들어 있지만 이번 평가에는 쓰이지 않았습니다. 스캔본의 기울어짐이나 저해상도, 엑셀의 넓은 시트가 페이지로 잘리는 문제는 검증되지 않은 영역입니다.
평가 설계의 범위
벤치마크는 저자들이 만든 것이고 문서는 가상 기업의 것입니다. 관련성 판정은 내용어 60% 겹침이라는 어휘 기준이며 사람의 판단이나 최종 답변 정확도는 측정하지 않았습니다. 에이전틱 청킹 결과는 원문 구조가 깔끔한 원본에서 만들어진 참조 청크이며, 저자들은 D-RAC가 더 어려운 입력에서 같은 수준에 도달했다고 해석합니다. 반대로 보면 에이전틱 청킹을 같은 PDF 입력 조건에서 다시 실행한 비교는 아닙니다. 검색 지표 차이 0.02 이내는 이 조건에서 동등하다는 정도로 읽는 것이 적절합니다.
문서를 외부 모델에 보내는 보안 문제
D-RAC는 모든 페이지를 이미지로 멀티모달 LLM에 보냅니다. 논문은 AWS Bedrock을 썼습니다. 인사, 계약, 고객 정보가 담긴 문서라면 페이지 이미지 전체가 외부 추론 서비스로 나가는 구조입니다. 필자의 해석으로는 Gemma-3가 공개 가중치 모델이므로 사내 GPU에 직접 올려 문서가 외부로 나가지 않게 구성할 여지가 있습니다. 다만 논문은 자체 호스팅 환경의 처리 속도를 측정하지 않았습니다.
우리나라 사내 문서 환경에 적용할 때
아래는 논문에 없는 필자의 해석입니다. 우리나라 기업의 문서 저장소에는 HWP·HWPX 파일이 많습니다. D-RAC의 구조에서는 형식별 파서를 만들지 않고 PDF로 내보내는 경로 하나만 확보하면 되므로, 한컴오피스 등 HWP를 정확히 렌더링하는 도구로 PDF를 만드는 단계를 1단계에 넣는 방식이 가능합니다. 이 경로의 렌더링 품질과 대량 변환 속도는 조직이 직접 확인해야 합니다.
한국어 문서의 변환 품질도 별도 검증 대상입니다. 논문이 제시한 예시와 프롬프트는 모두 영어이고, 한자 병기나 세로 병합 셀이 많은 한국어 공문서 표를 Gemma-3가 행 단위 문장으로 정확히 바꾸는지는 알려져 있지 않습니다. 표를 문장으로 바꾸는 규칙 자체는 제품 조건표, 요율표, 수수료표처럼 행마다 조건이 다른 문서가 많은 금융·보험·제조 분야에서 특히 의미가 있습니다.
우리나라 기업이 확인할 것
- 비용 비교의 범위는 전체 파이프라인이어야 합니다. 논문의 77.8~85.6%는 청크 단계만의 절감이므로, 멀티모달 변환에 드는 페이지당 비용과 시간을 자체 문서로 측정해 기존 추출 파이프라인과 합계로 비교해야 합니다.
- 변환 충실도는 샘플 검수로 확인해야 합니다. 표와 숫자가 많은 문서 수십 건을 골라 변환된 마크다운의 수치를 원문과 대조하는 단계가 필요합니다. 논문은 이 항목을 측정하지 않았습니다.
- HWP, 스캔본, 엑셀처럼 논문이 시험하지 않은 형식은 PDF 변환 품질을 먼저 점검해야 합니다. 1단계가 실패하면 이후 단계는 결함 있는 이미지를 그대로 읽습니다.
- 변환 모델의 위치는 문서 등급별로 정해야 합니다. 외부 API로 보낼 수 있는 문서와 사내 호스팅 모델로만 처리할 문서를 나누고, 우리나라 개인정보보호법상 처리 위탁 여부를 함께 검토해야 합니다.
- 검색 전략을 자주 바꿀 계획이라면 변환 결과를 보존하는 구조가 유리합니다. 변환된 마크다운과 요소 ID를 저장해 두면 청크 정책 변경 비용이 ID 계획 비용으로 줄어드는 것이 이 설계의 가장 확실한 이점입니다.
출처: Document Retrieval-Aware Chunking (D-RAC): Universal Retrieval-Aware Ingestion of Enterprise Documents via PDF Normalization and Multimodal Markdown Conversion, Web Retrieval-Aware Chunking (W-RAC) for Efficient and Cost-Effective Retrieval-Augmented Generation Systems, RAG-Multi-Corpus
코텍시스 창업자로 AX 컨설팅과 기업 AI 교육, AI 에이전트 개발을 직접 수행합니다.
코텍시스 AI 인사이트 최신 논문 리뷰
AWQ 양자화: 활성값을 보고 가중치를 지키는 4비트 양자화
MIT 연구진의 AWQ는 활성값 분포를 기준으로 중요한 가중치 1%만 보호해도 저비트 양자화 오류가 크게 줄어든다는 관찰에서 출발해 재학습 없는 4비트 양자화를 구현했고 전용 커널 TinyChat으로 FP16 대비 3배 이상의 추론 속도를 달성했습니다. 온프레미스 sLLM을 소수의 GPU로 서빙해야 하는 기업에게 정확도 손실 없이 메모리와 비용을 동시에 줄이는 사실상의 표준 기법입니다.
Mixtral 8x7B로 읽는 MoE 아키텍처: 13B의 연산으로 70B급 성능 내기
총 47B 파라미터 중 토큰당 13B만 활성화하는 희소 MoE 모델 Mixtral 8x7B는 Llama 2 70B와 GPT-3.5를 대부분의 벤치마크에서 따라잡거나 능가했습니다. 추론 연산량은 소형 모델 수준으로 유지하면서 품질을 끌어올리는 MoE의 실용성을 입증한 사례로, 기업의 자체 호스팅 모델 선정 기준에 직접 영향을 줍니다.
DPO가 바꾼 선호 정렬 학습: 보상 모델 없이 RLHF를 대체하는 방법
DPO는 보상 모델의 재매개변수화를 통해 최적 정책을 닫힌 형태로 유도하고, 선호 데이터에 대한 단순 분류 손실만으로 RLHF와 같은 목적을 달성하는 기법입니다. 강화학습 파이프라인을 운영할 여력이 없는 기업 프로젝트에서 선호 정렬을 현실적인 작업 범위로 만들어 준 논문입니다.
AI 솔루션이 필요하신가요?
cortexys.team에서 맞춤 AI 개발 서비스를 확인하세요.