Airlock의 연결 가능한 노출이 13.9%에서 7.5%로 내려간 과정을 정리했습니다. GLiNER 앙상블과 준식별자 조합 일반화와 정규화 텍스트 탐지를 어떤 변형끼리 비교해 골랐는지 표로 담았습니다.
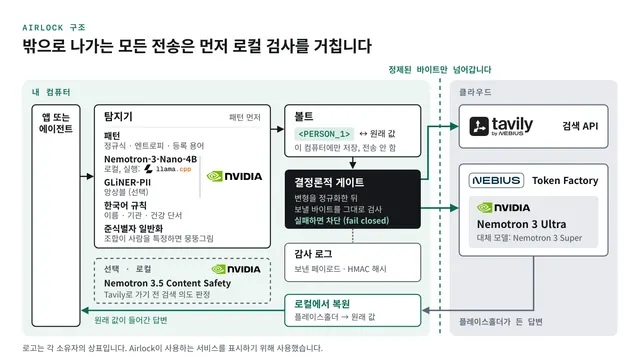
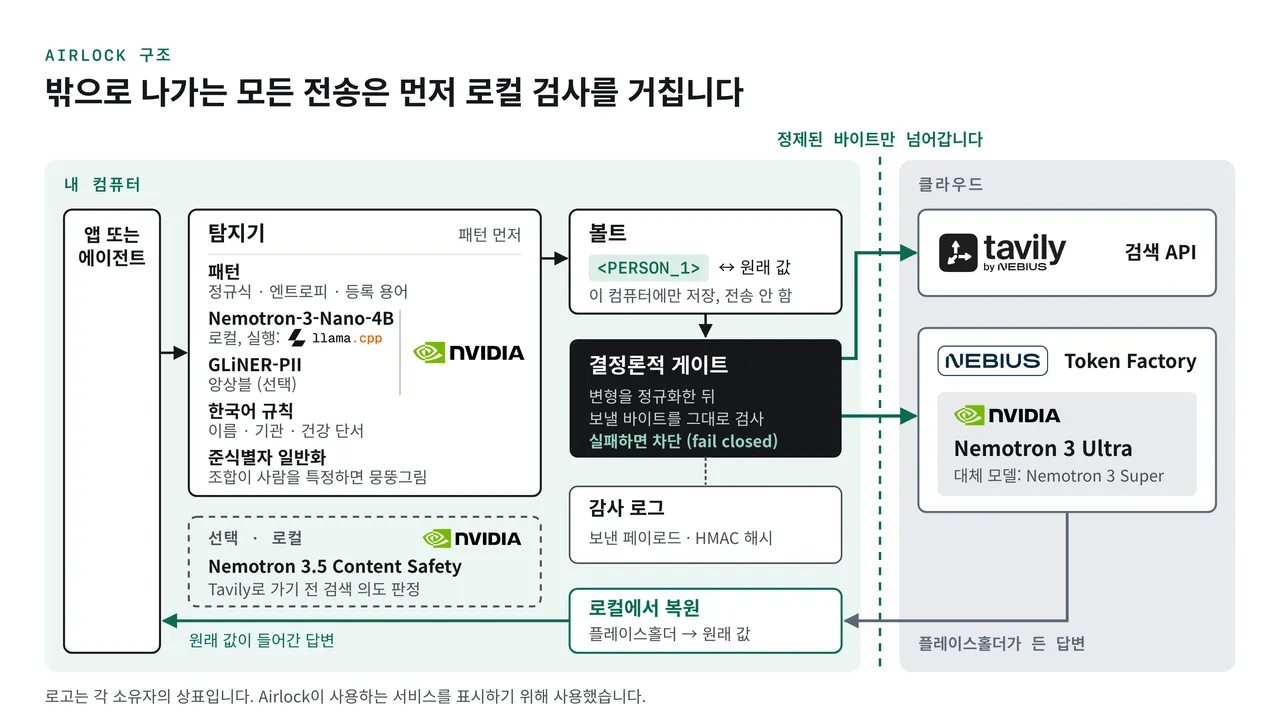
2편은 AI 에이전트용 이그레스 방화벽 Airlock의 첫 독립 측정을 다뤘습니다. 합성 케이스 243건에서 연결 가능한 노출은 그대로 보낼 때의 84.7%에서 13.9%로 줄었고 남은 연결은 전부 준식별자 케이스였으며 한국어 성능이 영어보다 낮았습니다. 이 글은 같은 하네스로 같은 243건을 다시 측정해 7.5%에 이르기까지 무엇을 시도했고 어떤 설정을 비교했으며 어느 쪽을 왜 채택했는지를 적은 기록입니다. 각 변경의 절제 실험(ablation) 결과를 표로 함께 실었습니다. Nebius × NVIDIA Global AI Hackathon 출품작의 일부로 작성했습니다.
2편이 남긴 두 가지 약점
2편의 독립 실행(201341b)에서 Airlock은 연결 가능한 노출 13.9% ± 0.6과 신원 누출 8.6% ± 0.7을 기록했고 유용성 4.16에 왜곡 15.2%, 과잉 가림 7.1%, 무해 프롬프트 마스킹 11.1%였습니다. 약점은 둘이었습니다. 3회 모두 연결된 9건과 한 번이라도 연결된 18건이 모두 준식별자 프롬프트였고 직함과 기수와 작은 지명처럼 하나씩은 무해한 속성의 조합이 원인이었습니다. 둘째는 한국어 성능입니다. 신원 누출은 한국어 10.6%와 영어 6.5%였고 무해 마스킹은 전부 한국어에서 나왔으며 한국어 무해 검색 2건은 모든 회차에서 차단됐습니다.
두 약점의 원인은 같은 트레이드오프입니다. 속성을 하나 더 일반화하면 연결은 줄지만 왜곡과 과잉 가림이 오릅니다. 아래 전략들은 왜곡과 과잉 가림을 늘리지 않으면서 연결을 줄이는 방법을 찾는 과정이었습니다.
반복 개선의 측정 절차
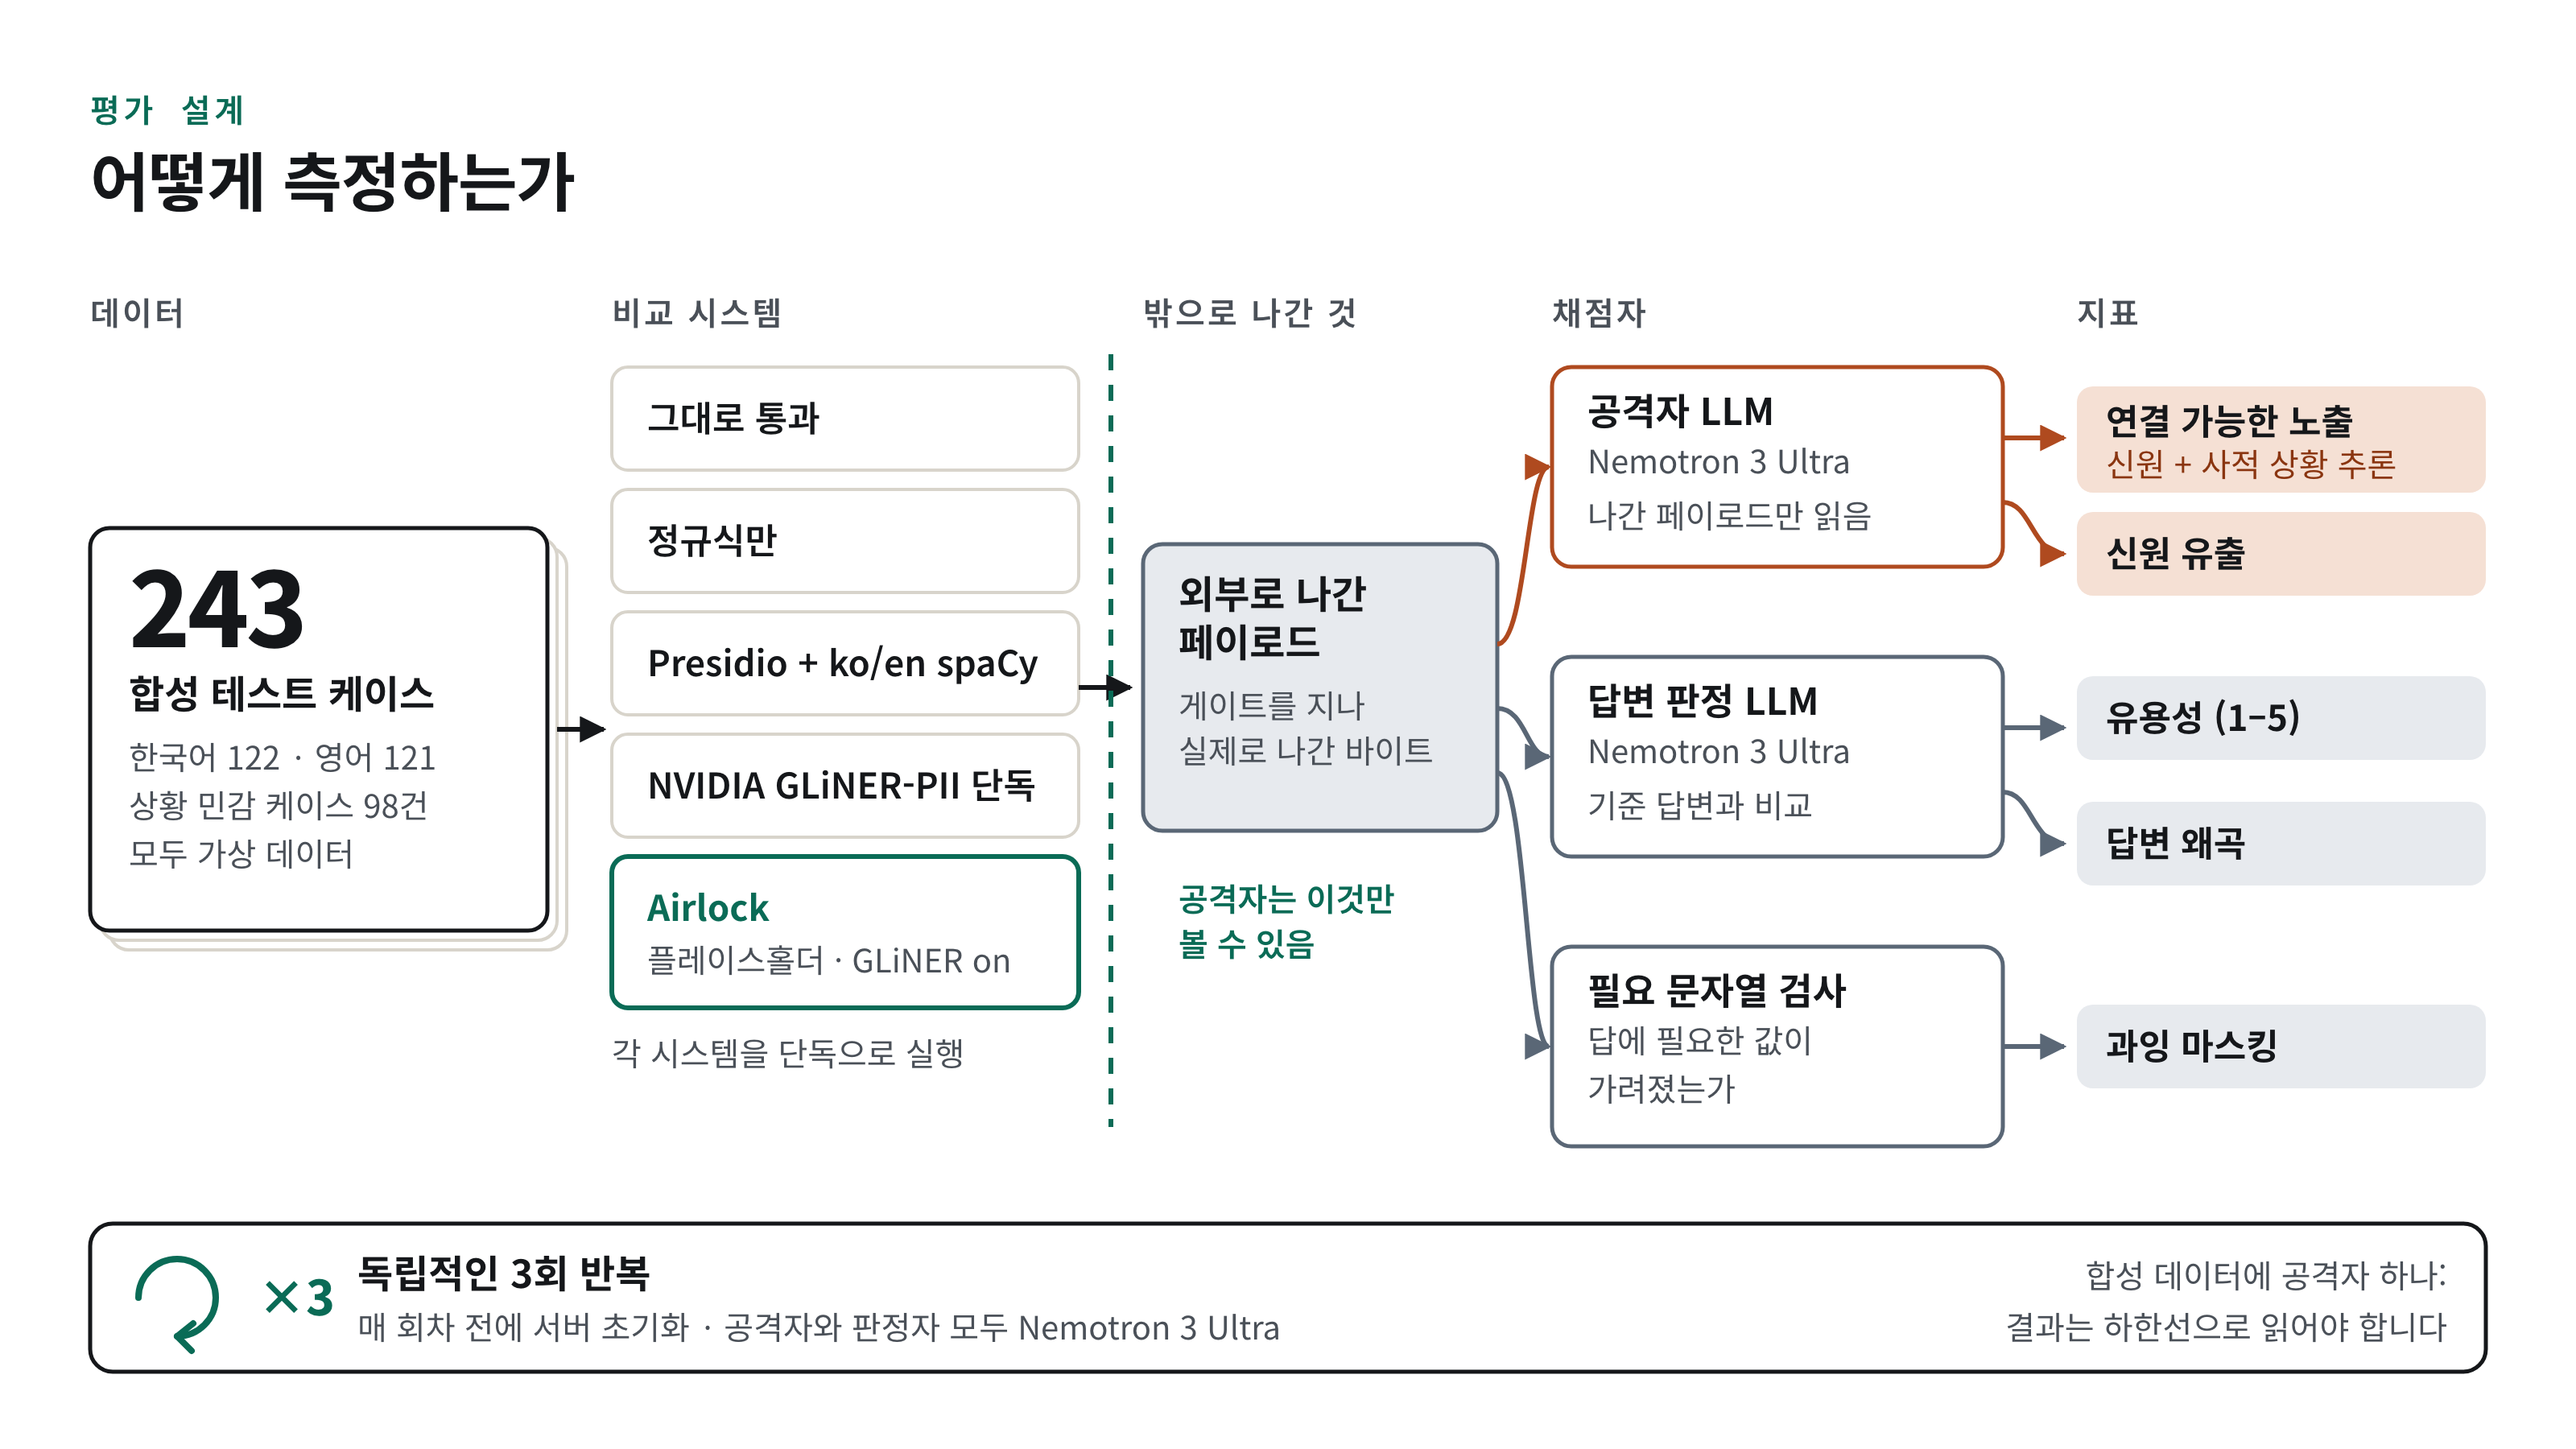
- 개발과 시험 분할: 시드 20260914로 카테고리와 언어에 따라 층화해 72건을 개발 분할로, 171건을 시험 분할로 나눴습니다. 규칙과 임계값과 변형 선택은 개발 분할만 보고 정하고 보고는 시험 열로 합니다. 최종 243건에 개발 분할이 들어 있으므로 최종 수치는 보류 세트 추정치가 될 수 없습니다.
- 회차 독립성: 2편의 캐시 버그 뒤로 모든 실행은 회차마다 서버를 초기화하고 회차별 탐지 시간 중앙값으로 확인합니다.
- 공격자와 심판 잡음: 공격자는 온도 0이고 1회차 페이로드를 세 번 공격하니 연결 가능한 노출은 8.2 / 8.2 / 8.2%로 같은 8건이 매번 연결됐습니다. 최종 표의 표준편차는 탐지기 샘플링에서 나옵니다. 심판은 답변 쌍을 비교하므로 유틸리티 비율 약 ±0.05와 왜곡 약 ±3포인트 이내의 차이는 읽지 않습니다.
심판 모델을 Nemotron 3 Ultra로 유지한 근거도 측정했습니다. 더 저렴한 Super와 Lightning과 Nano로 네 채점 역할을 층화 표본에서 다시 실행하고 헤드라인 비율이 Ultra에서 ±3pp(유틸리티 비율은 ±0.03) 안에 머무는지를 봤습니다.
| 역할 | 후보 | 가장 큰 이탈 | 판정 |
|---|---|---|---|
| 공격자 | Lightning | 상황 추론 −17.5pp | 탈락 |
| 공격자 | Nano | 준식별자 재식별 +12.5pp | 탈락 |
| 채점기 | Nano | 상황 추론 +21.9pp, 카파 0.19 | 탈락 |
| 유틸리티 심판 | Super | 왜곡 −15.1pp | 탈락 |
| 왜곡 확인 | Lightning | 144건 재검에서 −3.5pp, 카파 0.81 | 탈락 |
| 채점기 | Ultra 재시험 | 상황 추론 +1.6pp, 카파 0.89 | 기준 잡음 |
모든 후보가 헤드라인 숫자 하나 이상을 허용치 밖으로 움직여 네 역할 모두 Ultra를 유지했고 채점 비용은 프로토콜 규모 조정으로 줄였습니다. 베이스라인은 출력이 같으므로 한 번만 채점하고 해시로 재사용합니다. 보정 실험은 $0.51, 최종 실행의 채점은 $3.69였습니다.
전략 1 앙상블의 재현율과 합의의 정밀도
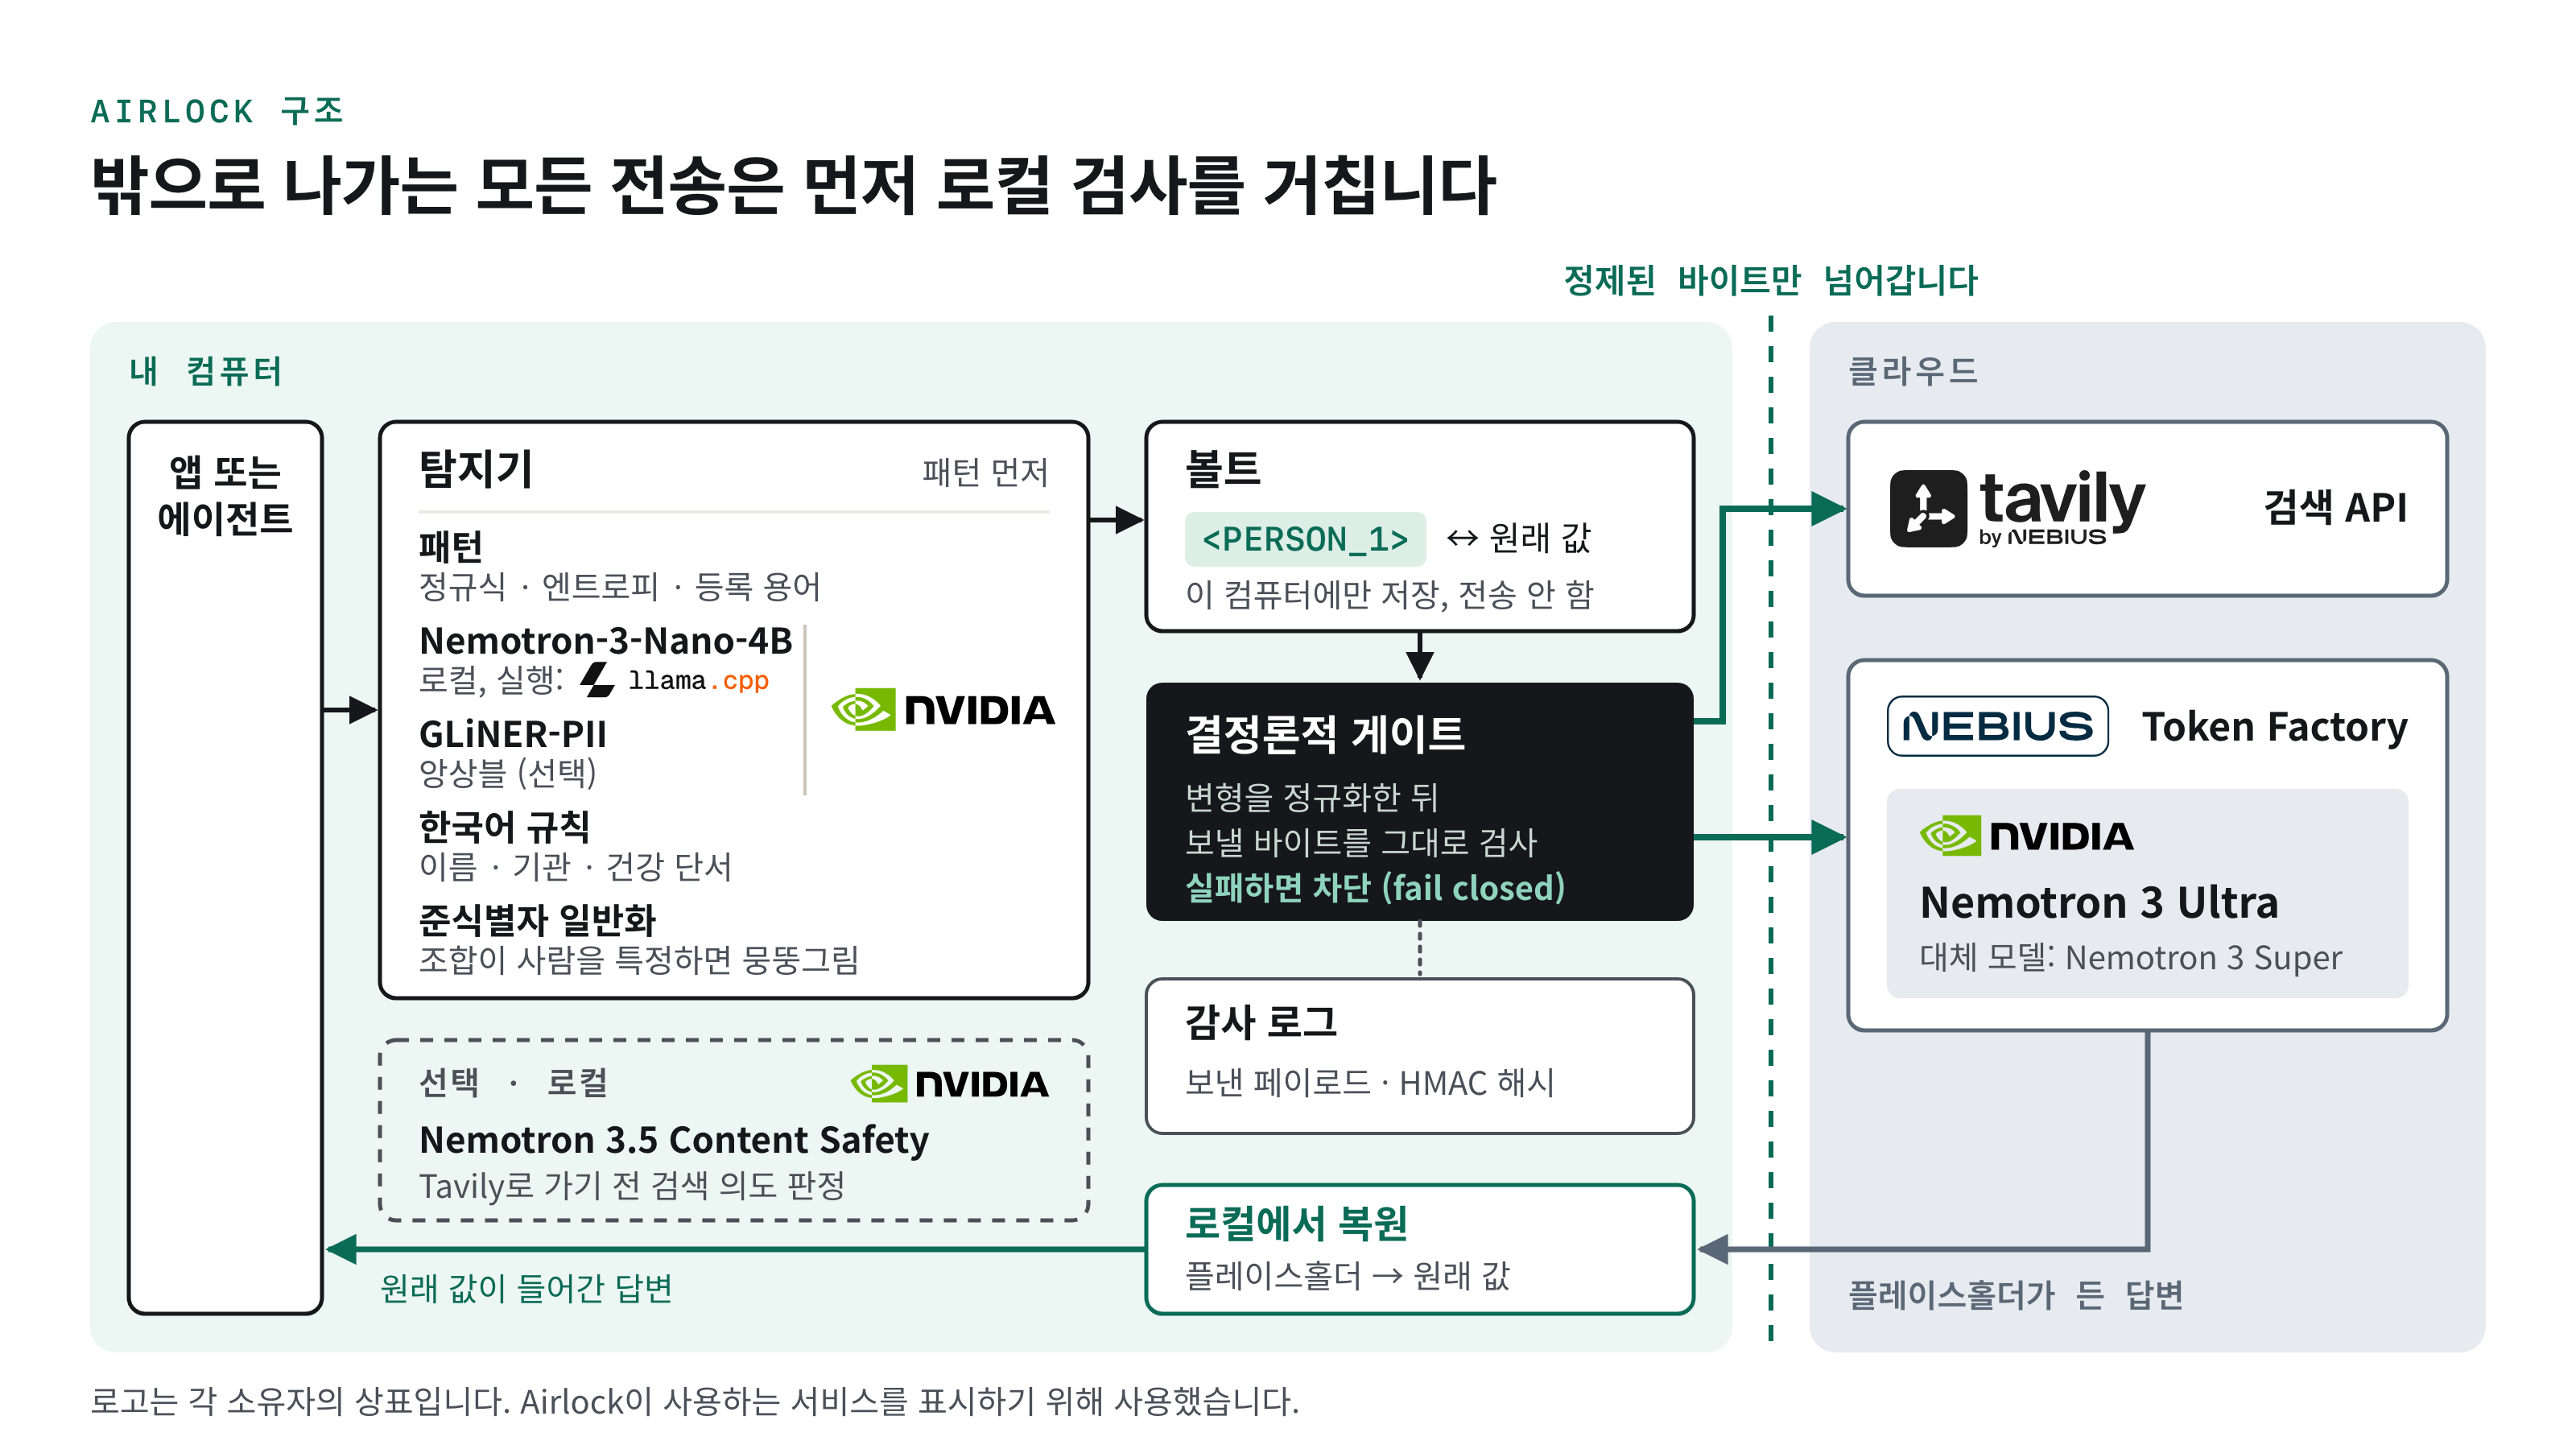
NVIDIA GLiNER PII 단독은 재현율이 높지만 무해한 프롬프트의 59.3%를 가리고 유용성 2.69에 그칩니다. 영어로만 학습해 qid-ko-01에서는 나이를 PASSWORD로, 회사명을 RELIGIOUS_BELIEF로 분류했습니다. 그래서 세 단계 필터를 거칩니다. 정규식이나 한국어 규칙이나 Nano가 이미 겹치는 스팬을 냈으면 합의로 받습니다. GLiNER만 찾은 스팬은 결정적 형태 검사를 거쳐 SECRET은 엔트로피나 패턴, 전화번호와 ID는 숫자 형태, PERSON은 성씨로 시작하는 한글 음절이나 대문자 라틴 단어여야 합니다. 통과한 후보만 요청당 한 번의 배치 호출로 Nano에게 사적인 값인지 묻습니다. 임계값은 0.4인데 개발 분할에서 점수는 0.3에서 0.6 사이 어디에서도 참과 거짓 스팬을 가르지 못했습니다.
비교한 설정은 B와 B1입니다. B는 모든 라벨을 판정에 보내고 2음절 한글 이름을 받습니다. B1은 AIRLOCK_GLINER_AGREEMENT_ONLY=city,date_of_birth로 도시와 생년월일은 합의가 있을 때만 받고 AIRLOCK_GLINER_KO_NAME_MIN_SYLLABLES=3으로 한글 이름은 3음절부터 GLiNER 단독으로 받습니다. 개발 분할에서 GLiNER 단독 도시는 받아들인 8건 중 4건이 틀렸고 유일한 무해 오탐은 2024-01-01을 생년월일로 본 것이었으며 2음절 한글 "이름" 3건 중 2건은 보통 명사였습니다.
| 시험 분할 171건 | A (GLiNER 끔) | B (모든 라벨 판정) | B1 (기본값) |
|---|---|---|---|
| 누출률 | 26.3% | 8.6% | 11.2% |
| 카나리 누출 | 14.1% | 2.0% | 1.0% |
| 준식별자 재식별 | 38.9% | 19.4% | 27.8% |
| 무해 마스킹 | 0.0% | 42.1% | 21.1% |
| 무해 차단 | 0.0% | 15.8% | 10.5% |
B1은 B보다 누출률이 2.6포인트 높지만 무해 마스킹은 절반이고 개발 분할에서는 12.5%에서 0.0%가 됩니다. 243건 전체에서 공격자가 심은 값을 온전히 복원한 비율은 GLiNER를 끄면 9.9%, B1은 1.0%입니다. 준식별자 재식별은 값만큼 줄지 않았습니다. GLiNER에는 역할이나 유일성 단서의 라벨이 없기 때문입니다.
대신 지연 시간이 늘었습니다. GLiNER 추론은 p50 457 ms이고 Nano와 병렬로 실행됩니다. Nano 판정은 채팅 요청 206건 중 58건(28%)에서만 필요했고 그때 p50 1,706 ms가 들었으며 B는 205건 중 78건을 판정해 p50 2,196 ms였습니다. Nano가 Metal에서 디코딩하는 동안에는 GLiNER가 MPS에서 p50 1,165 ms로 느려지고 CPU는 467 ms라서 기본값은 CPU입니다.
전략 2 가림 대신 비연결성
앙상블은 개별 값을 탐지했지만 속성 조합은 탐지하지 못했습니다. 그래서 문자열을 지우는 대신 조합이 k명 미만을 가리키지 않게 만드는 쪽으로 목표를 바꿨습니다.
첫 번째 변경은 직장과 조직 단위와 역할을 묶어 일반화한 것입니다. 동해누리정밀(주) 품질보증팀 박성훈 팀장은 <ORG_1> 품질 부서 <PERSON_1> 관리자로 나갑니다. 동시에 금액과 검사 수치와 흔한 진단명은 남기고 일반화는 원문에서 함의되는 것만 허용했습니다.
| 시험 90건 | B1 | 조직 단위 일반화 |
|---|---|---|
| 연결 가능한 노출 | 16.7% | 8.3% |
| 상황 추론 | 55.0% | 72.5% |
| 과잉 가림 (171건) | 15.5% | 7.8% |
| 유틸리티 비율 | 0.91 | 0.87 |
| 왜곡 | 16.2% | 27.6% |
연결과 과잉 가림은 절반이 됐고 상황 추론은 올랐습니다. 에이전트 4개 시나리오에서는 이전에 모든 회차를 살아남던 품질보증팀 같은 팀 이름을 포함해 신원 사실 19개 중 0개가 나갔습니다. 대신 왜곡이 올랐습니다.
다음으로 그 왜곡을 저장된 페이로드와 답변만으로 원인별로 분류했습니다. 조직 단위 일반화에서만 왜곡된 14건 중 6건은 페이로드가 B1과 같은 심판 잡음이었고 4건은 남겨 둔 진단명 주위에 업스트림이 세부를 덧붙인 경우였습니다. 왜곡 21건 전체로는 오독 8건, 과제 값 마스킹 1건(복약 시각 7시, 11시, 15시, 19시), 진단명 재작성 1건, 덧붙임 5건, 업스트림 오류 6건입니다. 오독 8건 중 6건은 토큰 타입이 틀렸습니다. 회사 둘이 <PERSON_n>으로, 직함이 <ID_NUMBER_1>로 나갔습니다.
원인별로 수정했습니다. 업스트림에 보내는 플레이스홀더 안내문에 <ORG_n>은 기관명이고 <SECRET_n>은 사용자가 적은 그대로의 비밀값이라는 타입 범례를 붙이고 값을 플레이스홀더라 부르거나 토큰으로 계산하지 말라고 적었습니다. 타입은 이미 페이로드에 보이므로 범례는 아무것도 새로 드러내지 않습니다. 등록어에는 표면형으로 타입을 붙이고 "끝 4자리" 뒤의 번호는 끝 4자리만 복원하며 기본 수준에서는 복약 시각과 검사 수치와 금액과 진단명처럼 과제가 다루는 값을 남깁니다. 개발 분할에서 왜곡은 35.7%에서 6.7%로, 과잉 가림은 9.9%에서 6.0%로 내려갔고 연결 가능한 노출은 13.3%로 같았습니다.
세 번째 변경은 조합 자체를 점수화한 것입니다. 준식별자 속성은 장소와 명명된 기관과 기수와 드문 사실과 역할과 나이와 가족 구성의 일곱 범주로 나뉘고 앞의 넷은 2점, 뒤의 셋은 1점이며 범주마다 전송 텍스트에 남은 가장 구체적인 속성 하나만 셉니다. 합이 k 이상이면(기본 수준 3, 엄격 수준 2) 가장 식별력 높은 속성부터 k 미만이 될 때까지 일반화합니다. 표는 결정적이고 함의 관계를 지킵니다.
| 속성 | 원문 | 일반화 |
|---|---|---|
| 작은 지명 | 경북 새내군 | 경북의 한 군 지역 |
| 기수 연도 | 2022년 행정고시 | 2020년대 행정고시 |
| 전문 분야 | pediatric cardiologist | physician |
| 순위 | 수석 | 상위권 |
| 소규모 위원회 | five-member planning commission | local board |
속성의 내용어가 메시지 다른 곳에 나오면 질문이 그것에 관한 것이므로 남기고 사람에 관한 메시지만 점수화합니다. 로컬 모델 호출은 없습니다. 개발 분할에서 신원 누출은 8.9%에서 2.4%로, 왜곡은 20.7%에서 11.9%로 내려갔고 유틸리티 비율은 1.01에서 1.05였습니다. 2편의 지속 연결 9건을 로컬 스캔으로 진단하니 이전 코드는 18회 중 16회가 케이스의 k에 닿았고 새 코드는 3회만 닿았습니다. 최종 243건에서 스캐너의 준식별자 재식별은 28.7%에서 11.3%로, 3회 모두 연결된 케이스는 9건에서 4건으로 줄었습니다.
되돌린 시도도 있습니다. 한국어 검색 재작성을 한국어로 유지하게 하자 개발 분할의 한 회차에서 사적 세부가 남고 검색 2건이 차단됐습니다. 프롬프트는 원래대로입니다.
전략 3 플레이스홀더와 대체값의 비교
신원 값을 <PERSON_1> 같은 플레이스홀더로 바꿀지 형식을 지킨 가짜 값으로 바꿀지는 측정 전에 규칙을 정했습니다. 대체값이 왜곡을 키우지 않으면서 연결을 뚜렷이 줄일 때만 기본값을 바꿉니다.
| 지표 | 대체값 e0ee6aa † | 플레이스홀더 201341b | 플레이스홀더 eb311ed |
|---|---|---|---|
| 연결 가능한 노출 | 12.6% | 13.9% | 7.5% |
| 신원 누출 | 8.3% | 8.6% | 3.1% |
| 상황 추론 | 54.0% | 72.8% | 71.6% |
| 유용성 | 4.08 | 4.16 | 4.15 |
| 왜곡 | 19.4% | 15.2% | 14.9% |
† 표시는 2편의 캐시된 실행이라 표준편차를 재지 못한 행입니다. 같은 캐시 실행의 플레이스홀더는 연결 15.3%와 왜곡 14.7%였으니 그 탐지기에서 대체값은 연결을 1.3포인트 줄이고 왜곡을 4.2포인트 키웠습니다. 상황 추론 54.0%는 프라이버시 이득으로 읽지 않았습니다. 클라우드가 문제를 이해하지 못했다는 뜻입니다. 조직 단위 일반화의 시험 90건에서도 대체값은 신원 누출이 8.3%로 플레이스홀더 9.0%보다 낮았지만 연결은 11.1%로 8.3%보다 높고 왜곡은 32.9%로 27.6%보다 높았습니다. 왜곡의 형태도 달랐습니다. 대체값의 끝자리로 "끝나는" 카드, 번역 과제에서 음역된 가짜 이름, 대체값의 성별과 어긋난 대명사입니다. 그래서 플레이스홀더가 기본값으로 남았습니다. 대체값이 적합한 경우는 사용자가 디코딩하거나 계산하라고 준 값처럼 과제가 값 자체를 다루는 경우이고 AIRLOCK_SUBSTITUTION=surrogate로 남아 있습니다.
전략 4 정규화한 텍스트에서의 탐지
게이트는 처음부터 전각 문자와 분리된 자모와 끼워 넣은 공백과 한글로 적은 숫자를 정규화해 비교했습니다. 다만 게이트가 강제하는 것은 Airlock이 이미 아는 문자열뿐입니다. 김 민 지처럼 띄어 쓴 이름을 아무 탐지기도 값으로 보지 못하면 그대로 나가고 볼트에 있는 값이 변형으로 남으면 요청 전체가 차단됩니다. 마스킹 대신 차단이 일어나므로 201341b에서는 adv-ko-07이 모든 회차에서, adv-ko-13과 adv-ko-06과 adv-ko-02와 adv-ko-14가 일부 회차에서 이름과 카드 번호를 누출했습니다.
현재 버전은 탐지도 정규화한 뷰에서 실행합니다. 정규식과 한국어 이름 규칙이 띄어 쓰거나 점을 찍은 음절을 붙이고 분리된 자모를 합치고 한글과 한자와 영어 숫자를 아라비아 숫자로 바꾸고 전각과 닮은꼴을 접은 뷰에서 찾은 뒤 원문 오프셋으로 되돌립니다. 그래서 로컬 모델이 보기 전에 마스킹됩니다. eb311ed에서는 위 다섯 케이스가 어느 회차에서도 누출되지 않았습니다.
| 케이스 | 201341b | 원인 | 수정 |
|---|---|---|---|
ben-ko-08, ben-ko-13 | 모든 회차 차단 | GLiNER 단독 KTX와 불국사를 가린 뒤 재작성이 공개 명칭을 남겨 게이트가 차단 | 사람 단서 없는 요청의 GLiNER 단독 기관과 장소는 주제로 보고 남김 |
ben-ko-09 | 마스킹 | 장영실이를 인물로 판단 | 공인 목록의 스팬은 버림 |
adv-ko-07, adv-ko-14 | 과잉 가림 | 직함 선임연구원을 ORG나 PERSON으로 분류 | 직함만 있는 스팬은 PERSON이 될 수 없음 |
데모 녹화에서 확인한 정밀도 문제는 구조 검사로 해결했습니다. 한국어 사직 시나리오의 검색 질의가 <PERSON_8> 수급 자격 <PERSON_7>법으로 나갔습니다. 실업급여와 고용보험이 사람으로 제안됐는데 모델 PERSON 스팬의 유일한 형태 검사가 "숫자 네 자리 미만"이었기 때문입니다. 이제 한글 PERSON 스팬은 이름당 2음절에서 4음절이고 성씨 음절로 시작해야 하며 증과 법과 사처럼 명사는 끝나지만 이름은 끝나지 않는 음절로 끝나면 안 됩니다. 모든 검사를 통과하는 위로금과 배우자 같은 법률 용어는 짧은 제외 목록으로 막습니다. 나이와 출생 연도는 슬롯에 맞춰 34살입니다는 30대입니다로, born in 1992는 born in the 1990s로 바뀌고 이전의 "I'm age"는 사라졌습니다. 개발 분할의 한국어 과잉 가림은 6.5%에서 3.5%로 내려갔습니다.
최종 실행에서 한국어는 신원 누출 10.6%에서 2.6%로, 무해 마스킹 23.1%에서 0.0%로 바뀌어 누출은 영어보다 낮아졌습니다. 유용성 격차는 남았습니다. 유틸리티 비율 0.88과 영어 1.03, 왜곡 17.6%와 12.1%입니다. 기준 답변 자체가 한국어에서 4.58로 영어 4.17보다 높게 채점되므로 격차의 일부는 기준 답변의 점수 차이에서 옵니다.
에이전트 모드의 전후 비교와 새로 확인된 결함
에이전트 모드는 채팅과 같은 탐지 진입점을 씁니다. 매 턴 전체 이력을 다시 탐지하고 한 슬롯에서 찾은 값은 게이트 전에 그 턴의 모든 슬롯에서 가립니다. 조직 단위 일반화의 첫 시도는 GLiNER가 도구 인자 키 doc_id를 HTTP 쿠키로 읽어 세 번째 턴에서 모든 실행을 막았고 이후 도구 호출 인자의 객체 키는 다시 쓰지 않습니다. 검색 질의는 Nano가 일반적인 정보 탐색 질의로 다시 쓰고 게이트와 의도 판정기를 거치며 재시도 뒤에도 거절되면 그 검색만 막습니다.
| 지표 | 보호 없음 | Airlock d2ff994 | Airlock eb311ed |
|---|---|---|---|
| 사적 사실 복원 (모든 전송 구간) | 82.3% ± 2.8 | 41.3% ± 4.2 | 23.6% ± 3.2 |
| 신원 누출 (스캐너) | 95.8% ± 3.6 | 77.1% ± 3.6 | 33.3% ± 9.5 |
| 연결 가능한 노출 | 83.3% ± 3.6 | 68.8% ± 6.2 | 17.2% ± 8.2 |
| 상황 추론 (앵커 불필요) | 87.5% ± 6.2 | 93.8% ± 6.2 | 87.1% ± 6.9 |
| 답변 유용성 (루브릭 1~5) | 4.38 ± 0.29 | 4.71 ± 0.18 | 4.50 ± 0.49 |
| 완료된 실행 | 100% | 100% | 93.8% ± 6.2 |
| 실행당 지연 중앙값 | 24초 | 367초 (GPU 공유) | 216초 |
전략 2는 문서 입력에도 효과가 있었습니다. 팀 이름과 고용주가 사라지면서 연결은 68.8%에서 17.2%로 내려갔고 상황 추론은 두 모드 모두 87%대입니다. 검색 질의는 93.2%가 다시 쓰였고 질의만 본 공격자의 상황 추론은 16.7%에서 0.0%로 내려갔습니다. 블라인드 쌍 비교 심판은 보호된 답변을 더 높이 봤습니다(유틸리티 비율 1.09, 왜곡 14.6%와 27.1%). 남은 사실 복원 23.6%는 탐지기가 놓친 값입니다.
새 결함도 확인됐습니다. 보호된 실행 48회 중 3회가 답변 없이 blocked로 끝났고 영어 유용성 4.50과 5.00의 차이는 전부 여기서 나옵니다. pregnancy-en 2회는 검색 결과 페이지에 개인 메모에서 볼트에 넣은 건강 단어가 들어 있어 게이트가 그 도구 결과를 보내지 않은 경우이고 debt-en 1회는 로컬 탐지기가 반복 루프에 빠져 턴이 닫힌 경우입니다. 게이트는 설계대로 동작했지만 임신에 관한 공개 페이지는 누출이 아닙니다.
저장된 감사 기록으로 원인을 확인했습니다. pregnancy-en 2회는 게이트와 마스커가 공개 검색 텍스트를 두고 어긋난 경우입니다. 영어 건강 규칙이 검색 결과의 pregnant를 잡아 범주인 pregnancy로 일반화했는데 같은 페이지의 pregnancy는 이미 자기 범주와 같은 단어라 일반화 검사에서 거부돼 <HEALTH_1>로 가려졌습니다. 그래서 나가는 이력에는 볼트 원본이 구조적으로 들어 있었습니다. 게다가 위치가 있는 규칙 스팬은 매치된 문장만 가리는데 게이트는 모든 출현을 비교합니다. debt-en 1회는 로컬 탐지기가 두 샘플 모두에서 반복 루프에 빠져 local_detector_malformed:repetition으로 턴이 닫힌 경우입니다.
수정은 564fe0a로 병합했습니다. 자기 범주와 같은 건강 용어는 기본 수준에서 남기고 일반화는 요청의 모든 원본에 대해 검증하며 위치가 있는 스팬은 모든 출현에서 치환합니다. 에이전트 모드에서 마스킹 뒤에도 게이트가 거절하는 도구 결과는 턴을 막는 대신 그 결과만 빼고 에이전트에게 알린 뒤 턴을 다시 만듭니다. 탐지기가 잘못된 답을 내면 새 시드와 온도 +0.2로 한 번 더 돌리고 그래도 실패하면 결정적 탐지와 규칙과 모든 GLiNER 스팬을 전부 가리는 강등 모드로 그 턴을 처리하고 감사 기록에 detector_degraded로 표시합니다. 게이트는 그대로 실행되고 문서와 질문은 여전히 차단하며 채팅 경로는 그대로 닫힌 채 실패합니다. 테스트 10개를 더해 560개가 통과합니다.
영향받은 시나리오 둘과 대조군 pregnancy-ko를 Airlock 모드로 2회씩 다시 실행했고 클라우드 호출은 약 36회였습니다.
| 시나리오 | 완료 / 차단 | 루브릭 유용성 | 아웃바운드에 남은 신원 사실 |
|---|---|---|---|
pregnancy-en | 2 / 0 | 5.00, 5.00 | 0 |
pregnancy-ko | 2 / 0 | 5.00, 5.00 | 0 |
debt-en | 2 / 0 | 5.00, 5.00 | 카드 끝 4자리 4417 |
6회 모두 끝났고 차단은 없었으며 루브릭 유용성은 6회 모두 5.00입니다. debt-en의 카드 끝 4자리 4417은 eb311ed 실행의 아웃바운드에도 있던 탐지기 누락이라 회귀로 보지 않고 금액과 날짜와 임신 11주 같은 상황 사실은 설계대로 남습니다. 16개 시나리오 × 2모드 × 3회의 전체 에이전트 평가는 이 수정 뒤에 다시 실행하지 않았습니다. 위 표와 README의 에이전트 수치는 eb311ed 기준이고 전체 표는 10월 데모와 제출 전에 다시 잽니다.
최종 결과와 남은 과제
같은 데이터와 같은 채점 모델로 회차마다 초기화한 두 독립 실행의 차이입니다.
| 지표 | 201341b | eb311ed | 변화 |
|---|---|---|---|
| 연결 가능한 노출 | 13.9% ± 0.6 | 7.5% ± 0.6 | −6.4pt |
| 신원 누출 (스캐너) | 8.6% ± 0.7 | 3.1% ± 0.3 | −5.5pt |
| 준식별자 재식별 (스캐너) | 28.7% ± 2.3 | 11.3% ± 2.3 | −17.4pt |
| 상황 추론 | 72.8% ± 1.1 | 71.6% ± 2.8 | 설계상 유지 |
| 유용성 / 유틸리티 비율 | 4.16 / 0.95 | 4.15 / 0.95 | 유지 |
| 왜곡 (기준 답변) | 15.2% (7.7%) | 14.9% (10.0%) | 잡음 안 |
| 과잉 가림 | 7.1% | 5.3% | −1.8pt |
| 무해 마스킹 / 차단 | 11.1% / 7.4% | 0.0% / 0.0% | 0으로 |
| 로컬 오버헤드 p50 / p95 | 4,004 / 8,771 ms | 4,179 / 9,379 ms | +175 / +608 ms |
| 언어별 | 201341b ko | eb311ed ko | 201341b en | eb311ed en |
|---|---|---|---|---|
| 신원 누출 | 10.6% | 2.6% | 6.5% | 3.6% |
| 연결 가능한 노출 | 14.0% | 6.7% | 13.9% | 8.3% |
| 유틸리티 비율 | 0.86 | 0.88 | 1.04 | 1.03 |
| 과잉 가림 | 10.0% | 7.5% | 4.3% | 3.1% |
차단된 보호 에이전트 실행은 eb311ed에서 3/48이었고 수정 뒤 영향받은 시나리오에서는 0/6입니다. 전체 재측정은 남아 있습니다.
일반화할 원칙은 넷입니다. 재현율은 앙상블에서 얻고 정밀도는 합의와 결정적 형태 검사에서 얻으며 맥락 판단만 모델에 묻습니다. 문자열 대신 조합을 점수화하고 질문이 다루는 속성은 남깁니다. 왜곡은 저장된 페이로드와 답변을 읽어 메커니즘별로 세어야 고칠 수 있고 대부분은 토큰 타입 문제였습니다. 게이트는 아는 문자열만 강제하므로 변형은 탐지가 잡아야 합니다.
남은 것은 4건입니다. qid-en-06은 2025년 1월에 문을 닫은 콜로라도 소기업의 전직 CFO, qid-en-11은 조지아 고등학교의 AP 화학 교사이자 주 우승 수구팀 골키퍼, qid-ko-10은 인천 연수구 <LOCATION_1> 아파트 관리사무소장, qid-ko-14는 경북 군 지역에서 사과 농사를 짓는 30대 귀농 부부입니다. 학교와 아파트는 가려졌고 직업은 일반화됐지만 구와 월과 팀 사실 같은 속성 하나가 더 남아 조합이 k에 닿습니다. 이 4건을 없애려면 조직 단위 일반화와 왜곡 수정으로 확보한 유용성을 일부 다시 잃어야 합니다.
조합 점수화 규칙은 2편의 지속 연결 9건과 72건 개발 분할을 보고 조정했고 그 케이스들이 243건에 들어 있으므로 최종 수치는 보류 세트 추정치가 아닙니다. 전체 표와 변경별 기록은 저장소의 eval/results/에 있습니다.
git clone https://github.com/tristan-kkim/airlock && cd airlock
uv sync --extra gliner
eval/final_protocol.sh --commit eb311ed --gliner on --substitution placeholder --passes 3 \
  --reuse-committed --publish --systems "raw regex presidio_ko gliner_pii airlock" --yes
uv run python eval/results/s10-hardening/report.py
시리즈와 저장소
1편 AI 에이전트용 이그레스 방화벽 Airlock 소개는 만든 이유와 동작 방식과 측정 설계를, 2편 AI 에이전트 이그레스 방화벽 Airlock의 첫 측정 결과는 첫 독립 측정과 캐시 버그를 다룹니다. 코드와 평가 하네스는 github.com/tristan-kkim/airlock에 Apache 2.0 라이선스로 공개했습니다.
코텍시스 창업자로 AX 컨설팅과 기업 AI 교육, AI 에이전트 개발을 직접 수행합니다.
코텍시스 AI 인사이트 최신 논문 리뷰
AWQ 양자화: 활성값을 보고 가중치를 지키는 4비트 양자화
MIT 연구진의 AWQ는 활성값 분포를 기준으로 중요한 가중치 1%만 보호해도 저비트 양자화 오류가 크게 줄어든다는 관찰에서 출발해 재학습 없는 4비트 양자화를 구현했고 전용 커널 TinyChat으로 FP16 대비 3배 이상의 추론 속도를 달성했습니다. 온프레미스 sLLM을 소수의 GPU로 서빙해야 하는 기업에게 정확도 손실 없이 메모리와 비용을 동시에 줄이는 사실상의 표준 기법입니다.
Mixtral 8x7B로 읽는 MoE 아키텍처: 13B의 연산으로 70B급 성능 내기
총 47B 파라미터 중 토큰당 13B만 활성화하는 희소 MoE 모델 Mixtral 8x7B는 Llama 2 70B와 GPT-3.5를 대부분의 벤치마크에서 따라잡거나 능가했습니다. 추론 연산량은 소형 모델 수준으로 유지하면서 품질을 끌어올리는 MoE의 실용성을 입증한 사례로, 기업의 자체 호스팅 모델 선정 기준에 직접 영향을 줍니다.
DPO가 바꾼 선호 정렬 학습: 보상 모델 없이 RLHF를 대체하는 방법
DPO는 보상 모델의 재매개변수화를 통해 최적 정책을 닫힌 형태로 유도하고, 선호 데이터에 대한 단순 분류 손실만으로 RLHF와 같은 목적을 달성하는 기법입니다. 강화학습 파이프라인을 운영할 여력이 없는 기업 프로젝트에서 선호 정렬을 현실적인 작업 범위로 만들어 준 논문입니다.
AI 솔루션이 필요하신가요?
cortexys.team에서 맞춤 AI 개발 서비스를 확인하세요.