Zoom 연구진이 176개 설정으로 코딩 에이전트 하네스의 계획, 도구, 컨텍스트 관리 효과를 측정했습니다. 약한 모델은 계획과 도구 집합으로 정확도가 올랐고 강한 모델은 계획과 bash 전용으로 비용이 줄었습니다.
연구 개요와 실험 설계
Zoom과 UMass Amherst, Emory University, UNC Charlotte 연구진이 2026년 9월 17일 An Empirical Study of Harness Design for Coding Agents를 공개했습니다. 코딩 에이전트의 하네스(harness)를 구성 요소 단위로 나눠, 어떤 설정이 정확도와 비용을 얼마나 바꾸는지 측정한 연구입니다. 하네스는 모델을 감싸고 계획, 도구 호출, 대화 기록 관리를 맡는 소프트웨어 계층으로 Claude Code, Codex, OpenHands 같은 제품이 여기에 해당합니다. 제1저자 두 명은 Zoom 인턴십 중에 이 연구를 수행했습니다.
연구진이 문제로 본 지점은 기존 비교 방식입니다. 완성된 하네스끼리 비교하면 계획, 도구 설계, 컨텍스트 관리가 한꺼번에 바뀌므로 성능 차이가 어디서 왔는지 알 수 없습니다. 논문이 인용한 선행 평가에서도 Claude Opus 4.5는 OpenHands에서, Claude Sonnet 4.5는 SWE-Agent에서 가장 좋은 성적을 냈습니다. 모델마다 맞는 하네스가 다를 수 있다는 신호입니다.
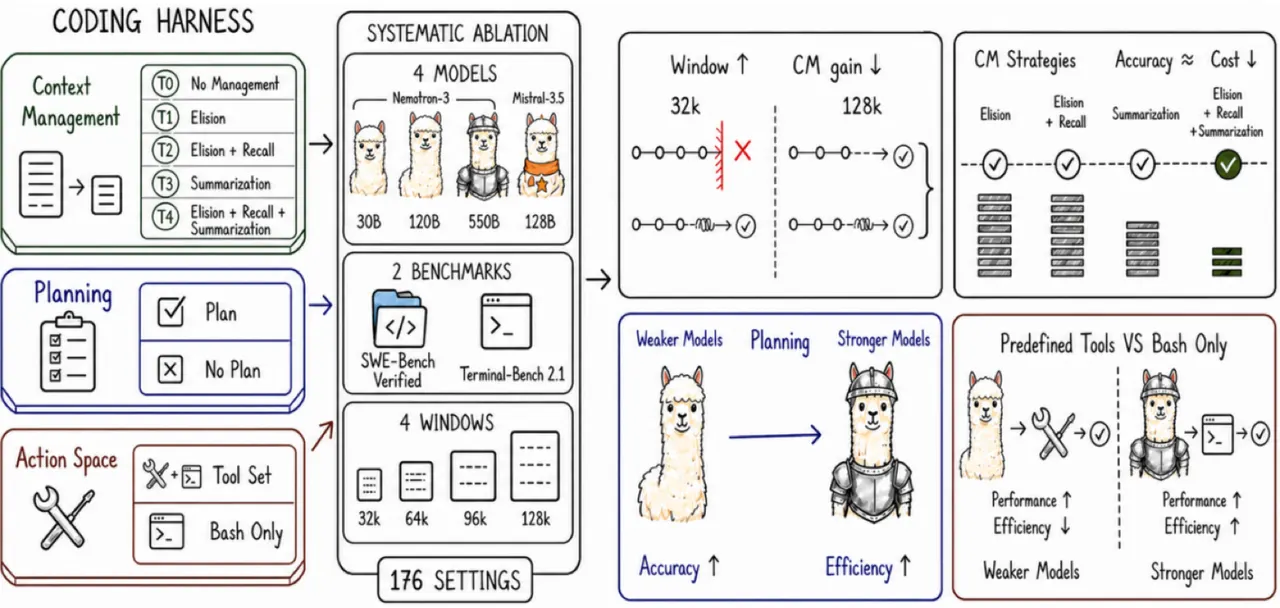
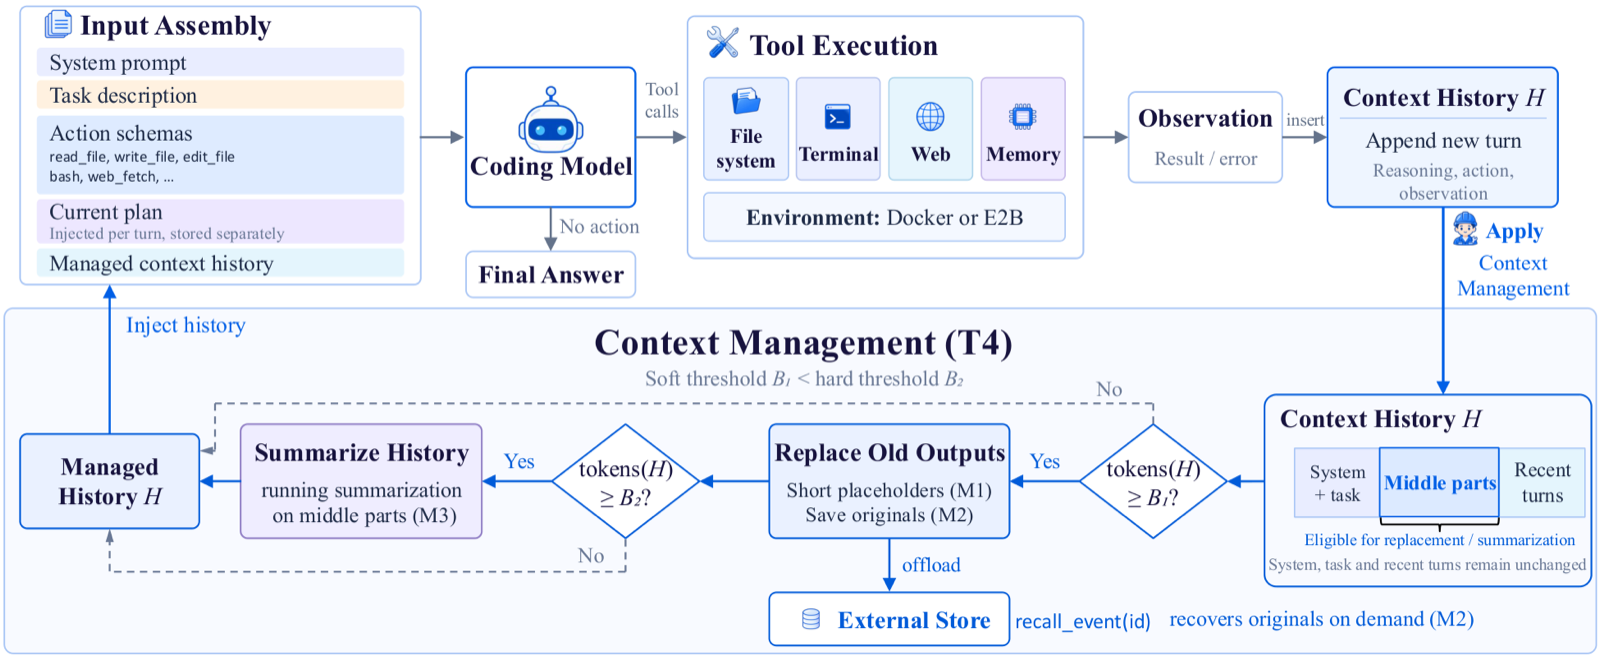
연구진은 ReAct 방식(추론, 행동, 관찰을 한 턴으로 반복)의 가벼운 하네스를 직접 만들고 실행 루프를 고정했습니다. 바꾼 것은 세 가지입니다. 계획 기능은 모델이 update_plan 도구로 작업 계획을 유지하고 매 턴 입력에 계획을 붙이는 방식입니다. 행동 공간은 파일 읽기·쓰기·편집, 검색, 웹 가져오기, bash를 갖춘 미리 정의한 도구 집합과 bash 하나만 남긴 인터페이스를 비교합니다. 컨텍스트 관리는 아래 다섯 단계로 나눴습니다.
| 단계 | 생략(M1) | 복구(M2) | 요약(M3) | 설명 |
|---|---|---|---|---|
| T0 | 없음 | 없음 | 없음 | 관리하지 않고 창이 넘치면 종료 |
| T1 | 사용 | 없음 | 없음 | 오래된 도구 출력을 짧은 표식으로 교체 |
| T2 | 사용 | 사용 | 없음 | 생략한 원문을 저장하고 recall_event로 다시 읽기 |
| T3 | 없음 | 없음 | 사용 | 오래된 기록을 같은 모델로 요약 |
| T4 | 사용 | 사용 | 사용 | 먼저 생략하고, 그래도 넘치면 요약 |
모델은 Nemotron-3 계열 30B, 120B, 550B 세 크기와 다른 계열인 Mistral-Medium-3.5-128B입니다. 네 모델 모두 연구진이 자체 서버에서 직접 실행했고 비용은 2026년 8월 OpenRouter 가격으로 환산했습니다. 벤치마크는 실제 GitHub 이슈 500건의 SWE-Bench Verified와 명령줄 과제 89건의 Terminal-Bench 2.1입니다. 컨텍스트 관리 5단계를 32k, 64k, 96k, 128k 창에서 모두 시험해 모델·벤치마크당 20개 설정을 만들고, T4/128k를 기준으로 계획 끄기와 bash 전용 두 설정을 더했습니다. 22개 설정에 4개 모델과 2개 벤치마크를 곱해 176개 설정이 됩니다.
고정한 요소의 값도 공개돼 있습니다. 과제당 최대 300단계, 약한 임계값은 사용 가능 창의 0.6, 강한 임계값은 0.85, 원문 그대로 두는 최근 구간은 0.3(최소 두 턴)입니다. 도구 결과는 2만 4천 자에서 자르고, 같은 호출이 다섯 번 반복되면 방식을 바꾸라는 알림을 넣고, 같은 실패 호출이 여덟 번 이어지면 실행을 끝냅니다. 권한 처리, 편집 후 자동 문법 검사, 읽기 후 쓰기 검사도 모든 설정에서 같습니다. 서브에이전트와 장기 기억은 이 연구의 실험 대상에 없습니다.
컨텍스트 관리와 창 크기
창이 좁을수록 커지는 효과
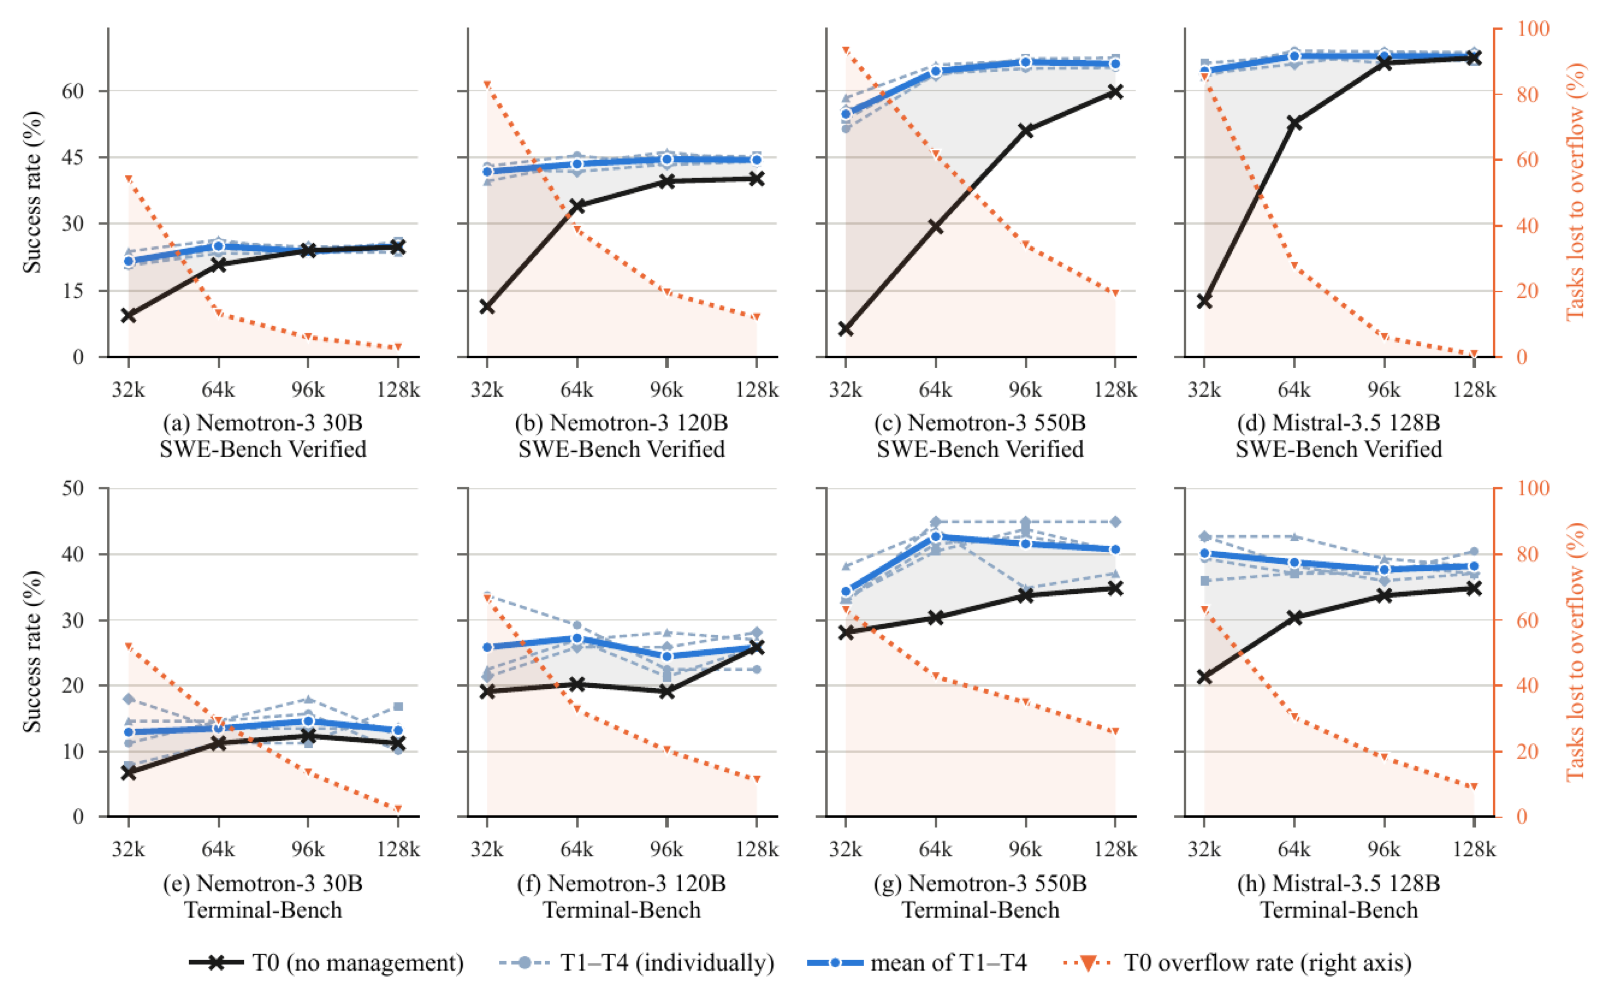
연구진은 관리 단계(T1~T4) 평균 성공률에서 T0 성공률을 뺀 값을 컨텍스트 관리의 가치로 정의했습니다. 네 모델 평균으로 이 격차는 창이 넓어질수록 줄었습니다. SWE-Bench에서는 32k의 35.7퍼센트포인트가 128k에서 2.7퍼센트포인트가 됐고, Terminal-Bench에서는 9.5에서 2.8퍼센트포인트가 됐습니다.
| 창 크기 | SWE-Bench 격차(퍼센트포인트) | Terminal-Bench 격차(퍼센트포인트) |
|---|---|---|
| 32k | 35.7 | 9.5 |
| 64k | 15.9 | 7.5 |
| 96k | 5.5 | 4.8 |
| 128k | 2.7 | 2.8 |
이 격차는 창 초과 실패와 함께 움직였습니다. T0에서 창이 넘쳐 과제를 잃는 비율은 네 모델 평균으로 SWE-Bench 78.7%에서 8.7%로, Terminal-Bench 61.0%에서 12.1%로 떨어졌습니다. 관리 단계는 모든 창에서 초과 실패가 0건이었습니다. 연구진은 컨텍스트 관리의 가치 대부분이 창이 좁을 때 실행이 중간에 끊기는 것을 막는 데서 나온다고 결론 내렸습니다. 모델별 차이도 큽니다. Nemotron-3 550B는 SWE-Bench 32k에서 T0 6.4%, T4 55.6%였고 128k에서도 T0 59.8%, T4 65.8%로 격차가 남았습니다.
단계형 T4의 비용 우위
관리 단계 사이의 정확도 차이는 작았습니다. 차이는 비용에서 났습니다. T4는 모델과 벤치마크 조합 8개 중 7개에서 비용이 가장 낮았고, 8개 조합 평균으로 네 창 크기 모두에서 과제당 평균 비용이 가장 낮았습니다. 최대 컨텍스트 사용량을 창 크기로 나눈 비율도 네 창 모두에서 T4가 가장 낮았습니다. 32k에서 T1과 T2는 창을 거의 다 채웠지만 T3과 T4는 그보다 한참 아래에 머물렀습니다. 연구진은 T4가 값싼 생략으로 먼저 공간을 확보해 비싼 요약 호출을 줄인 것을 원인으로 설명합니다.
거의 호출되지 않는 복구 기능
생략한 원문을 다시 읽을 수 있게 하는 복구(M2)는 효과가 없었습니다. T1과 T2는 복구 유무만 다른데, 32개 비교에서 T2가 15번 앞서고 14번 뒤지고 3번 같았으며 평균 차이는 0.36퍼센트포인트 감소였습니다. 복구가 들어간 64개 설정 가운데 36개(56.3%)는 recall_event를 한 번도 부르지 않았습니다. 과제당 호출 수는 32k에서 0.540회, 128k에서 0.007회였고 사용은 거의 Nemotron-3 30B에 몰렸습니다. 가장 많이 부른 설정(Nemotron-3 30B, Terminal-Bench, 32k, T2)도 과제당 4.3회 호출에 성공률은 T1보다 3.37퍼센트포인트 낮았습니다.
계획 기능의 역할 전환
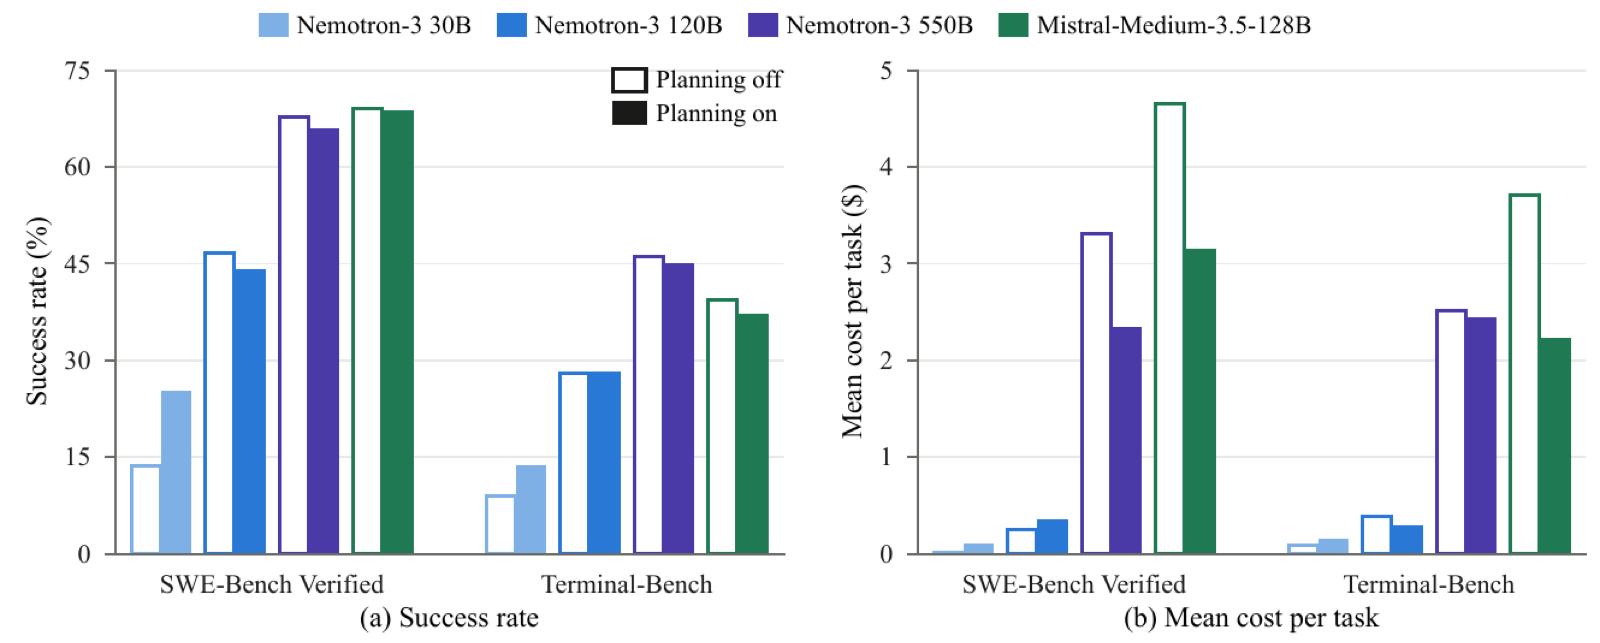
계획 기능의 효과는 모델 성능에 따라 방향이 바뀌었습니다. 비교는 T4/128k와 도구 집합 전체를 고정하고 계획만 켜고 끈 것입니다.
| 모델 | SWE-Bench 성공률 끔→켬 | SWE-Bench 비용 끔→켬 | Terminal-Bench 성공률 끔→켬 | Terminal-Bench 비용 끔→켬 |
|---|---|---|---|---|
| Nemotron-3 30B | 13.6% → 25.2% | $0.02 → $0.09 | 8.99% → 13.48% | $0.08 → $0.14 |
| Nemotron-3 120B | 46.6% → 44.0% | $0.25 → $0.34 | 28.09% → 28.09% | $0.38 → $0.28 |
| Nemotron-3 550B | 67.8% → 65.8% | $3.31 → $2.33 | 46.07% → 44.94% | $2.52 → $2.43 |
| Mistral-Medium-3.5-128B | 69.0% → 68.6% | $4.65 → $3.14 | 39.33% → 37.08% | $3.71 → $2.22 |
가장 약한 Nemotron-3 30B에서 계획은 성공률을 SWE-Bench 11.6퍼센트포인트, Terminal-Bench 4.5퍼센트포인트 올렸고 비용도 함께 늘렸습니다. SWE-Bench에서는 턴 수가 293.2%, 도구 호출이 474.0% 늘었습니다. 비용 증가율이 커 보이지만 절대 금액은 과제당 몇 센트 수준입니다. Nemotron-3 120B에서는 일관된 성공률 이득이 없었고 비용은 SWE-Bench에서 늘고 Terminal-Bench에서 약 26% 줄었습니다.
강한 두 모델에서 계획은 주로 비용을 줄였습니다. SWE-Bench 비용이 Nemotron-3 550B는 약 30%, Mistral-Medium-3.5-128B는 약 32% 줄었고 성공률은 각각 2.0, 0.4퍼센트포인트 낮아졌습니다. Terminal-Bench에서 Mistral의 비용 감소는 약 40%, Nemotron-3 550B는 3.6%였습니다. 논문 표의 통계 검정에서 유의한 차이로 표시된 것은 Nemotron-3 30B의 SWE-Bench 성공률 변화뿐입니다. 강한 모델의 소폭 하락은 유의하지 않았습니다.
도구 집합과 bash 전용 인터페이스
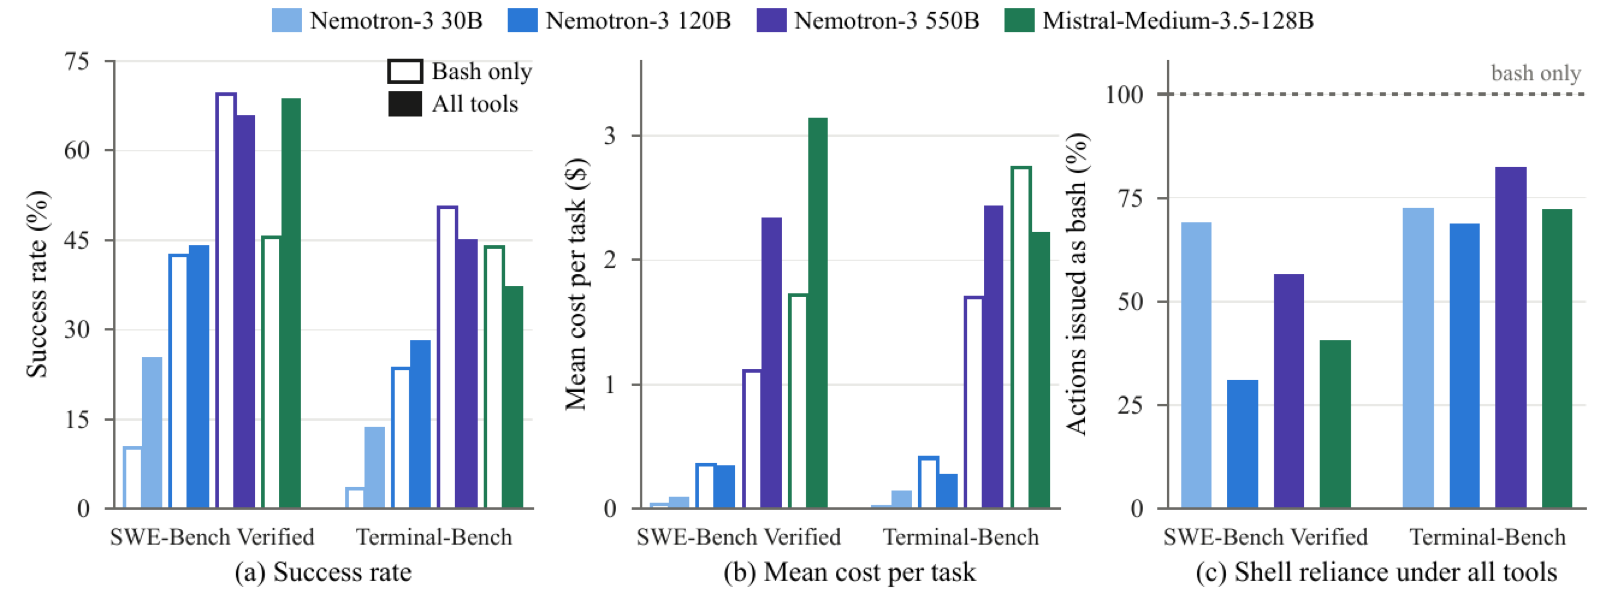
행동 공간 실험은 T4/128k에서 계획을 켠 채 미리 정의한 도구 집합과 bash 전용을 비교했습니다. 도구 집합에는 읽기 후 쓰기 검사, 파일 상태 추적, 편집 후 자동 문법 검사가 딸려 있어, 연구진은 이 결과를 인터페이스 전체의 차이로 해석하라고 밝혔습니다.
| 모델 | SWE-Bench 성공률 도구→bash | SWE-Bench 비용 도구→bash | Terminal-Bench 성공률 도구→bash | Terminal-Bench 비용 도구→bash |
|---|---|---|---|---|
| Nemotron-3 30B | 25.2% → 10.2% | $0.09 → $0.03 | 13.48% → 3.37% | $0.14 → $0.02 |
| Nemotron-3 120B | 44.0% → 42.4% | $0.34 → $0.35 | 28.09% → 23.56% | $0.28 → $0.41 |
| Nemotron-3 550B | 65.8% → 69.4% | $2.33 → $1.11 | 44.94% → 50.56% | $2.43 → $1.70 |
| Mistral-Medium-3.5-128B | 68.6% → 45.4% | $3.14 → $1.72 | 37.08% → 43.82% | $2.22 → $2.75 |
비용 변화율은 논문 표의 과제당 비용으로 계산한 값입니다. 논문 본문은 Nemotron-3 550B의 비용 감소를 SWE-Bench 53%, Terminal-Bench 30%로 적었습니다.
약한 모델의 정확도를 지탱하는 도구 집합
Nemotron-3 30B는 bash 전용에서 성공률이 SWE-Bench 15.0퍼센트포인트, Terminal-Bench 10.1퍼센트포인트 떨어졌습니다. 원인은 모델이 학습 중 익힌 도구 호출 형식을 bash 명령으로 옮기지 못한 데 있습니다. bash 전용 환경에는 그 도구가 없어 호출이 실행되지 않았고, Terminal-Bench에서 bash 전용 실행의 66%가 이런 인터페이스 밖 호출 뒤에 끝났습니다. 평균 실행 길이는 71턴에서 15턴으로 줄었습니다. 비용이 줄어든 것도 실행이 일찍 끝났기 때문입니다. Nemotron-3 120B는 도구 집합의 성공률 이득이 1.6, 4.5퍼센트포인트로 작았지만, 평균 실행이 SWE-Bench 101턴에서 77턴으로, Terminal-Bench 96턴에서 70턴으로 짧아졌습니다.
강한 모델에는 bash 전용이 더 저렴
Nemotron-3 550B는 bash 전용에서 성공률이 SWE-Bench 3.6퍼센트포인트, Terminal-Bench 5.6퍼센트포인트 올랐고 비용은 SWE-Bench에서 절반 수준, Terminal-Bench에서 약 30% 내려갔습니다. 호출 수가 SWE-Bench 32%, Terminal-Bench 24% 줄었습니다. 여러 작업을 셸 명령 하나에 묶어 실행했다는 해석입니다. 이 모델에게 도구 집합은 도구 선택과 상호작용의 부담을 더한 셈입니다.
과제 유형에 따라 뒤집힌 Mistral
Mistral-Medium-3.5-128B는 과제 유형에 따라 결과가 갈렸습니다. SWE-Bench에서는 bash 전용이 성공률을 23.2퍼센트포인트 떨어뜨렸고, Terminal-Bench에서는 6.7퍼센트포인트 올렸습니다. 도구 집합이 있을 때도 Mistral은 Terminal-Bench 작업의 71.9%를 bash로 처리했고 SWE-Bench에서는 40.4%였습니다. Terminal-Bench가 원래 셸 중심 과제라 경쟁하는 도구를 빼는 편이 모델 습관에 맞았다는 설명입니다. SWE-Bench bash 전용에서는 실행의 32.8%가 파일을 한 번도 고치지 못하고 끝났습니다. 도구 집합에서는 1.2%였습니다. Terminal-Bench의 bash 전용 이득도 비용 약 24% 증가와 함께 왔습니다.
궤적 분석에서 드러난 작동 방식
연구진은 LLM 판정기로 각 턴을 위치 찾기, 재현, 수정, 검증 같은 단계로 분류해 설정별 실행 궤적을 비교했습니다. 결과는 세 구성 요소가 서로 다른 지점에 작용한다는 것입니다.
컨텍스트 관리는 실행을 길게 늘릴 뿐 행동 순서는 거의 바꾸지 않았습니다. 32k에서 T0의 SWE-Bench 실행은 중앙값 2030턴에 멈췄고 대부분 위치 찾기 단계에서 끝났습니다. 관리 단계는 중앙값을 모델과 단계에 따라 약 50180턴으로 늘려 검증 단계까지 가게 했습니다. 128k에서는 단계 간 차이가 거의 사라졌습니다.
계획은 실행이 멈추는 지점을 바꿨습니다. Nemotron-3 30B에서 계획을 끄면 SWE-Bench 실행 중앙값이 40턴에서 5턴으로 줄었고, 편집 없이 끝난 비율이 27.8%에서 68.6%로 늘었습니다. 반대로 Nemotron-3 550B는 계획을 켜면 중앙값이 108턴에서 74턴으로, Mistral은 68턴에서 53턴으로 줄었습니다. 줄어든 부분은 대부분 편집 뒤의 반복 검증이었습니다. 계획이 위치 찾기나 수정 속도보다 종료 판단을 개선했다는 것이 연구진의 해석입니다.
행동 공간은 코드를 쓰는 단위를 바꿨습니다. bash 전용에서는 이미 고친 파일을 다시 고치는 횟수가 네 모델 모두 줄었습니다(Nemotron-3 550B 과제당 4.6회에서 1.5회). Terminal-Bench에서 파일을 통째로 만들거나 바꾸는 쓰기 비중은 Nemotron-3 550B 기준 51%에서 76%로 늘었습니다. 도구 집합은 한 번의 행동을 단순하게 만들지만 같은 작업에 더 많은 상호작용과 반복 수정이 필요하다는 뜻입니다.
연구의 한계
연구진이 직접 적은 한계는 세 가지입니다. 첫째, 각 구성 요소는 한 가지 구현만 시험했습니다. 계획은 하나의 프롬프트와 갱신 방식, 컨텍스트 관리는 고정된 임계값 정책 하나입니다. 행동 공간 비교는 도구 개수와 상태 추적, 자동 검사를 함께 바꾼 묶음 비교입니다.
둘째, 계획과 행동 공간은 T4/128k 조건에서만 시험했습니다. 다른 창 크기나 조합에서도 같은 효과가 나오는지는 전체 요인 설계가 있어야 알 수 있습니다. 설정마다 과제를 한 번씩만 실행했고 Terminal-Bench는 89개 과제뿐이라, Terminal-Bench 결론은 개별 유의성보다 모델과 창 크기에 걸친 방향의 일관성에 기대고 있습니다.
셋째, 모델은 Nemotron-3 세 크기와 Mistral-Medium-3.5-128B이고 SWE-Bench Verified는 파이썬 과제만 담고 있습니다. 모델 크기는 능력의 불완전한 대리 지표이며, 학습 중 도구 인터페이스 노출이나 셸 숙련도가 결과를 좌우할 수 있습니다. 연구진은 여기서 보고한 전환점을 다른 모델 계열, 다른 하네스, 소프트웨어 밖 과제에 옮기기 전에 검증해야 한다고 밝혔습니다. 이 연구의 강한 모델은 자체 서빙한 모델이며, 기업이 많이 쓰는 API 기반 프런티어 모델은 실험에 포함되지 않았습니다.
하네스 자동 조정과 과적합 문제
하네스 선택이 모델과 과제에 따라 달라진다면 조정을 자동화하려는 시도가 이어집니다. Google Cloud AI Research 연구진이 2026년 9월 21일 공개한 RRSI: Regularized Recursive Self-Improvement of Agent Harnesses는 그 자동화의 위험을 다룹니다. LLM이 하네스 수정안을 제안하고 점수가 오른 것을 채택하는 반복 방식은 조정에 쓴 과제에만 맞춰지는 과적합을 낳을 수 있다는 것입니다.
RRSI는 제안과 채택 양쪽에 제약을 겁니다. 제안 쪽에서는 한 후보에 묶을 수 있는 수정 수를 라운드가 지날수록 줄이고, 과거에 실패한 가설을 기록해 반복을 막고, 진전이 멈추면 아직 건드리지 않은 구성 요소 쪽으로 탐색 예산을 옮깁니다. 채택 쪽에서는 비평 모델이 과제 이름이나 정답 같은 벤치마크 특화 내용을 걸러내고, 반복 측정으로 추정한 잡음 폭 안의 개선은 받아들이지 않으며, 늘어난 비용은 점수 상승으로 정당화돼야 합니다. 최근 기여가 없는 구성 요소는 삭제 대상이 됩니다. 주 실험의 정책 모델, 제안 모델, 비평 모델은 모두 Claude Opus 4.8입니다.
| 방법 | Harvey LAB(조정용) | Harvey LAB(보류) | JobBench | GDPval | APEX-Agents |
|---|---|---|---|---|---|
| 조정 전 하네스 | 89.4 | 86.9 | 36.0 | 48.8 | 34.2 |
| Meta-Harness | 93.0 | 89.2 | 37.1 | 49.1 | 35.7 |
| AHE | 90.7 | 88.7 | 37.2 | 47.2 | 33.1 |
| TTHE | 91.1 | 88.5 | 35.2 | 47.0 | 31.7 |
| HarnessX | 91.8 | 89.1 | 36.3 | 48.5 | 34.3 |
| RRSI | 90.5 | 89.2 | 40.7 | 52.3 | 37.9 |
기존 네 방법은 조정에 쓴 법률 업무 벤치마크에서 모두 점수를 올렸지만, 처음 보는 세 벤치마크 평균에서는 Meta-Harness가 0.9점 올린 것이 최대였고 AHE와 TTHE는 조정 전보다 낮아졌습니다. RRSI는 조정용 점수 상승이 가장 작은 대신 분포 밖 평균을 39.7에서 43.6으로 올렸습니다. 두 제약을 모두 뺀 조정은 조정용 점수를 92.8까지 올렸지만 분포 밖 평균은 40.3에 그쳤고, 시행당 정책 토큰은 380만 개로 RRSI의 242만 개보다 많았습니다. 초록은 이 차이를 30% 절감으로 요약했습니다.
코딩 영역에서는 Terminal-Bench 2.1로만 조정한 하네스를 SWE-Bench Verified에 그대로 적용했습니다. Gemini 3.5 Flash에서 Terminal-Bench는 64.6에서 78.7로 14.1점 올랐고 SWE-Bench는 2.2점 올랐습니다. Claude Opus 4.8에서는 각각 6.0점과 1.8점이었습니다. Gemini 3.5 Flash로 조정한 하네스를 조정에 쓰지 않은 Gemini 3.1 Flash Lite에 적용하자 Terminal-Bench가 11.2에서 14.6으로 올랐습니다. 조정 전 하네스가 시행당 156만 토큰으로 가장 가벼웠다는 점도 연구진은 함께 밝혔습니다. 조정으로 얻은 개선의 일부는 추가 연산으로 산 것입니다.
두 논문을 함께 보면 하네스 설정에 정답 하나가 없다는 점, 그리고 설정을 자동으로 찾을 때도 조정에 쓴 과제 밖에서 다시 검증해야 한다는 점이 분명해집니다.
우리나라 기업이 확인할 것
아래는 두 논문의 결과에 대한 코텍시스의 해석입니다. 논문은 특정 모델과 벤치마크 조건의 결과이므로 자사 환경에서 검증하는 것을 전제로 합니다.
첫째, 하네스 설정을 도입 모델별로 따로 평가하는 것이 좋습니다. 같은 계획 기능이 약한 모델에는 성공률을 11.6퍼센트포인트 올렸고 강한 모델에는 비용을 약 30% 줄였습니다. 모델을 교체할 때는 내부 과제 수십 건으로 성공률과 과제당 비용을 함께 다시 재는 절차를 두는 것이 안전하다고 봅니다.
둘째, 컨텍스트 창이 좁은 모델이나 긴 작업이라면 컨텍스트 관리부터 켜는 것이 우선입니다. 32k 창에서 관리 유무의 격차는 SWE-Bench 기준 35.7퍼센트포인트였습니다. 방식은 오래된 도구 출력을 먼저 생략하고 필요할 때만 요약하는 단계형이 비용 면에서 유리했고, 생략한 원문을 다시 읽는 복구 기능은 성과가 없었습니다. 복잡한 기억 장치를 먼저 만들기보다 단순한 생략 규칙을 먼저 적용해 보는 순서를 권합니다.
셋째, bash만 주는 구성은 모델의 셸 숙련도와 과제 유형을 확인한 뒤 결정해야 합니다. 강한 모델에서는 비용이 SWE-Bench에서 절반, Terminal-Bench에서 약 30% 줄었지만, 다른 계열의 비슷한 급 모델은 저장소 수정 과제에서 성공률이 23.2퍼센트포인트 떨어졌습니다. 권한 통제 관점에서도 미리 정의한 도구는 읽기 후 쓰기 검사와 경로 제한을 걸기 쉽습니다. 비용만 보고 도구를 걷어내기 전에 보안 요건을 함께 따져야 합니다.
넷째, 이 연구의 모델은 연구진이 직접 실행한 Nemotron-3와 Mistral 모델이며 Claude나 GPT 같은 모델은 포함되지 않았습니다. 연구진도 전환점을 다른 모델 계열에 옮기기 전에 검증하라고 적었습니다. 상용 코딩 에이전트 제품을 쓰는 조직이라면 결론을 설정값으로 옮기기보다, 계획 사용 여부와 도구 구성을 바꿔 가며 비교할 평가 항목의 목록으로 쓰는 편이 맞습니다.
다섯째, 하네스를 자동으로 조정하거나 프롬프트를 반복 개선한다면 조정에 쓰지 않은 평가 세트를 따로 두어야 합니다. RRSI 실험에서 기존 방법들은 조정용 점수를 올리고도 처음 보는 과제에서는 조정 전보다 나빠지기도 했습니다. 개선 폭이 반복 측정의 잡음 폭보다 큰지, 늘어난 토큰 비용만큼 성과가 오르는지를 채택 기준에 넣는 것을 권합니다.
출처: An Empirical Study of Harness Design for Coding Agents, RRSI: Regularized Recursive Self-Improvement of Agent Harnesses
코텍시스 창업자로 AX 컨설팅과 기업 AI 교육, AI 에이전트 개발을 직접 수행합니다.
코텍시스 AI 인사이트 최신 논문 리뷰
AWQ 양자화: 활성값을 보고 가중치를 지키는 4비트 양자화
MIT 연구진의 AWQ는 활성값 분포를 기준으로 중요한 가중치 1%만 보호해도 저비트 양자화 오류가 크게 줄어든다는 관찰에서 출발해 재학습 없는 4비트 양자화를 구현했고 전용 커널 TinyChat으로 FP16 대비 3배 이상의 추론 속도를 달성했습니다. 온프레미스 sLLM을 소수의 GPU로 서빙해야 하는 기업에게 정확도 손실 없이 메모리와 비용을 동시에 줄이는 사실상의 표준 기법입니다.
Mixtral 8x7B로 읽는 MoE 아키텍처: 13B의 연산으로 70B급 성능 내기
총 47B 파라미터 중 토큰당 13B만 활성화하는 희소 MoE 모델 Mixtral 8x7B는 Llama 2 70B와 GPT-3.5를 대부분의 벤치마크에서 따라잡거나 능가했습니다. 추론 연산량은 소형 모델 수준으로 유지하면서 품질을 끌어올리는 MoE의 실용성을 입증한 사례로, 기업의 자체 호스팅 모델 선정 기준에 직접 영향을 줍니다.
DPO가 바꾼 선호 정렬 학습: 보상 모델 없이 RLHF를 대체하는 방법
DPO는 보상 모델의 재매개변수화를 통해 최적 정책을 닫힌 형태로 유도하고, 선호 데이터에 대한 단순 분류 손실만으로 RLHF와 같은 목적을 달성하는 기법입니다. 강화학습 파이프라인을 운영할 여력이 없는 기업 프로젝트에서 선호 정렬을 현실적인 작업 범위로 만들어 준 논문입니다.
AI 솔루션이 필요하신가요?
cortexys.team에서 맞춤 AI 개발 서비스를 확인하세요.