Google Antigravity의 멀티에이전트 프레임워크 Teamwork가 Gemini 3.7 Flash로 미해결 수학 문제 7개와 RISC-V 시뮬레이터, Eigen 최적화를 해냈다. 패턴 구조와 Long Proof 설계, 구축 시 판단 기준을 정리한다.
Google이 2026년 8월 31일 Pairing Google Antigravity with Gemini 3.7 Flash solves notable multi-agent math and engineering problems.를 게시했습니다. 상세 내용은 Antigravity 블로그의 Teamwork: When AI Becomes a Research Partner(8월 27일)에 있습니다. 코텍시스는 이 글을 개발·구축 관점에서 읽습니다. Flash급 모델을 오케스트레이션으로 묶어 Pro급 결과를 냈다는 것이 핵심이고, 이는 에이전트 시스템에서 모델 크기보다 루프 구조에 먼저 투자하라는 근거가 됩니다.
결과 요약
- 수학·이론 전산학: FOCS와 JMLR에 실린 미해결 문제를 포함해 7개를 풀었습니다. Knuth의 Cycles Conjecture는 40쪽이 넘는 증명을 Lean으로 형식 검증했습니다. 이 가운데 3개는 Gemini 3.7 Flash로 재현됐습니다.
- 시스템: 사이클 정확도를 갖춘 비순차(OoO) RISC-V CPU 시뮬레이터를 처음부터 만들어 xv6를 셸까지 부팅했고, BOOM 하드웨어 대비 사이클 오차가 0.71%입니다.
- 오픈소스: Eigen의 GeMV에 SIMD 고속 경로를 넣어 업스트림에 머지됐고, ParlayHash는 64스레드 삽입 처리량 2배와 원소당 메모리 25% 절감을 얻었습니다.
| 구성 | TCSBench |
|---|---|
| Gemini 3.6 Flash + 3.1 Pro (TCSBench 논문) | 67.7% |
| Gemini 3.7 Flash + 3.1 Pro (Teamwork Long Proof) | 71% |
Teamwork의 구조
Teamwork는 여러 패턴의 집합입니다. 패턴은 어떤 에이전트가 어떤 역할로 참여하고 어떤 기준을 통과해야 다음 단계로 가는지를 적은 명세이며 오케스트레이션 코드를 담지 않습니다. 프레임워크가 명세를 읽어 에이전트 수를 실행 중에 정합니다. 현재 Iterative Coding, Distributed Coding, Long Proof, Self-Verification, Document Review 다섯 패턴이 있고 유료 플랜의 /teamwork-preview에서 프롬프트에 맞춰 자동 선택됩니다.
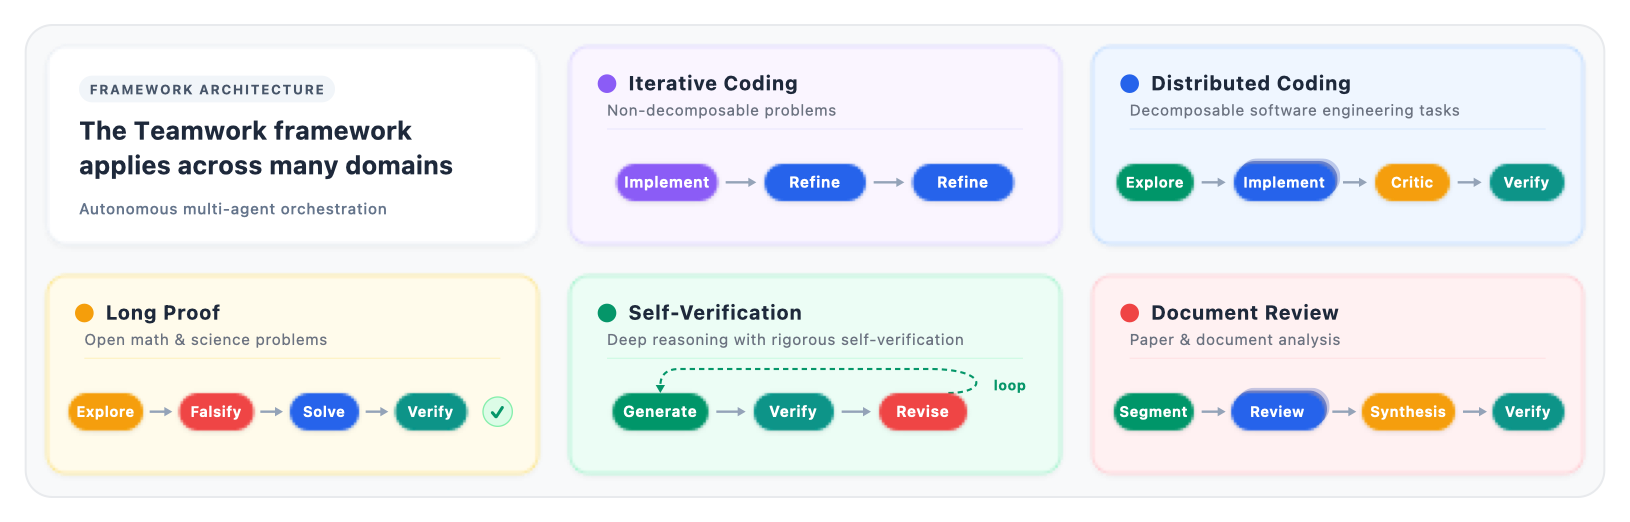 출처: Google Antigravity, Teamwork: When AI Becomes a Research Partner
Long Proof 패턴이 다른 점
전략 후보를 병렬로 만들고 후보마다 반증자(falsifier)를 붙여 깨뜨리게 합니다. 반박된 경로도 반박 사유와 함께 남깁니다. 선택된 전략은 의존성 그래프를 가진 하위 문제로 쪼개져 독립 문제는 병렬로 풉니다. 실패한 초안과 검증자의 발견은 pitfall registry에 쌓여 다음 시도에 쓰입니다.
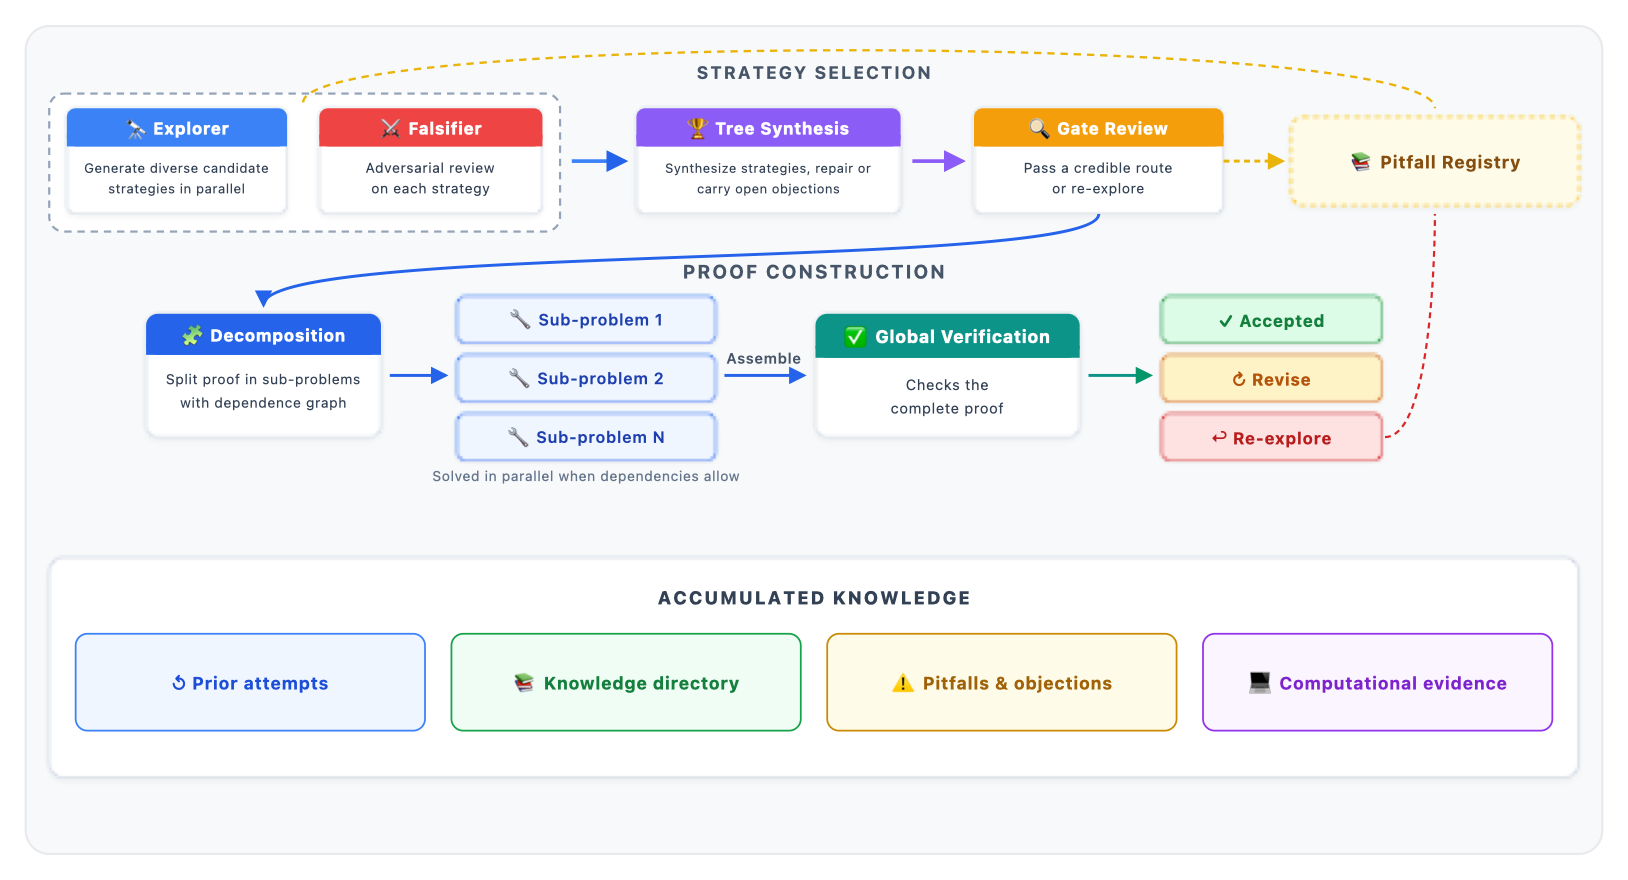 출처: Google Antigravity, Teamwork: When AI Becomes a Research Partner
구축 시 판단 기준
- 비용 배분: Flash로 반복 횟수를 사고 Pro는 병목 단계에만 씁니다. Flash와 Pro를 한 패턴 안에서 섞는 기능은 곧 제공됩니다.
- 반증 역할의 분리: 초기 실수에 동조해 쌓아 올리는 문제를 막는 가장 싼 장치가 별도 반증 에이전트입니다.
- 사람의 자리: 목표 설정과 최종 수용은 사람이 맡습니다.
- 재현 조건: 일부 결과는 기본값보다 높은 병렬도로 얻었습니다. 제품 버전은 비용과 성능의 균형점에 맞춰져 있습니다.
원문은 Google 블로그와 Antigravity 블로그에서 볼 수 있습니다.
코텍시스 창업자로 AX 컨설팅과 기업 AI 교육, AI 에이전트 개발을 직접 수행합니다.
코텍시스 AI 인사이트 최신 논문 리뷰
AWQ 양자화: 활성값을 보고 가중치를 지키는 4비트 양자화
MIT 연구진의 AWQ는 활성값 분포를 기준으로 중요한 가중치 1%만 보호해도 저비트 양자화 오류가 크게 줄어든다는 관찰에서 출발해 재학습 없는 4비트 양자화를 구현했고 전용 커널 TinyChat으로 FP16 대비 3배 이상의 추론 속도를 달성했습니다. 온프레미스 sLLM을 소수의 GPU로 서빙해야 하는 기업에게 정확도 손실 없이 메모리와 비용을 동시에 줄이는 사실상의 표준 기법입니다.
Mixtral 8x7B로 읽는 MoE 아키텍처: 13B의 연산으로 70B급 성능 내기
총 47B 파라미터 중 토큰당 13B만 활성화하는 희소 MoE 모델 Mixtral 8x7B는 Llama 2 70B와 GPT-3.5를 대부분의 벤치마크에서 따라잡거나 능가했습니다. 추론 연산량은 소형 모델 수준으로 유지하면서 품질을 끌어올리는 MoE의 실용성을 입증한 사례로, 기업의 자체 호스팅 모델 선정 기준에 직접 영향을 줍니다.
DPO가 바꾼 선호 정렬 학습: 보상 모델 없이 RLHF를 대체하는 방법
DPO는 보상 모델의 재매개변수화를 통해 최적 정책을 닫힌 형태로 유도하고, 선호 데이터에 대한 단순 분류 손실만으로 RLHF와 같은 목적을 달성하는 기법입니다. 강화학습 파이프라인을 운영할 여력이 없는 기업 프로젝트에서 선호 정렬을 현실적인 작업 범위로 만들어 준 논문입니다.
AI 솔루션이 필요하신가요?
cortexys.team에서 맞춤 AI 개발 서비스를 확인하세요.