LLM·RAG·AI 에이전트의 작동 방식과 새로 나온 모델·논문을 직접 확인한 내용을 정리합니다.
글 1편
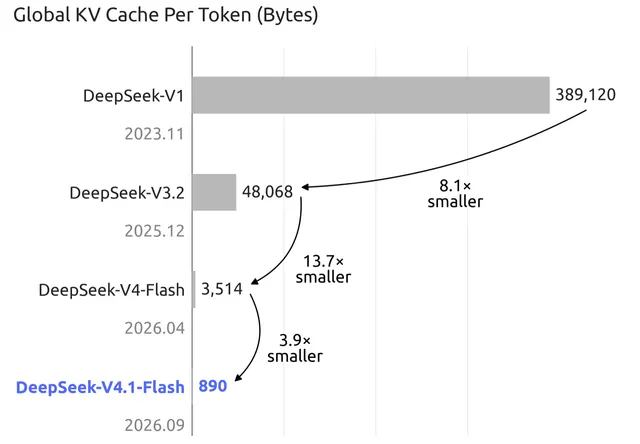
DeepSeek-V4.1-Flash는 토큰당 전역 KV 캐시를 890바이트로 줄여 100만 토큰 문맥의 서빙 비용을 낮췄습니다. 구조 변화와 벤치마크, MIT 라이선스, 자체 호스팅 전 검증 항목을 정리합니다.