

LLM 글 목록
코텍시스 기술 블로그에서 LLM 태그가 붙은 글 6편을 모았습니다. 기업 AI 도입과 AX 현장에서 확인한 내용을 정리합니다.
글 6편
[모델] 같은 가격에 코딩을 끌어올린 Gemini 3.8 Flash
구글이 3.7 Flash와 같은 가격에 코딩·추론 성능을 올린 Gemini 3.8 Flash와 보안 특화 Flash Cyber를 내놓았습니다. 벤치마크 수치와 2027년 정식 가격, 코딩 에이전트 백엔드를 Flash급으로 내릴 때의 판단 기준을 정리했습니다.
[모델] 플래그십 성능을 절반 가격에 제공하는 Claude Opus 5
7월 24일 출시된 Claude Opus 5는 상위 모델 Fable 5와 대등한 성능을 절반 가격에 제공한다. ARC-AGI 3에서 전작의 20배인 30.2%를 기록했고 100만 토큰 컨텍스트를 기본 지원한다.
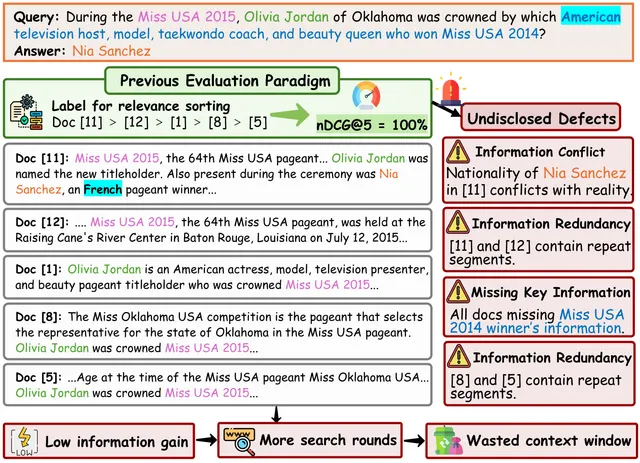
[논문] 문서 세트 품질로 다시 보는 RAG 검색 평가
USTC와 Tencent Yuanbao 팀이 RAG 검색 평가를 개별 문서의 관련성이 아닌 문서 세트 품질로 재정의했다. 최신 리랭커 12종이 세트 차원에서 낙제한 반면 세트 단위 선택은 평균 2.66개 문서만으로 EM을 7.47점 높였다.
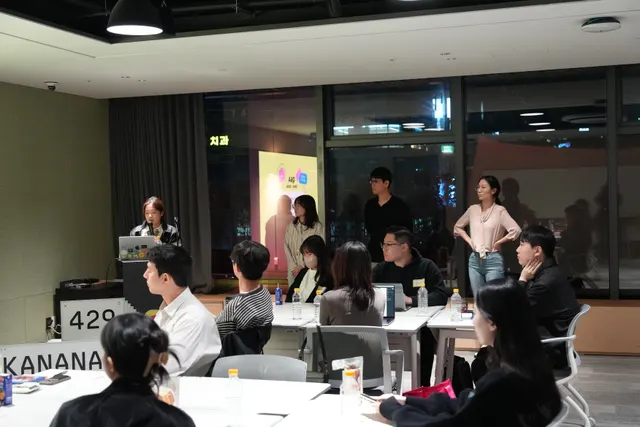
[KANANA429] AI Safety와 국내 최초 오픈소스 가드레일 Kanana Safeguard
카카오가 공개한 국내 최초 오픈소스 AI 가드레일 Kanana Safeguard의 기술 구조를 Kanana 429 앰배서더 밋업 현장에서 직접 들은 내용으로 정리합니다. 세 가지 모델 구성과 단일 토큰 분류 방식과 한국어 특화 데이터셋 그리고 카카오의 AI Safety 철학을 다룹니다.
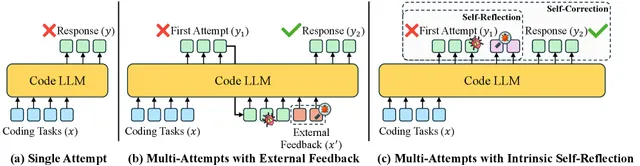
[논문] 컴파일러 없이 스스로 코드를 고치는 ReflexiCoder
강화학습으로 외부 도구 없이 스스로 코드를 반성하고 수정하는 ReflexiCoder를 분석합니다. 8B 파라미터로 GPT-5.1과 경쟁하며 반성 과정이 오히려 토큰 사용량을 36% 줄이는 역설적인 결과까지 살펴봅니다.
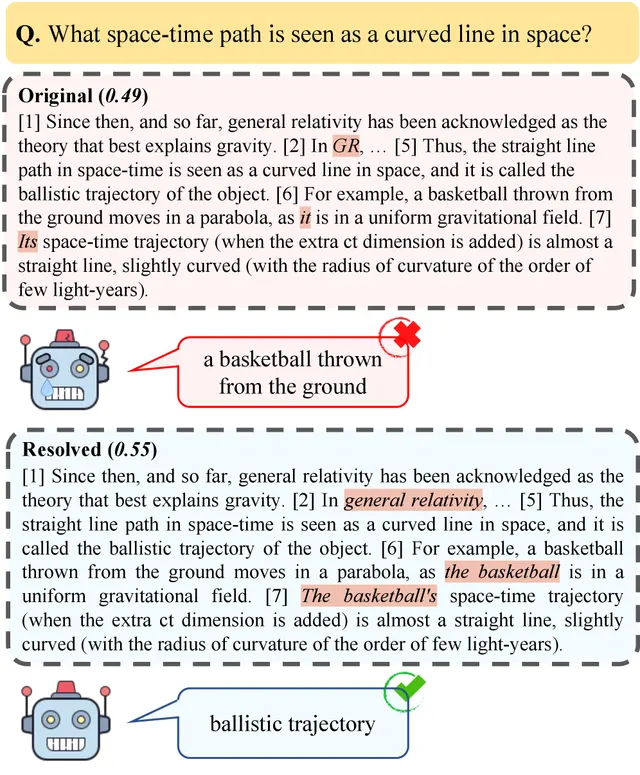
[논문] 코리퍼런스 해소로 RAG 검색 정확도를 높이는 법
RAG 시스템에서 대명사와 지시사로 인한 참조 모호성이 검색과 생성 품질을 떨어뜨린다. 8개 임베딩 모델과 7개 LLM과 4개 데이터셋 실험으로 공지시 해소가 Mean pooling 모델의 검색 성능을 높이고 Qwen2.5-7B의 SQuAD F1을 0.40에서 0.80으로 두 배 끌어올림을 보인다.